


让 Diffusers 原生运行 Nunchaku 4 位量化扩散模型
大型扩散 Transformer 的 BF16 权重通常需要约 20–30 GB 显存。常见权重量化能显著缩小模型,但推理时还要把低精度权重还原到较高精度,因而未必更快。SVDQuant 的不同之处在于同时以 4 位表示权重和激活(W4A4),并用一个小型 16 位低秩分支补偿最难量化的部分,目标是在减少显存的同时加快去噪循环。
从 SVDQuant 到 Nunchaku Lite
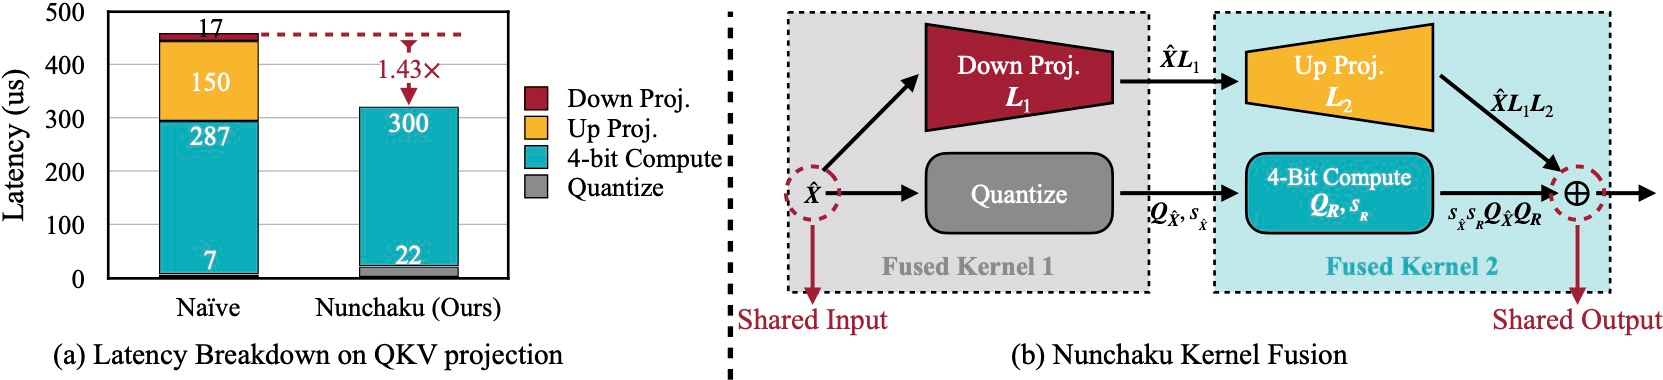
SVDQuant 把激活中的离群值转移到权重表示中,以低秩分支处理难以量化的部分,再将其余残差压到 4 位。Nunchaku 将低秩投影与量化及 4 位矩阵乘内核融合,减少独立 16 位分支带来的内存访问。传统 Nunchaku 引擎还针对模型结构使用融合 QKV、GELU/MLP 等专用执行路径;这些优化依赖特定架构和检查点布局。
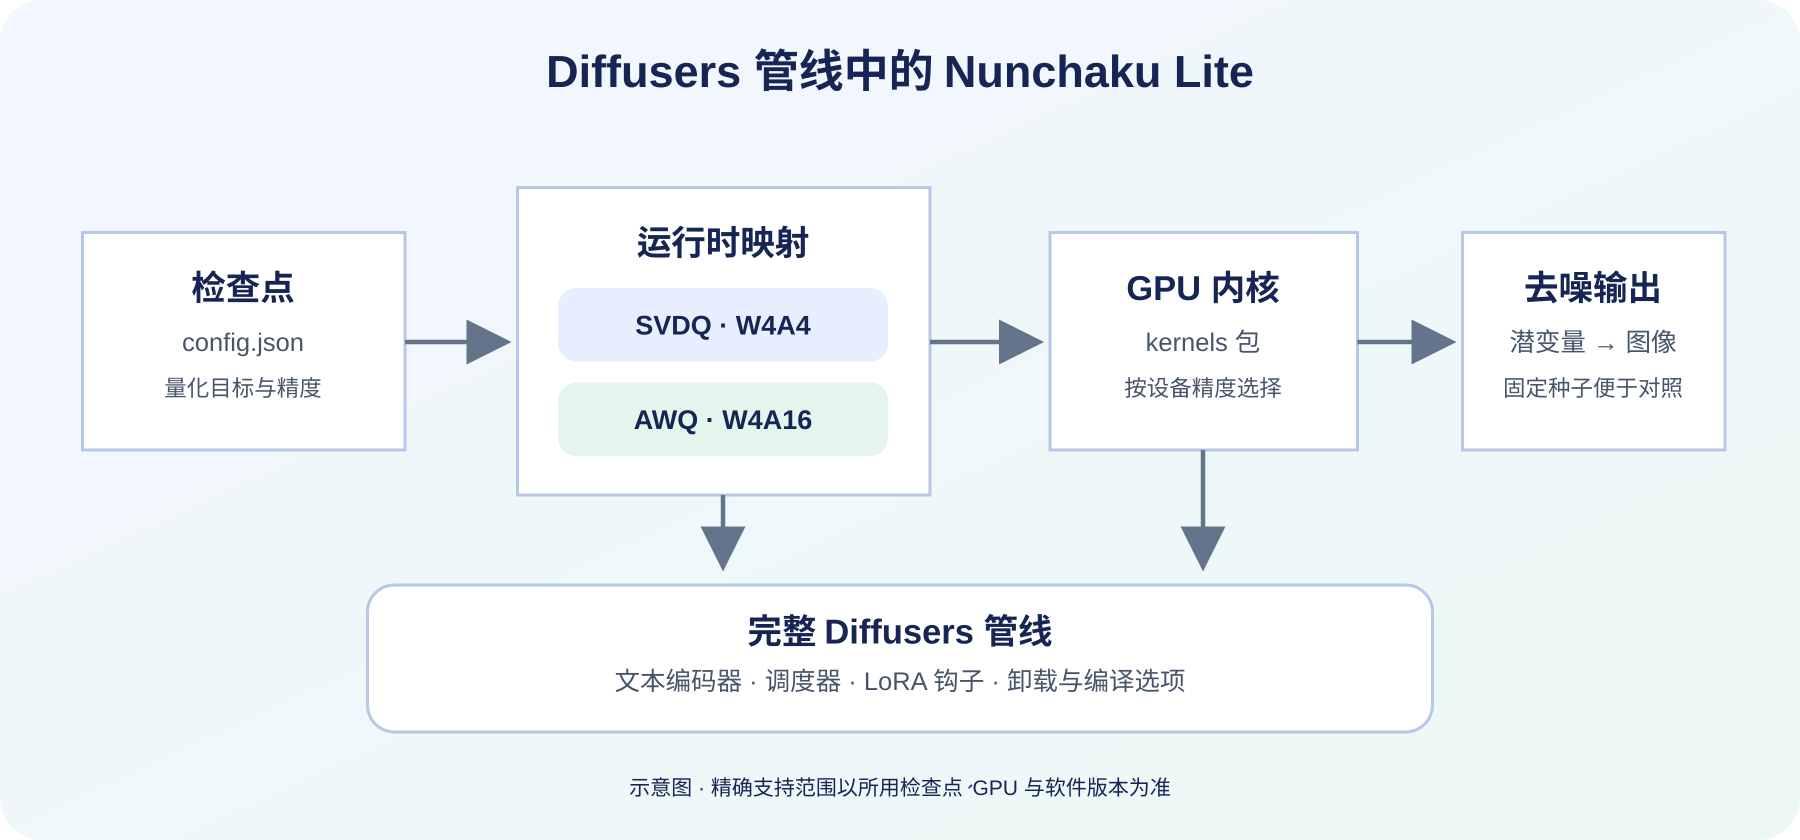
Nunchaku Lite 提供了另一条集成路径:Diffusers 在加载检查点前,把普通模型中的部分 nn.Linear 模块替换为运行时量化层,内核由 kernels 包按需获取。它分为两类:svdq_w4a4 用于 Transformer 注意力和 MLP 的权重/激活 4 位计算,并带低秩修正;awq_w4a16 则用于调制和自适应归一化等对精度敏感、偏内存瓶颈的投影,以 4 位权重配 16 位激活。由于 Lite 没有原引擎全部架构专用融合算子,文章报告的速度提升约为 30%,显存节省仍与原路径相当。
直接载入预量化管线
原文给出的安装命令会升级当前环境中的软件包,且没有锁定版本:
pip install -U diffusers transformers accelerate kernels bitsandbytes建议先在隔离环境核对兼容版本、依赖来源和模型许可。对已准备好的检查点,原文称 Diffusers 可直接载入,无须在本机编译 CUDA;首次使用 NVFP4 时,kernels 会从 Hugging Face Hub 获取相应内核。这个说明不表示自行校准和量化不需要 CUDA 或额外组件。
当前安全边界(Diffusers 文档,2026-10-08 核验):Nunchaku Lite 文档指出,内核来自 Hub 的 rootonchair/nunchaku-lite-kernels,发布者不在受信任内核发布者列表内;加载会下载并在本机执行代码。当前 Diffusers 默认阻止这类内核,只有显式设置 DIFFUSERS_TRUST_REMOTE_KERNELS=true 才会允许。该设置授予下载代码在本机运行的能力;只有先检查并固定内核仓库版本、确认代码来源后才考虑启用,并在隔离环境中评估。未在当前文档确认这种安全边界之前,不要把“自动下载”理解成可无审查加载。
当前文档还指出,Blackwell 上使用 NVFP4 需要 PyTorch 2.7 或更高版本及 CUDA 12.8 或更高版本;这属于截至 2026-10-08 的要求,环境兼容性仍应以选定 Diffusers/内核版本的官方说明为准。
量化仓库仍是普通 Diffusers 仓库。Transformer 的 config.json 中增加 quantization_config,声明量化方法、计算精度、量化方案、分组大小、秩和目标模块。调用 from_pretrained() 即可使用,不需要自定义 pipeline 类或单独推理引擎。以下是原文所示配置形状,省略号表示其余目标层:
"quantization_config": {
  "quant_method": "nunchaku_lite",
  "compute_dtype": "bfloat16",
  "svdq_w4a4": {
    "precision": "nvfp4",
    "group_size": 16,
    "rank": 32,
    "targets": ["layers.0.self_attention.to_q", "layers.0.self_attention.to_k", "..."]
  },
  "awq_w4a16": {
    "precision": "int4",
    "group_size": 64,
    "targets": ["adaLN_modulation.1", "..."]
  }
}
这份配置告诉 Diffusers 哪些层经过量化以及要实例化哪一种运行时层(SVDQW4A4Linear 或 AWQW4A16Linear)。量化模型保持原有模块结构,因此调度器、LoRA 加载钩子、卸载与 torch.compile 等仍面对普通 Diffusers 模型。
import torch
from diffusers import ErnieImagePipeline

pipe = ErnieImagePipeline.from_pretrained(
    "lite-infer/ERNIE-Image-Turbo-nunchaku-lite-nvfp4_r32-bnb4-text-encoder",
    torch_dtype=torch.bfloat16,
).to("cuda")

image = pipe(
    prompt="A cinematic portrait of a red fox in a misty forest at sunrise, "
        "detailed fur, volumetric light",
    height=1024,
    width=1024,
    num_inference_steps=8,
    guidance_scale=1.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("output.png")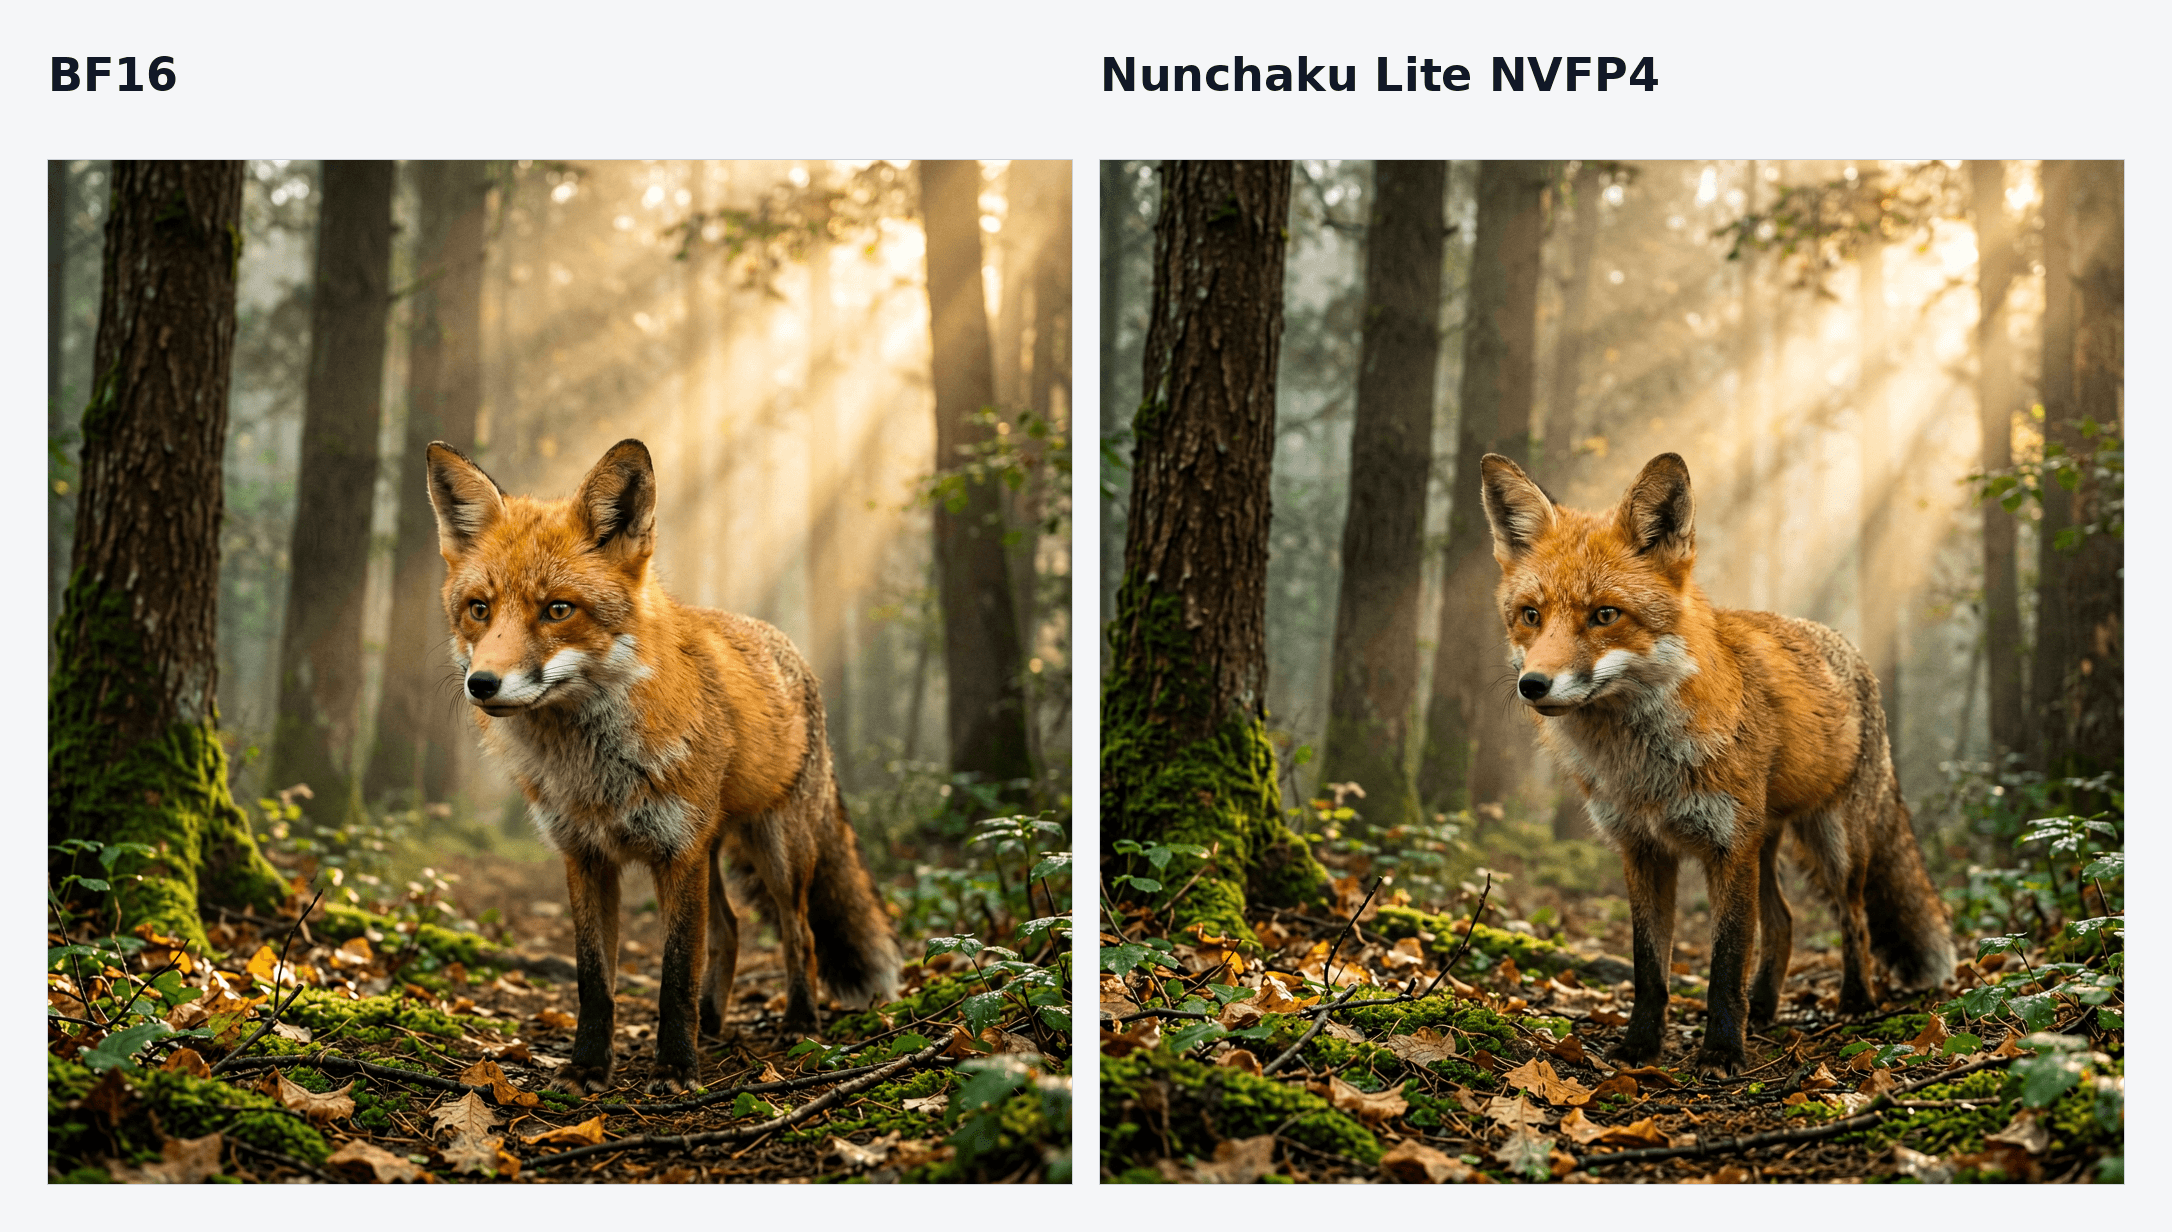
示例检查点把 Nunchaku NVFP4 Transformer 与 bitsandbytes NF4 文本编码器组合在一起。原文在 RTX 5090 上报告 1024×1024 生成约 1.7 秒、峰值约 12 GB;这属于该检查点及硬件的示例,不是通用性能承诺。NVFP4 内核要求 NVIDIA Blackwell(RTX 50 系列、RTX PRO 6000、B200)。INT4 路径列出的支持范围为 Turing、Ampere、Ada(例如 RTX 30/40 系列、A100、L40S);原文明确称 Volta 与 Hopper 当前不支持这些 4 位内核。载入时会检查 GPU CUDA 能力。
还能叠加的内存和速度优化
原文称,对 Transformer 使用 torch.compile 可把端到端速度提升从 1.35 倍提高到 1.8 倍,并给出两种编译写法:
pipe.transformer.compile(fullgraph=True)

# 或使用 compile_repeated_blocks() 以缩短编译时间
pipe.transformer.compile_repeated_blocks(fullgraph=True)
文本编码器也会占用数 GB 显存。原文测试用 bitsandbytes NF4 进一步量化文本编码器,使峰值显存再降约 22%。在显存受限设备上,可搭配 Diffusers 的 enable_model_cpu_offload() 或 enable_sequential_cpu_offload()。编译和卸载可能影响启动时间、吞吐、画质与延迟,需按目标设备测量。
作者的基准结果
以下全部数字是在 NVIDIA RTX PRO 6000(Blackwell)上,以 1024×1024 分辨率、指定的 ERNIE-Image-Turbo Nunchaku Lite INT4/BnB4 检查点测得;原文表中列的是 NVFP4 运行路径。此表是作者实验记录,不是本稿复测。原文句子列出的检查点名带有 int4 后缀,而表格的量化配置却标为 NVFP4;现有来源不足以判断这是仓库名称沿用还是标签错误,本文保留此处源文不一致,不自行推测。
| 配置 | 完整管线 | 去噪循环 | 峰值显存 | 相对速度 |
|---|---|---|---|---|
| BF16 基线 | 3.00 秒 | 2.86 秒 | 31.1 GB | 1.0 倍 |
| Nunchaku Lite NVFP4 | 2.27 秒 | 2.13 秒 | 20.6 GB | 1.35 倍 |
NVFP4 + torch.compile |
1.68 秒 | 1.53 秒 | 20.6 GB | 1.8 倍 |
| NVFP4 + NF4 文本编码器 | 2.29 秒 | 2.13 秒 | 16.0 GB | 1.35 倍 |
原文据此报告峰值显存最多降低约 50%,同时延迟改善约 30%;编译 Transformer 后,完整管线用时约 1.68 秒。剩余开销主要来自额外内核启动,torch.compile 可缓解其中一部分。不要把这些数字推广到未列出的 GPU、模型或参数组合。
图像质量对照
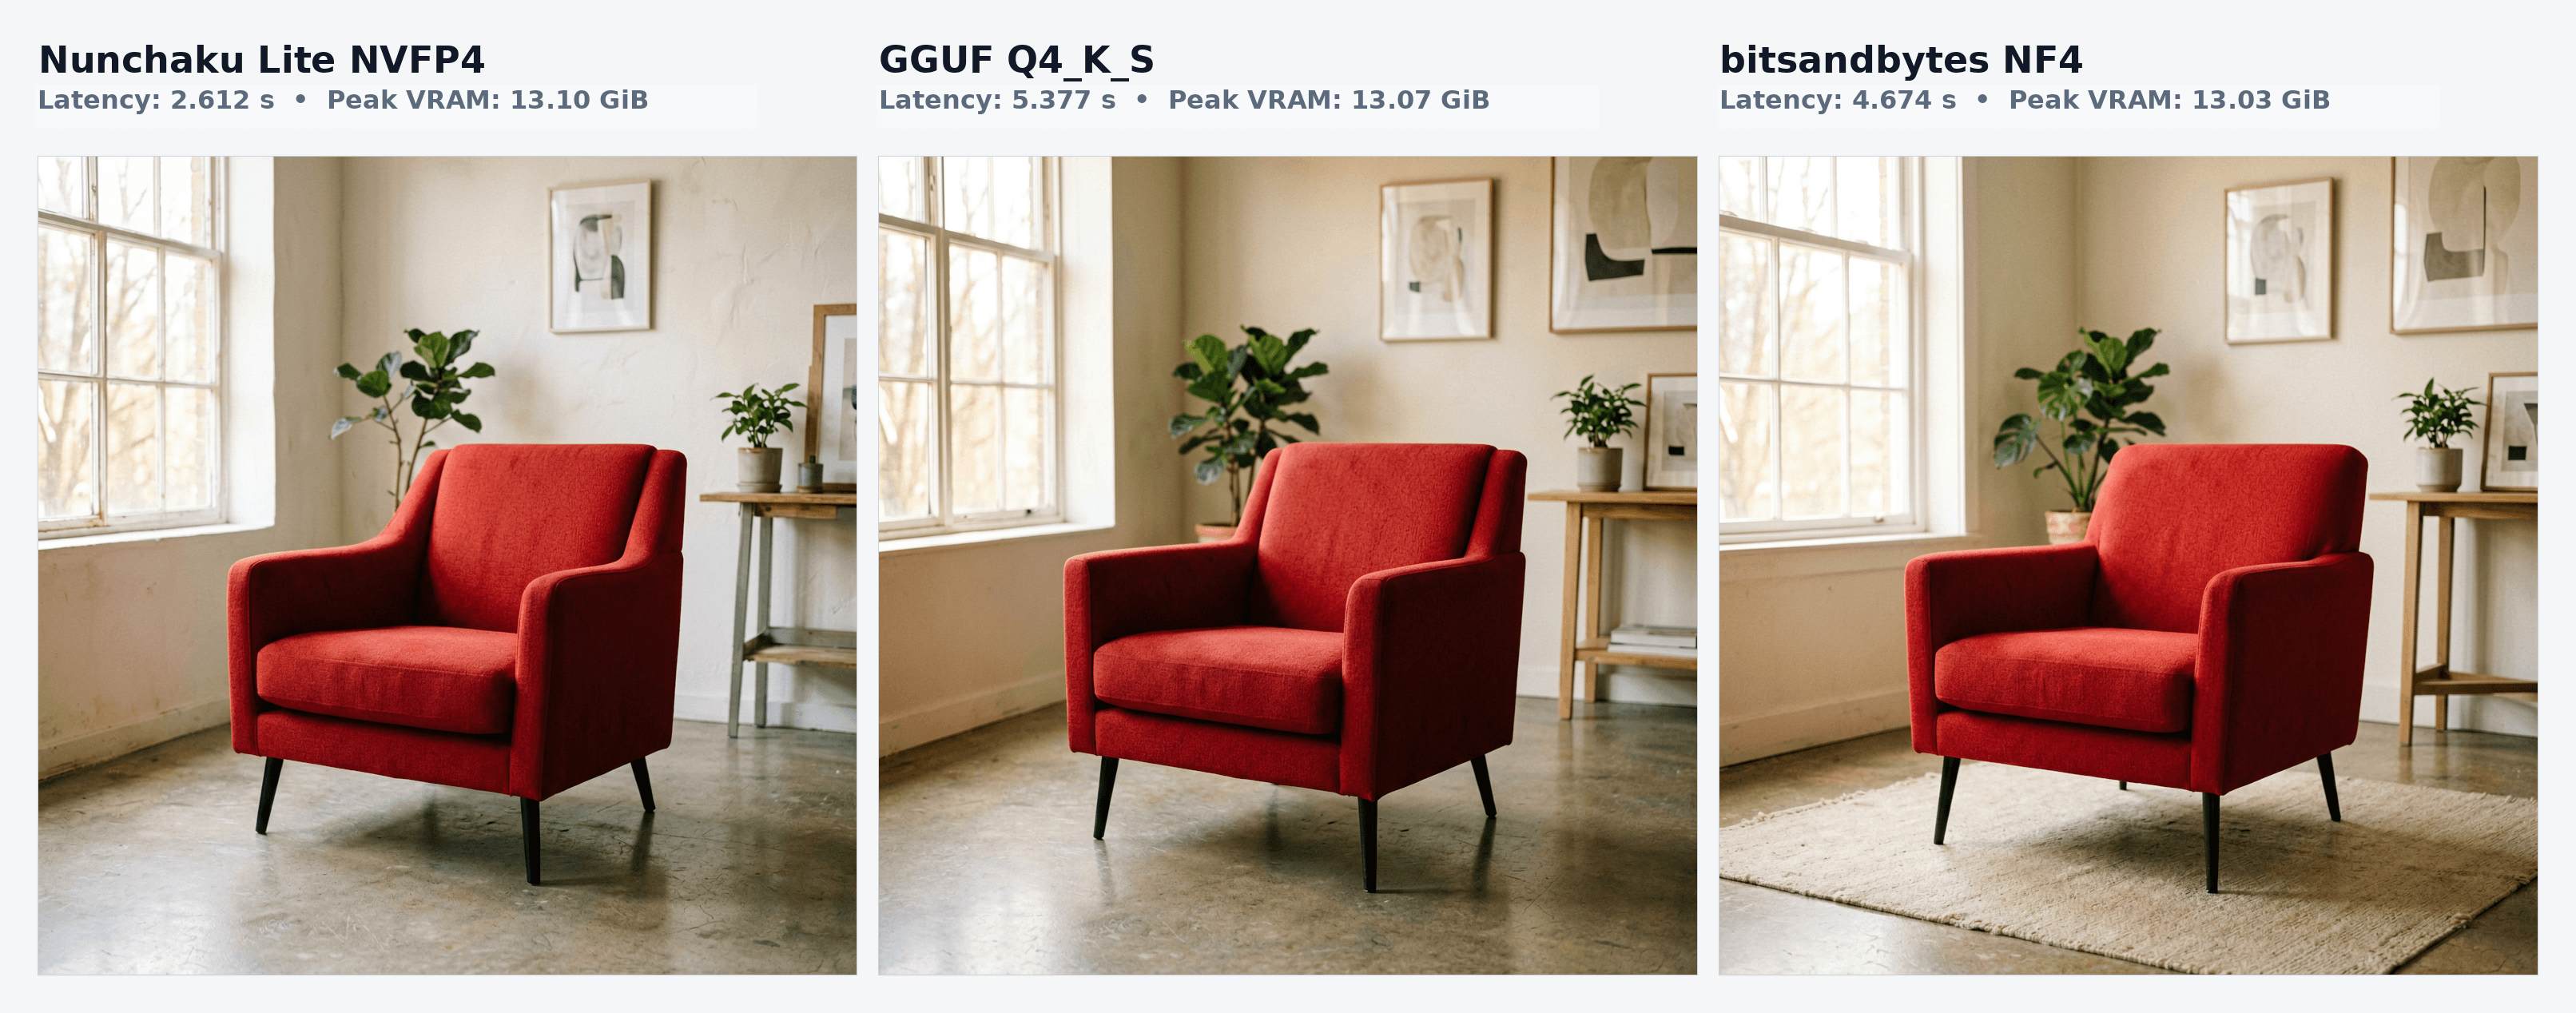
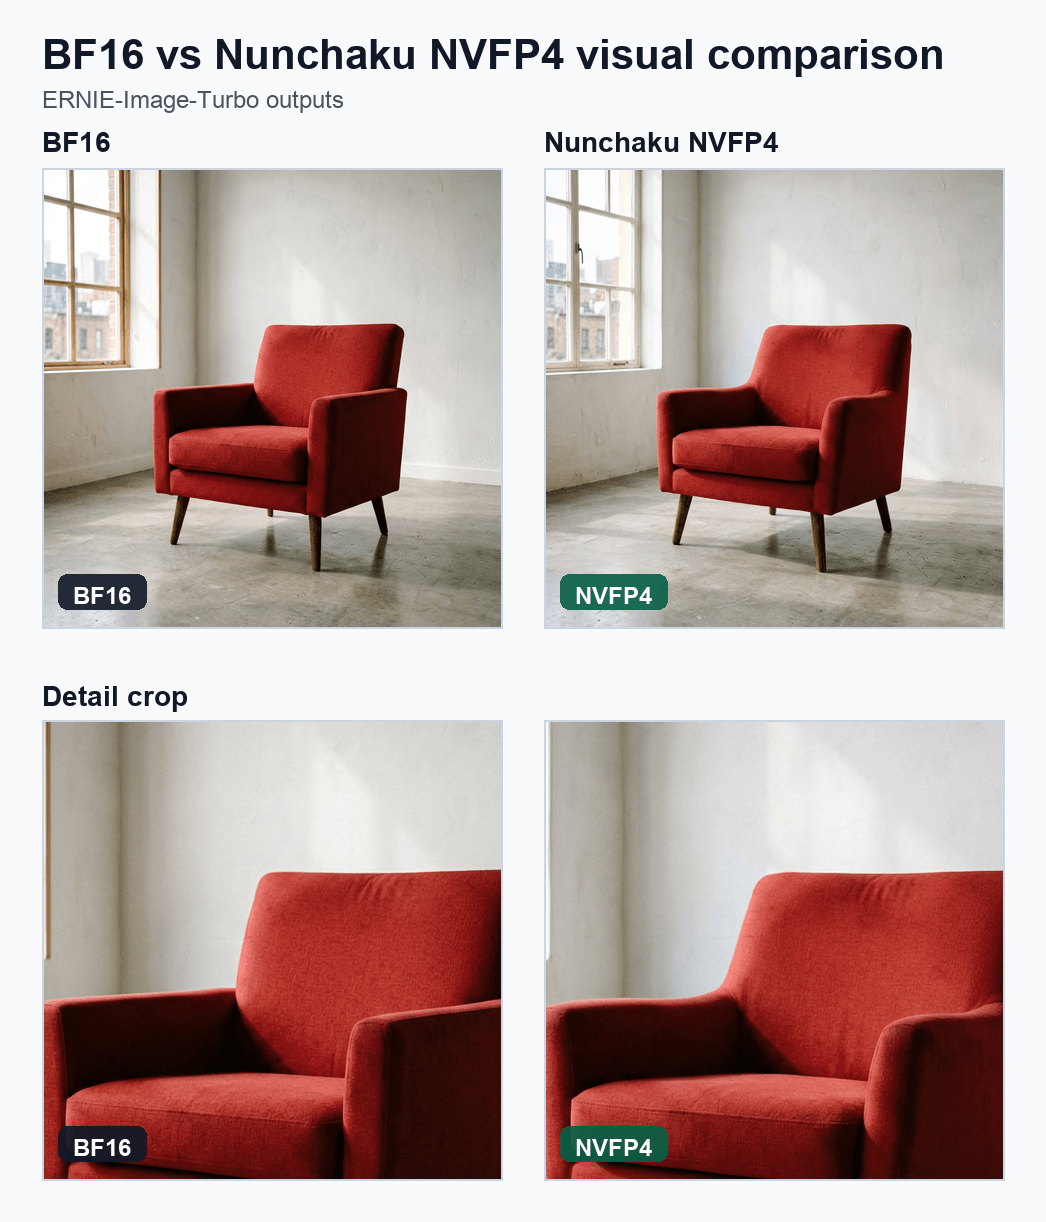
原文图注说明 BF16 与 4 位结果采用相同随机种子和设置。图中包含完整场景与细节裁切;这是作者的视觉比较,不是独立盲评或定量图像质量测试。
自行量化:先检查,再生成检查点
diffuse-compressor 提供从校准、量化到打包的流程。通用扫描器会把重复 Transformer 块中兼容的线性层列为 SVDQ W4A4 目标,把识别出的调制层列为 AWQ W4A16 目标,其余保留高精度。原文对 FLUX.2 Klein 4B 的预期报告是 100 个 SVDQ 目标、3 个 AWQ 目标和 6 个保持稠密的外围线性层。量化前应读完检查报告,确认目标没有缺项或重名。
python examples/text_to_image/quantize_hf.py \
  black-forest-labs/FLUX.2-klein-4B \
  --precision int4 --rank 32 --inspect-config

python examples/text_to_image/quantize_hf.py \
  black-forest-labs/FLUX.2-klein-4B \
  --precision int4 \
  --output outputs/checkpoints/svdq-int4_r32-flux-2-klein-4b.safetensors

python examples/convert_nunchaku_lite_diffusers.py \
  --checkpoint outputs/checkpoints/svdq-int4_r32-flux-2-klein-4b.safetensors \
  --model-id black-forest-labs/FLUX.2-klein-4B \
  --bnb4-text-encoder text_encoder \
  --compute-dtype bfloat16 \
  --output-dir outputs/diffusers/FLUX.2-klein-4B-nunchaku-lite-int4-bnb4-text-encoder
若要使用 nvfp4 替代 int4,目标 GPU 必须在其支持范围内。转换器会把量化 Transformer 与基础管线的其它组件组合起来,并写入 Diffusers 配置;需要时还可转换文本编码器。原文通过以下代码加载打包后的管线并生成图像:
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "outputs/diffusers/FLUX.2-klein-4B-nunchaku-lite-int4-bnb4-text-encoder",
    device_map="cuda",
)
image = pipe(
    "A glass robot in a greenhouse, cinematic lighting",
    num_inference_steps=4,
    guidance_scale=1.0,
    generator=torch.Generator("cuda").manual_seed(12345),
).images[0]
原文接着提出可以手动调用 pipe.push_to_hub("your-name/your-model-nunchaku-lite-int4")。该操作会把模型内容上传到 Hugging Face Hub;上传前应人工检查模型文件、元数据、许可证、仓库目标及访问范围。本文不把上传作为默认步骤。
相关量化指南是另一仓库中的较新说明:截至 2026-08-18 的 指南快照要求单独安装 nunchaku_lite(它不包含在该仓库的 [examples] extra 中),并使用包含 NunchakuLiteQuantizationConfig 的 Diffusers 版本。其校准命令还显式设置样本数、批量、计算设备与卸载方式。博客里的短命令没有锁定这些依赖,也不是该量化指南的完整复现环境;实际安装前应按选定的仓库提交和发行版本逐项核对。
结构重写不是通用扫描器能自动猜出的
通用路径假设模型无需改变模块结构。以 FLUX.1-dev 为例,Diffusers 将 Q、K、V 分别投影,再拆分头、执行 Q/K 归一化及旋转位置编码:
self.to_q = torch.nn.Linear(query_dim, self.inner_dim, bias=bias)
self.to_k = torch.nn.Linear(query_dim, self.inner_dim, bias=bias)
self.to_v = torch.nn.Linear(query_dim, self.inner_dim, bias=bias)

query = attn.to_q(hidden_states)
key = attn.to_k(hidden_states)
value = attn.to_v(hidden_states)
query = query.unflatten(-1, (attn.heads, -1))
key = key.unflatten(-1, (attn.heads, -1))
value = value.unflatten(-1, (attn.heads, -1))
query = attn.norm_q(query)
key = attn.norm_k(key)
if image_rotary_emb is not None:
    query = apply_rotary_emb(query, image_rotary_emb, sequence_dim=1)
    key = apply_rotary_emb(key, image_rotary_emb, sequence_dim=1)
Nunchaku 把三个投影合成一个 to_qkv 模块,再用融合算子接收投影、归一化层和旋转嵌入:
to_qkv = fuse_linears([other.to_q, other.to_k, other.to_v])
self.to_qkv = SVDQW4A4Linear.from_linear(to_qkv, **kwargs)

qkv = fused_qkv_norm_rottary(
    hidden_states, attn.to_qkv, attn.norm_q, attn.norm_k, image_rotary_emb
)
这类结构重写不能由通用路径自行推断。Diffusers 的三个参数前缀 to_q、to_k、to_v 必须按 Q→K→V 的顺序沿输出维拼接,再映射到 to_qkv。模型专用的目标配置及运行时适配器还需处理融合张量或拆分投影;仅靠通用层名匹配不足以保证正确。
现成检查点、结论与后续资料
原文列出可直接尝试的检查点:
- rootonchair/ERNIE-Image-Turbo-nunchaku-lite-int4-bnb4-text-encoder:INT4 Transformer、bitsandbytes NF4 文本编码器。
- rootonchair/ERNIE-Image-Turbo-nunchaku-lite-nvfp4-bnb4-text-encoder:NVFP4 Transformer、bitsandbytes NF4 文本编码器。
- OzzyGT/Krea_2_Turbo_nunchaku_lite_nvfp4:NVFP4 Krea 2 Turbo 检查点。
- lite-infer 检查点集合:更多 Nunchaku Lite 模型。
检查点许可不能互换:截至 2026-10-08,两个 rootonchair ERNIE-INT4 与 ERNIE-NVFP4 模型卡均声明 Apache-2.0,并说明其遵循 Baidu 基础 ERNIE-Image-Turbo 的许可证;OzzyGT Krea 2 NVFP4 模型卡则声明 Krea-2 Community License,并链接单独的 LICENSE.pdf,不能将其归入 Apache-2.0。Krea 2 社区许可允许商业使用的条件之一是:企业及其共同控制关联实体过去 12 个月的合并年营收低于 100 万美元;达到或超过该门槛时,商业使用需先取得单独企业许可。分发模型或派生版本时还要求随附该许可、约束接收者并提供规定的 NOTICE 署名。本稿只链接模型卡,不分发其权重,具体条款见许可证全文。博客载入代码中的精确仓库 ID lite-infer/ERNIE-Image-Turbo-nunchaku-lite-nvfp4_r32-bnb4-text-encoder 在本次官方 Hub 元数据查询中返回 HTTP 401,因此该精确 ID 的许可状态未能核实;使用前应检查它当前的模型卡和访问条件。
作者总结称,SVDQuant 内核已进入 Diffusers 的原生工作流;预量化检查点可以 from_pretrained() 载入,diffuse-compressor 则提供将新架构量化的工具。W4A4 同时量化权重和激活,目标是在接近 BF16 图像质量的同时降低显存和去噪延迟。即使 Hub 模型卡列出软件许可证,基础模型、tokenizer、文本编码器、CUDA kernels 与数据也可能有独立条款,使用前应逐项核对。
继续阅读:Diffusers Nunchaku 文档;集成 PR #14100;SVDQuant 论文;Nunchaku 引擎;diffuse-compressor。相关旧文包括 Diffusers 中的量化后端 与 Quanto 和 Diffusers 的节省显存型扩散 Transformer。有问题可到 Hugging Face Discord 讨论。
所有模型、检查点、文本编码器与内核均需遵守各自的使用条款。本文未下载模型或量化新权重;原文的性能数据未由本稿独立复测。
来源:Bringing Nunchaku 4-bit Diffusion Inference to Diffusers,作者 Pham Hong Vinh、Sayak Paul,Hugging Face Blog,2026-07-23。感谢段还提及 Diffusers 维护者、MIT HAN Lab / Nunchaku 团队、Marc Sun、Álvaro Somoza 与 SilverAI。原文页面未标注单篇转载许可;本文依据另行取得的翻译转载许可发布;不据此推定博客文字或模型为开放许可。diffuse-compressor 仓库代码使用 Apache-2.0;模型、权重与 kernels 的许可须分别核对。正文包含四张按各图注所述许可转载的原文图像及一张自绘技术示意图。Apache-2.0 代码许可全文见随附的 LICENSE-APACHE-2.0.txt;逐项归属、转载许可范围与插图说明见下文“归属与许可范围”附录。
归属与许可范围
原文文字
- 原文:Hugging Face Blog,Bringing Nunchaku 4-bit Diffusion Inference to Diffusers,作者 Pham Hong Vinh、Sayak Paul,发表于 2026-07-23。
- 原文页面与公开博客仓库未显示适用于整篇文章文字的开放许可。本文为依据另行取得的翻译转载许可所作译写;这项许可不把原文文字转换为开源或开放许可。
- 保留作者署名、来源链接、日期与致谢。原文中的代码、模型和权重不因文章许可说明而改变各自的许可范围。
原文插图
以下四张 PNG 按原始字节、像素尺寸和色彩模式保存,未裁切、改色、压缩或移除图中署名:
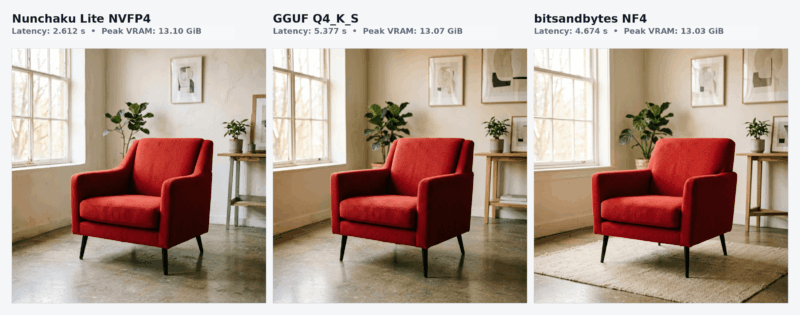
assets/original/contact_sheet_top3_metrics_bold.png,3224×1268,Hugging Face Blog 原图;来源为 原始文件。assets/original/fox_bf16_vs_nunchaku_no_metrics.png,2172×1232,Hugging Face Blog 原图;来源为 原始文件。assets/original/svdquant_kernel_fusion.png,1663×380。Hugging Face Blog 原文图注明确注明图来自 SVDQuant 论文。论文作者为 Muyang Li、Yujun Lin、Zhekai Zhang、Tianle Cai、Xiuyu Li、Junxian Guo、Enze Xie、Chenlin Meng、Jun-Yan Zhu、Song Han。来源为 SVDQuant 论文 和 博客所用原图文件。arXiv 页面记录作者授予 arXiv 的非独占分发许可;该记录不是开放图片再利用许可。本稿保留论文署名,转载依据另行取得的许可。assets/original/quality_grid.png,1046×1222,Hugging Face Blog 原图;来源为 原始文件。
Hugging Face Blog 未在文章页为上述插图标注开放许可。图注保留来源与作者,原图使用依据另行取得的许可;不将许可说成开放许可。
软件代码
LICENSE-APACHE-2.0.txt是rootonchair/diffuse-compressor仓库提供的 Apache License 2.0 全文。- 该仓库的 LICENSE 仅适用于按其条款分发的相应代码,不适用于 Hugging Face Blog 全文、原图或模型/权重。
- 在本次捕获的仓库版本中,仓库根目录
NOTICE文件查询返回 404;没有另行 NOTICE 文件可随包复制。候选稿仍保留源仓库与许可证链接。 - 截至 2026-10-08,两个 rootonchair ERNIE INT4/NVFP4 bundle 模型卡声明 Apache-2.0,并称遵循 Baidu 基础 ERNIE-Image-Turbo 的许可证。OzzyGT Krea 2 NVFP4 模型卡声明
Krea-2 Community License,并链接其 LICENSE.pdf。该许可允许商业使用的条件之一是企业及其共同控制关联实体过去 12 个月的合并年营收低于 100 万美元;达到门槛时需事先取得单独企业许可。若分发模型或派生版本,还要求随附许可副本、约束接收者、使用符合条件的模型命名并提供规定的 NOTICE 署名。本稿只链接模型,不分发其权重,因此没有在此附加 Krea 权重的 NOTICE。 - 文章中的精确模型 ID
lite-infer/ERNIE-Image-Turbo-nunchaku-lite-nvfp4_r32-bnb4-text-encoder在 2026-10-08 的官方 Hub 元数据请求返回 HTTP 401,未确认该确切仓库的许可或访问条件;候选稿明确提示读者先检查其当前模型卡。 - 预训练模型、检查点、分词器、CUDA kernels 及第三方数据资源均需分别遵守其各自的许可与访问条款。
本稿原创图
assets/nunchaku-diffusers-flow.svg 为本稿原创示意图;依据原文技术描述绘制,未复用外部素材。










暂无评论内容