


用 100 步 GRPO 微调 3.5 亿参数模型,让结构化输出更可靠
本教程介绍一种轻量方法,让小模型更好地按要求生成结构化输出。作者使用 TRL 库中的组相对策略优化(Group Relative Policy Optimization,GRPO),对 LiquidAI/LFM2.5-350M 做微调,并在 IFStruct 基准上评估。整套训练使用约 500 条样本、100 个训练步骤,面向 Colab 或 Kaggle 免费 GPU 环境。作者报告 IFStruct 总通过率从 22.6% 提升到 29.7%。
结构化输出是大语言模型常见的实际任务,但很多基准把它混在更广泛的推理或信息抽取分数中。模型能否按请求返回可解析、符合指定格式和结构的结果,也就是模式合规性,往往决定它能不能接入下游系统。
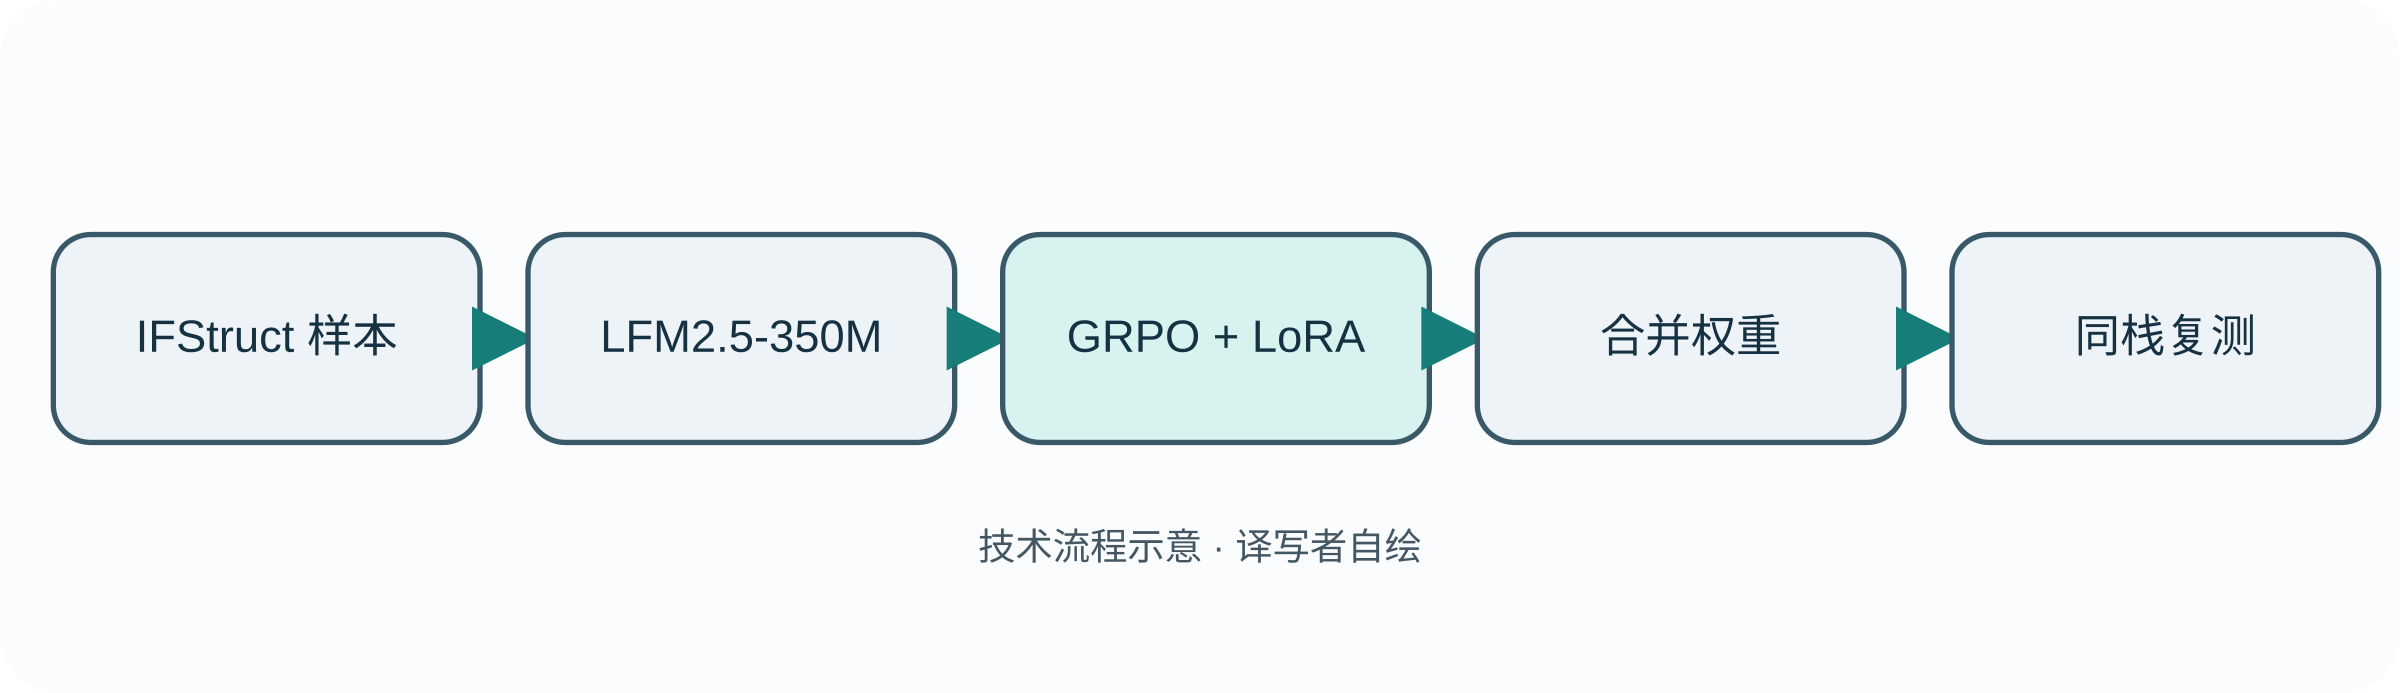
重要背景:本教程中的训练流程不同于 IFStruct 博客所述的强化学习模型训练流程。这里的 notebook 不试图复现 IFStruct 博客公布的基准分数,而是展示面向具体任务微调小模型的方法,并比较它与更大模型的结果。
准备环境
教程分为两个阶段,运行地点也不同:
- 微调在 GPU 上进行。随附 notebook 面向 Colab 或 Kaggle 的免费 GPU 配额。
- 评估可在本地 MacBook 上运行。原文使用配备 Apple M5 Max、36 GB 统一内存的 MacBook Pro,通过 llama.cpp 启动 OpenAI 兼容服务,再由 IFStruct 评估器调用。
本文命令使用 uv 管理 Python 工具,并需要 llama.cpp 的 llama-server。依赖、操作系统和硬件要求会变化;复现前应核对并固定 Python 包、仓库提交、模型与数据 revision。
依照 Liquid AI 的 llama.cpp 部署说明,教程先通过 Homebrew 安装并检查服务版本:
brew install llama.cpp
llama-server --version
IFStruct 基线评估
开始前,作者先评估 LFM2.5-350M,并尝试对照 IFStruct 博客报告的 21.1% 分数。IFStruct 是检查语言模型输出是否有效且符合 JSON/YAML schema 的基准;公开仓库和数据集分别托管在 Liquid4All/ifstruct 与 LiquidAI/ifstruct-v1.0。教程称所用模型为“base model”,但截至 2026-10-08,模型卡把精确 ID LiquidAI/LFM2.5-350M 列为通用指令微调模型,并单独列出 LiquidAI/LFM2.5-350M-Base 作为预训练基座。原文未解释这一命名差异;下文按源文报告其结果,同时保留实际模型 ID,不推断它等同于另一个 Base 检查点。教程先克隆评估仓库:
git clone https://github.com/Liquid4All/ifstruct.git
cd ifstruct
原文省略了进入克隆目录的步骤;该目录含 pyproject.toml、评估数据和 ifstruct-eval 项目脚本,因此在仓库根目录执行后续评测命令。
模型通过 llama.cpp 在本机提供服务,使用 LFM2.5-350M 的 BF16 GGUF 格式,模型文件位于 LiquidAI/LFM2.5-350M-GGUF。基座服务命令如下:
llama-server \
  -hf LiquidAI/LFM2.5-350M-GGUF:BF16 \
  -c 32768 \
  -np 4 \
  -ngl 99 \
  --alias LiquidAI/LFM2.5-350M \
  --host 127.0.0.1 \
--port 8080--alias:模型在 OpenAI 兼容接口中的名称,供 IFStruct 调用。-ngl 99:在后端支持时,要求把所有层卸载到 GPU。-np 4:允许四个并行请求。-c 32768:设置提示上下文长度。
服务启动后,用 2000 个样本运行完整评估:
uv run ifstruct-eval \
  --model LiquidAI/LFM2.5-350M \
  --base-url http://localhost:8080/v1 \
  --api-key dummy \
  --dataset data/test.jsonl \
  --results-file results/lfm2.5-350m-llamacpp-base.json \
  --n-threads 4 \
  --max-tokens 2048 \
  -v
--api-key dummy 是本地兼容接口示例值,不是认证保护。服务器显式绑定 127.0.0.1;不要把它改成公开可访问的地址,也不要把这个参数当成远程服务的安全认证。IFStruct 的结果文件会写入每条样本的提示、模型响应和验证结果,分享或上传前应检查其中是否含有不应外传的内容。
作者报告的基座结果如下:
- 总通过数:452/2000(22.6%);平均延迟:1453 毫秒。
- 按格式:JSON 180/1000(18.0%);YAML 272/1000(27.2%)。
- 按顶层结构:带包装键的对象 288/1011(28.5%);裸列表 164/989(16.6%)。
| 实体类别 | 通过数 | 通过率 |
|---|---|---|
test__camera_review |
6/83 | 7.2% |
test__clinical_trial |
20/104 | 19.2% |
test__conference_schedule |
7/87 | 8.0% |
test__escaping__bug_report_batch |
24/89 | 27.0% |
test__escaping__config_snippet_audit |
15/85 | 17.6% |
test__escaping__customer_email_thread |
5/73 | 6.8% |
test__escaping__dialogue_sample |
14/95 | 14.7% |
test__escaping__interview_transcript_segment |
21/80 | 26.2% |
test__escaping__log_parser_examples |
21/72 | 29.2% |
test__escaping__pr_discussion |
22/87 | 25.3% |
test__escaping__repro_steps_batch |
16/73 | 21.9% |
test__escaping__screenplay_scene |
16/92 | 17.4% |
test__escaping__short_story_chapter |
15/84 | 17.9% |
test__escaping__support_ticket_batch |
27/73 | 37.0% |
test__escaping__terminal_session_notes |
20/70 | 28.6% |
test__event_ticket_booking |
49/107 | 45.8% |
test__gpu_review |
6/94 | 6.4% |
test__invoice |
28/86 | 32.6% |
test__job_posting |
25/85 | 29.4% |
test__real_estate_listing |
31/82 | 37.8% |
test__recipe |
3/70 | 4.3% |
test__rental_car_booking |
27/79 | 34.2% |
test__scientific_experiment |
13/69 | 18.8% |
test__travel_itinerary |
21/81 | 25.9% |
最常见的错误为:
- 7228 次:缺少必需字段。
- 738 次:项目数量错误。
- 540 次:类型不匹配。
- 317 次:代码围栏未闭合。
- 190 次:多出未请求的
notes字段。 - 181 次:多出未请求的
path字段。 - 175 次:多出未请求的
constraints字段。 - 170 次:多出未请求的
type字段。 - 170 次:缺少代码围栏。
- 100 次:要求裸列表,却返回了包装对象。
IFStruct 发布博客给出的 LFM2.5-350M 分数为 21.1%。教程在本机 llama.cpp/BF16 环境测得 22.6%,与该数字接近,并把本地测量作为后续比较的基线。两者的服务环境不同,不能当作同一次测量。
使用 TRL 做 GRPO 微调
完整训练流程保存在配套 notebook中;以下聚焦其主要组成部分。
训练数据
数据来源为 nvidia/Nemotron-RL-instruction_following-structured_outputs。每行包含提示、目标 JSON Schema 和预期字段数。教程首先请求前 1000 行,随后根据 notebook 已保存的输出,过滤掉过长提示后剩 573 行,再剔除无效 schema 后剩 537 行,约为 500 条。训练集分布与 IFStruct 评测集不同,因此作者改写部分提示来贴近评测要求:
- 40% 的样本追加“请把输出放在围栏代码块中”的指令,训练模型根据要求使用代码围栏,而不是总输出裸 JSON。
- 互不重叠的 20% 改成顶层数组任务:schema 外包为数组,并要求固定数量的条目,以训练裸列表格式和项目数遵循能力。
模型和 LoRA
模型为 LiquidAI/LFM2.5-350M,再接入 LoRA 适配器。LFM2.5 使用混合注意力/卷积架构,因此配置针对模型具体模块名称:
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        "q_proj", "k_proj", "v_proj", "out_proj", "in_proj",
        "w1", "w2", "w3",
    ],
)
notebook 输出显示,可训练参数为 5,996,544,总参数为 360,480,512,占 1.6635%(约 600 万、1.66%)。模型卡将此模型标为 350M 参数;训练日志中的总参数计数略高于命名规格值,本文分别按各自来源记录。
奖励函数
作者定义三个 0 到 1 之间的奖励函数,用生成结果的结构合规情况打分:
json_format_reward:检查结果能否解析,以及是否符合要求的格式(直接 JSON 或围栏代码块)。形式正确给 1.0;形式不符但仍可解析给 0.2;无法解析给 0。field_count_reward:检查顶层字段数。精确匹配得 1.0,偏差按相对差距线性扣分。输出为数组时,按其中对象的平均字段数计分。schema_validation_reward:用行对应的 JSON Schema 统计约束错误,并以必需键覆盖率控制部分奖励;错误越多得分越低。对数组还按要求的条目数和对象必需字段覆盖率计分。
合并权重为 reward_weights=[1.0, 0.5, 2.0],依次对应格式、字段数量和 schema 验证奖励。
训练配置
配置运行 100 步,每组提示采样 8 个候选结果,面向免费层级的 16 GB GPU:
from trl import GRPOConfig

training_args = GRPOConfig(
    output_dir="./outputs/lfm25-350m-nemotron-schema-grpo",
    learning_rate=5e-5,
    max_steps=100,
    warmup_steps=10,
    num_generations=8,              # 每组提示采样的回答数
    per_device_train_batch_size=4,
    gradient_accumulation_steps=8,  # 每次更新累积 4 组提示
    steps_per_generation=2,
    max_completion_length=1024,     # 为嵌套 JSON 留出空间
    mask_truncated_completions=False,
    temperature=1.1,                # 较高采样温度增加组内差异
    beta=0.01,                      # 相对参考模型的 KL 惩罚
    reward_weights=[1.0, 0.5, 2.0], # 格式、字段数、schema 验证
    logging_steps=1,
    save_steps=100,
)
notebook 的已保存训练图显示三个奖励分量总体上升;预热后与参考模型的 KL 值离开零点;被截断的生成比例接近零。这些是源 notebook 中记录的结果,不是本稿重跑所得。
合并并保存模型
训练结束后,把 LoRA 适配器合并回基础模型权重,再保存模型和 tokenizer,形成单一检查点以供后续 GGUF 转换:
MERGED_DIR = f"{training_args.output_dir}-merged"

merged_model = trainer.model.merge_and_unload()
merged_model.save_pretrained(MERGED_DIR)
tokenizer.save_pretrained(MERGED_DIR)
评估 GRPO 微调后的 LFM2.5-350M
微调后,教程把合并后的模型转为 BF16 GGUF。转换脚本来自 llama.cpp 源码,需要先克隆仓库并安装其中的 gguf Python 包:
git clone --depth 1 https://github.com/ggml-org/llama.cpp
pip install ./llama.cpp/gguf-py

mkdir -p models
python llama.cpp/convert_hf_to_gguf.py \
  PATH_TO_YOUR_MERGED_MODEL \
  --outfile ./models/lfm25-350m-grpo-bf16.gguf \
  --outtype bf16
启动微调模型服务:
llama-server \
  -m ./models/lfm25-350m-grpo-bf16.gguf \
  --alias lfm25-350m-grpo-structured-output \
  -c 32768 \
  -np 4 \
  -ngl 99 \
  --host 127.0.0.1 \
  --port 8081
随后用相同评估集、线程数和最大生成 token 数再次运行 IFStruct:
uv run ifstruct-eval \
  --model lfm25-350m-grpo-structured-output \
  --base-url http://localhost:8081/v1 \
  --api-key dummy \
  --dataset data/test.jsonl \
  --results-file results/lfm25-350m-grpo.json \
  --n-threads 4 \
  --max-tokens 2048 \
  -v
作者报告的微调后结果如下:
- 总通过数:594/2000(29.7%);平均延迟:1518 毫秒。
- 按格式:JSON 319/1000(31.9%);YAML 275/1000(27.5%)。
- 按顶层结构:带包装键的对象 300/1011(29.7%);裸列表 294/989(29.7%)。
| 实体类别 | 通过数 | 通过率 |
|---|---|---|
test__camera_review |
5/83 | 6.0% |
test__clinical_trial |
31/104 | 29.8% |
test__conference_schedule |
11/87 | 12.6% |
test__escaping__bug_report_batch |
32/89 | 36.0% |
test__escaping__config_snippet_audit |
24/85 | 28.2% |
test__escaping__customer_email_thread |
9/73 | 12.3% |
test__escaping__dialogue_sample |
17/95 | 17.9% |
test__escaping__interview_transcript_segment |
13/80 | 16.2% |
test__escaping__log_parser_examples |
33/72 | 45.8% |
test__escaping__pr_discussion |
26/87 | 29.9% |
test__escaping__repro_steps_batch |
23/73 | 31.5% |
test__escaping__screenplay_scene |
34/92 | 37.0% |
test__escaping__short_story_chapter |
24/84 | 28.6% |
test__escaping__support_ticket_batch |
36/73 | 49.3% |
test__escaping__terminal_session_notes |
23/70 | 32.9% |
test__event_ticket_booking |
62/107 | 57.9% |
test__gpu_review |
7/94 | 7.4% |
test__invoice |
36/86 | 41.9% |
test__job_posting |
33/85 | 38.8% |
test__real_estate_listing |
32/82 | 39.0% |
test__recipe |
7/70 | 10.0% |
test__rental_car_booking |
37/79 | 46.8% |
test__scientific_experiment |
14/69 | 20.3% |
test__travel_itinerary |
25/81 | 30.9% |
常见错误统计如下:
- 7331 次:缺少必需字段。
- 890 次:项目数量错误。
- 555 次:类型不匹配。
- 102 次:要求裸列表,却返回了包装对象。
- 62 次:多出
metadata.tone字段。 - 55 次:数值 6 超过最大值 5。
- 49 次:多出
speaker_labels字段。 - 47 次:多出
tone字段。 - 44 次:
cups不在允许值mg、g、kg、oz、lb、ml、l、cl、dl之中。 - 44 次:多出
notes字段。
两次实验在 IFStruct 总分与分项上的差异如下:
| IFStruct 项目 | 基座模型 | GRPO 微调 | 变化 |
|---|---|---|---|
| 总通过率 | 22.6% | 29.7% | +7.1 个百分点 |
| JSON | 18.0% | 31.9% | +13.9 个百分点 |
| YAML | 27.2% | 27.5% | +0.3 个百分点 |
| 包装对象 | 28.5% | 29.7% | +1.2 个百分点 |
| 裸列表 | 16.6% | 29.7% | +13.1 个百分点 |
提升集中在训练目标更直接对应的输出形式:JSON 通过率接近提高 14 个百分点,而 YAML 基本不变。微调后的 29.7% 仍低于 Liquid AI 博客列出的 Qwen3.5-2B 分数 33.15%。这组结果说明面向特定任务的微调可能让小模型靠近更大模型的某些基准分数,但不等于两者在其他任务上能力相同。
结语与复现边界
作者的结论是:用约 500 条样本进行 100 步 GRPO 微调,可把该实验设置中的 350M 级模型 IFStruct 通过率从 22.6% 提升到 29.7%。输出格式方面的收益并不意味着模型已经足够可靠:微调后仍有大多数样本未通过,也仍出现大量必需字段缺失、条目数量和类型错误。生产流程仍应严格解析模型输出、按 schema 校验,并针对失败结果设计回退处理。
复现或扩展时,可参考 IFStruct v1.0 原文、Liquid4All/ifstruct 基准仓库和 LiquidAI/ifstruct-v1.0 数据集。训练笔记本使用未固定 revision 的模型和训练数据;其安装命令固定 TRL 1.7.1、Transformers 5.13.0、PEFT 0.19.1,并要求 torchao>=0.16.0,而 datasets、accelerate、jsonschema、matplotlib 未固定版本。notebook 的模型加载参数设置了 trust_remote_code=True,启用前应检查并固定所下载模型仓库的代码 revision。原文克隆 IFStruct 后未展示 cd ifstruct;本稿补上进入项目根目录这一步,才能使用该仓库的数据文件和 uv run 脚本。
原文在基线阶段用 brew install llama.cpp 安装服务,在微调阶段用 git clone --depth 1 获取 llama.cpp 转换脚本;这些命令都没有固定版本或 commit。教程也没有在命令中固定 IFStruct 仓库提交。源文的分数与环境和代码版本有关,本文仅转述作者记录,没有运行训练、模型、转换脚本或 benchmark,也未验证这些结果能在当前软件组合中重现。
评测器按 --base-url 向 OpenAI 兼容接口发出请求,并可能多次重试;它会把完整提示、响应及验证细节写入本地结果 JSON。运行前应确认 endpoint、并发数、重试成本和输出目录;避免把敏感提示发送至非预期的远程服务,也不要公开上传包含提示或响应的结果文件。示例把服务器绑定到回环地址,dummy key 只是请求头中的示例字符串,不提供身份验证。
来源:Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps。原文作者为 Leonie Monigatti、ben burtenshaw、Sergio Paniego,发表于 2026-09-03。原文页面与公开博客仓库未显示适用于该篇文章文字或缩略图的开放许可;本译稿及缩略图依据另行取得的许可使用。训练 notebook 仓库根目录的 LICENSE 查询为 404,本稿不据此声称 notebook 代码为开放许可。LFM2.5-350M 与 GGUF 模型卡标注 LFM1.0 许可;NVIDIA 训练数据集标注 CC BY 4.0;IFStruct 数据集与评测代码仓库标注 Apache-2.0。上述资源许可互不替代,使用前应分别阅读对应条款。










暂无评论内容