


tokenizers v1:编码、解码与多核扩展,性能提升来自哪里
原作者:Arthur Zucker、Simon Brandeis、Luc Georges、Lysandre。本文根据 Hugging Face 于 2026 年 9 月 21 日发表的 tokenizers v1: encode, decode and scaling, measured 翻译整理,核验日期为 2026 年 10 月 5 日。文中“v1”指原文介绍的 Rust 发布候选版本;路线图中的工作不能视作已经发布。原文页面没有标明适用于整篇文章的开放许可;本译稿及原文缩略图依据另行取得的许可使用,这不构成开放许可。文末分别说明博客文字、插图和软件代码的许可范围。
在过去的机器学习工作流中,分词器往往不是瓶颈。与模型计算相比,把文本转换为 token 的计算量相对小。可是,当模型运行得越来越快,训练数据集越来越大,并发服务与长输入越来越常见时,这个关系就会改变:CPU 上的分词过程可能来不及供给数据,让 GPU 等待。
因此,Hugging Face 把即将到来的 tokenizers 第一个大版本的重点放在性能上。分词应当保持轻量,并能随工作负载扩展。原文介绍的是 v1 相对 v0.23 的重构:输出保持一致,减少实现内部的多余工作。
作者同时强调,这些成果建立在整个开源生态的工作上。gigatoken、tiktoken、kitoken、tokie、fastokens、wordchipper 和 ai-tokenizer 等项目,都给出了值得尝试的思路。作者感谢 IBM、NVIDIA 与 ExecuTorch 团队贡献补丁,以及帮助验证不同硬件平台。
先读懂结果适用的条件
原文通过 tokbench 对发布候选版本与常见替代实现做比较,覆盖单线程、多线程、随线程数增加的扩展性、模型和语言差异、延迟、解码吞吐、堆内存以及 crate 大小。完整交互图可在原作者结果页查看。本次保存的结果页内嵌元数据将主基准数据记录 176 个测试单元,其中 176 个通过 token ID 哈希核验;其核心编码行对应 tokenizers-rc0 @ 199d9a13。缓存图的 pipeline 版本另标为 rc0 @ 5c3727a9,crate-size 图又使用 484be1d3 修订;不能把结果页所有图都理解为同一个源码修订的测量。原作者结果页未在这些摘要元数据中提供原运行的完整语料 revision。
正文给出的核心结果是:在 Apple M4 Max 上,所覆盖的十个模型家族中,v1 单线程编码速度达到 v0.23 的 3~30 倍;低端对应 t5-base,高端对应 gpt2。一个 tokenizer 使用原生线程,从一个 worker 扩展到八个 worker 时,达到了理想线性扩展的 76%。这些都是原作者的实验结果,本次编译整理没有运行基准。
结果页还说明,在参与解码测量的六个模型家族中,同一 M4 Max 上的 v1 解码吞吐为 tokenizers 0.23 的 5.4~8.8 倍,吞吐按解码后的 UTF-8 MB/s 表示。不能把这个解码区间与十个家族的编码区间混为一谈。编码、解码、扩展性和 crate-size 图来自各自数据快照;分析时应连同图中的引擎覆盖数、ID 校验状态和 revision 阅读,不能只按速度排序。
并行方式也会影响结论。原生线程方式共享一个 tokenizer,让库内部工作池分配批次;独立实例方式则为每个 worker 使用一个 tokenizer,没有共享状态。原文中 v1 在原生线程方式下表现最好,gigatoken 则更适合独立实例方式。延迟图测的是预热 tokenizer 对一段 512 字节英文文档的逐调用编码耗时;p99 是第 99 百分位的延迟阈值。它与单位时间处理的总数据量回答的是不同问题。
内存图使用 gpt-oss tokenizer 与 1.024 MB 英文文本,分别比较单 worker、一个 tokenizer 的八原生线程及八个独立 tokenizer。图中考察加载完成与预热编码完成后的存活堆内存,后者已释放返回的 token 缓冲区。本稿不把未逐项提取的交互图数值重画成新的“实测”图,也不从动画的播放速度推导性能倍数。
四个阶段,输出保持一致
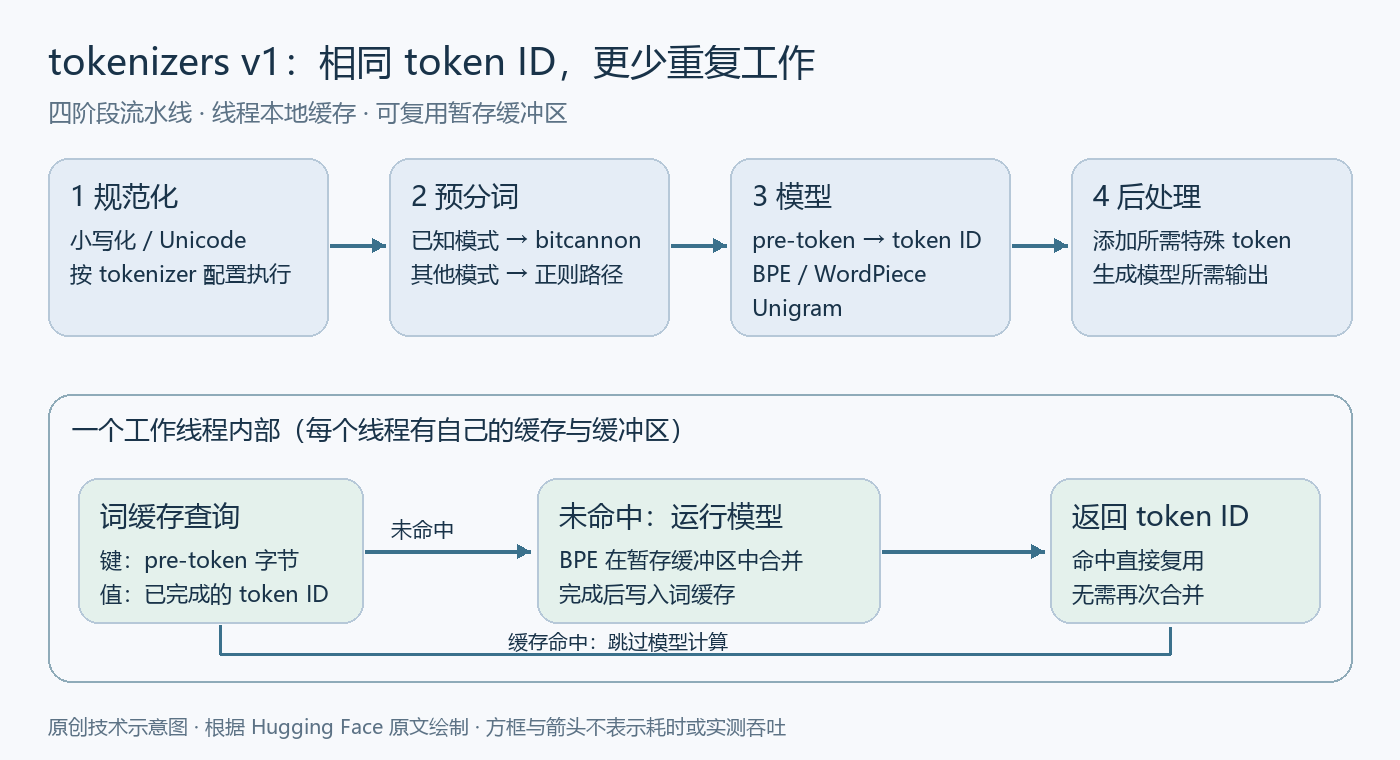
tokenizer 把文本转换为模型读取的整数列表。tokenizers 的转换流程分为四步:
- 规范化:对原始文本应用小写化、Unicode 规范化等操作。
- 预分词:把文本切分为更小的片段,即 pre-token。
- 模型:把每个 pre-token 转成 token,并映射到词表中的 ID。
- 后处理:添加模型要求的特殊 token 等信息。
v1 的目标是在保留 API、词表、合并优先级及 token ID 的前提下优化实现,并继续支持 v0.23 已能加载的 tokenizer,而不是只专门优化 BPE。原文测量的十个家族中,八个使用字节对编码(BPE),另两个使用 WordPiece 与 Unigram。
BPE 从 pre-token 的字节开始,反复选取优先级最高的相邻对进行合并,直到没有可合并的已排名相邻对。合并排名在 tokenizer 训练时得到,并随 tokenizer 一起发布。合并始终限制在一个 pre-token 内,不会跨越预分词边界。因此,优化切分器时必须保证等价的边界,而不能为了速度任意改变分词结果。更多背景见 tokenization pipeline 与 Tokenization algorithms。
| 改动 | 减少了什么工作 |
|---|---|
| 拆分 workspace | 从单个 crate 拆出必要的运行时 tk-encode;tk-serialize、tk-convert、tk-train 仅在应用需要时链接。 |
| 模型阶段避免分配 | 合并过程的工作集放入调用方拥有的暂存缓冲区,循环不再反复访问内存分配器。 |
| bitcannon 切分 | 把适用的切分规则转换为位流上的布尔运算,以 SIMD 寻找边界。 |
| 重写合并循环 | 在预分配缓冲区内用侵入式双向链表组织片段,合并只更新索引,避免搬移数据。 |
| 词缓存 | 线程本地缓存从 pre-token 字节到最终 ID 的映射,重复片段不再重复合并。 |
| 原生并行 | 多个线程共享 tokenizer,但各线程从自己的子池获取暂存缓冲区和词缓存,减少在单一锁上排队,见 #2365。 |
用位流运算替代反复解释正则
相关 BPE tokenizer 使用正则表达式把输入切成 pre-token。这个表达式是随 tokenizer 固定下来的模型参数,不会在每次编码时变化。对已知模式,可以一次性手写一个行为等价的切分函数,免去通用正则引擎每次重新解释规则的成本。
这样的函数可以利用现代 CPU 的 SIMD 指令:同一条操作同时作用于多个字节。bitcannon 把输入字节看成并行的位流,通过整个寄存器范围内的布尔运算找出边界,而不是逐字符推进。原文描述其每次寄存器操作可判断 64 字节。类似思路也出现在文本处理项目 Parabix 和 JSON 解析器 simdjson 中。
这项优化的前提是能识别 tokenizer 使用的模式。少数几种语法覆盖了大部分字节级 BPE 模型;不属于已支持模式的 tokenizer 仍走正则路径,不能获得这部分加速。这也是不同模型收益差异很大的原因。原文切分动画只是结构示意:当前公共 pipeline API 没有为两个版本同时提供可直接对照的独立切分计时,因此作者没有把整体加速拆出一个“切分阶段快了多少倍”的数字。
词缓存:重复片段只做一次合并
自然文本里有大量重复词。对给定 tokenizer 的同一个 pre-token,BPE 会得到同样的 token ID,因此 v1 可以缓存第一次计算的结果。缓存位于线程本地,键是 pre-token 的字节,值是最终 ID;后续命中便能跳过合并过程。
当文本增长时,不同词的数量可能增长得比总词数慢,重复片段便占据更高比例。新词仍会出现,所以并非每次查询都会命中。如果输入几乎不重复,就可能只支付查询成本,却收获不了多少命中收益。这项缓存也用于 WordPiece 和 Unigram。
结果页对共享前缀测量做了具体说明:每份报告使用来自真实 agent trace 的 100 个不同请求,每个请求 10 KiB,其中共享前缀为 8 KiB,后缀不同;展示值来自三份报告、每份八个模型单元的中位数,启用与禁用缓存两种配置产生相同 ID。结果页报告共享前缀上缓存开启/关闭的吞吐比为 2.03 倍;在一个完整报告的八个模型家族中,agentic-swe 语料的中位数为 1.38 倍。结果页缓存图把 pipeline build 标为 tokenizers-rc0 @ 5c3727a9,因此应将它视为单独的源修订结果。语料柱形图则是一份完整报告中八个模型家族的中位数。重现共享前缀测量使用的原文命令如下:
tokbench measure prefix-sharing \
  --engine pipeline \
  --engine hf-tokenizers \
  --compare-to pipeline-no-cache \
--corpus agentic_swe命令与数据名核验:上框保留了原文拼写 agentic_swe。本次只读核对的 tokbench 提交 2063586901904310cf7fcec1c8a9f80c5a357399 按文件名 stem 精确筛选 corpus;其公开 fixture 名为 agentic-swe,不会把下划线自动归一成连字符。若基于这个提交复现,应把参数改为 --corpus agentic-swe,并先用 make fixtures CORPORA_REVISION=<sha> 固定语料;Hugging Face 当前数据集 revision 为 bafa2fb4795b3bff1ae0c883c9abcb016fdc5964,但原结果页没有记载是否用了该 revision。tokbench 把 agentic-swe 标为 MIT;另有 code-mixed、agentic-traces 等内部或许可/来源不清的数据,不能与它混同。此处是代码静态核对,本稿未执行构建、数据下载或 benchmark。
合并循环:复用内存,少做搬移
BPE 的另一个主要成本是合并循环。旧实现每次调用都分配新内存,并为每个 pre-token 新建优先队列。v1 改为复用调用方拥有的 scratch buffer,把符号存放在平面数组里,以数组下标连接相邻符号。合并时修改连接关系,不必挪动整段数据;同时,一次模型调用可处理一个批次的 pre-token。
候选合并对还会被压入一个 64 位值,合并排名放在高位。比较两个候选项时可以直接比较整数;“此处无可执行合并”用最大值表示,以减少寻找下一个合并位置时的分支。这一节的合并优化针对 BPE,不能直接套用到所有分词算法。
基准方法比“预热”二字更重要
分词基准的设计稍有不同,就可能显著改变结果。原作者采用以下约束:
- 所有引擎使用同一计时循环,没有针对某引擎的特殊捷径。
- 词表加载单独计时,不混入 encode 时间。
- 对输出 ID 计算 FNV-1a 哈希,并要求与基准一致。
- 只用所有引擎都实际运行且通过一致性验证的共同测试单元计算中位数。
- 每次重复测量启动新进程,并保留完整的一轮测试单元。
- 把 worker 绑定到八个不同的物理核心,不把 SMT 的同胞线程当作独立物理核。
- 用独立的 Jobs 观察不同主机之间的变化。
反复编码同一文档,可能明显快于持续编码不同文档。前者能够让整个文档对应的结果都进入缓存;后者处理新输入,同时复用以前见过的 pre-token。两者有时都被称为“warm”,但代表不同负载。原文主要结论使用不同文档,而且完整语料大到无法全部放进缓存。报告自己的结果时,应写明到底是哪一种工作负载。
编译者补充:FNV-1a 是原文用于回归一致性检查的非密码学哈希;它不是用于抵御恶意碰撞的完整性或安全证明。原作者报告输出一致,不等于本稿验证了任意输入、任意平台和任意未来版本都完全一致。
原作者接下来会把更多模型家族迁入新的合并循环,目标是在 1.0.0 之前扩大支持范围。发布候选版本稳定后,再将这些改进带入 transformers 及依赖 tokenizers 的其他生态组件。原文由 tokbench 结果生成,也会随着支持范围扩展持续更新。
如何安装候选版并调用
原文称候选版本已发布到 crates.io,并给出以下安装命令。这些命令保留为历史原文,不要直接当作当前 Cargo 的通用语法:截至 2026-10-08,Crates.io 显示稳定版为 0.23.2、最新未撤回预发布版为 1.0.0-rc.2(于 2026-09-21 发布)。本次核对的 Cargo 官方 cargo-add 文档未列出 --pre 选项;文档支持以 crate@version 写法指定版本,例如 tokenizers@1.0.0-rc.2。本文仅记录来源状态,没有执行安装或构建。
cargo add tokenizers --pre按原文当时的描述,训练功能由默认开启的 feature 控制并引入 C++ 依赖,故只做编码时建议关闭默认 feature,并显式启用 HTTP:
cargo add tokenizers --pre --no-default-features --features http版本与供应链说明:原文的 --pre 用法未在当前官方命令文档获得确认,且未固定版本号;cargo add 会修改项目依赖声明,后续构建还可能获取和运行依赖的构建脚本。应在独立评估项目中审查具体解析版本和锁文件,再决定是否纳入真实应用。本稿没有运行安装、构建或模型下载。
发布版本和基准所用源码需要分别核对。结果页给出的主要编码 revision 是 tk-encode 1.0.0-rc.0 @ 199d9a13,完整源码提交为 199d9a1338b1ffe672549f4dd80be49af13fab92(2026-09-18)。Crates.io 后续发布的 tokenizers 1.0.0-rc.2 标注 edition 2024,公开的 feature 只有默认 progressbar 和可选 http、regex、unstable_wasm;manifest 不列训练 feature,tk-train 也从 workspace 排除。当前主分支是 1.0.0-dev.2,默认 feature 同样只有 progressbar。因此,原文“训练功能是默认开启的 feature,并会拉入 C++ 依赖”与可定位的 RC0、Crates.io RC2 包及当前 main manifest 不一致;不能据此认为禁用默认 feature 会移除训练实现。已发布包没有声明 Rust 最低版本,编译前需核实工具链要求。
另外,RC2 包把 HTTP 下载功能做成可选的 http feature;from_pretrained 示例需启用它。按当前 Cargo 文档和注册表版本,候选命令的写法是:
cargo add tokenizers@1.0.0-rc.2 --no-default-features --features http这条是依据官方选项和已发布 manifest 静态校对的版本写法,没有执行。它仅开启远程下载功能,不对应原文所说的默认训练 feature。Cargo 会改动项目依赖,后续构建也可能下载依赖并运行构建脚本;应先审查版本、锁文件和构建来源。
下列代码保留原作者的模型、输入及调用语义,仅修复原博客 Markdown 代码围栏和排版。注释中的 ID 与 token 字符串是原作者给出的示例输出,不是本文执行所得:
use tokenizers::tokenizer::{Result, Tokenizer};

fn main() -> Result<()> {
    let tokenizer = Tokenizer::from_pretrained(
        "deepseek-ai/DeepSeek-V4-Flash", None
    )?;
    let encoding = tokenizer.encode(
        "The tokenizer is no longer the bottleneck.", false
    )?;
    println!("{:?}", encoding.get_ids());
    // 原文示例:[671, 17840, 9160, 344, 1119, 5827, 270, 111127, 16]
    println!("{:?}", encoding.get_tokens());
    // 原文示例:["The", "Ġtoken", "izer", "Ġis", "Ġno",
    //            "Ġlonger", "Ġthe", "Ġbottleneck", "."]
    Ok(())
}
from_pretrained 在需要时会访问远端模型仓库,涉及网络、缓存及远端文件版本。示例没有固定仓库 revision,实际使用时应保存可复现的模型文件来源与版本,按组织要求处理缓存和网络权限;不要把远端配置当作已审核的本地资产。
批量编码使用 encode_batch,原文多核扩展图测的正是这个调用。下面给出可接在上例同一函数内、Ok(()) 之前的片段。与原文只使用未定义的 documents 相比,本稿补上两条输入文本,便于理解调用上下文;没有改变 API:
let documents = vec![
    "The tokenizer is no longer the bottleneck.",
    "A second document for batch encoding.",
];
let encodings = tokenizer.encode_batch(documents, false)?;
这些基准针对 Rust crate。Python 绑定从 bindings/python 构建,虽然包装的是相同核心代码,但每次调用还会增加绑定层开销;原文数字没有测量这部分开销,因此不能直接当作 Python 应用的端到端提速比例。
发布候选版已经完成哪些工作
原文把当前候选版、1.0.0 目标和之后的探索明确分开。候选版已完成:
- 拆分
tk-encode、tk-serialize、tk-convert和tk-train。 - bitcannon 覆盖 GPT-2、cl100k、o200k、Tekken 和 DeepSeek,替代最初发布的有限状态机实现,见 #2201、#2317。
- WordCache 复用已处理 pre-token 的 ID,见 #2262 及原文列出的提交
af5a3e3。 - 加入 FlatCache、MPHF RankStore、增量合并和 BucketVocabStore 等结构,见 #2190、#2188。
- 临时模型状态移入可复用缓冲区,见 #2175、#2183。
- 以
STAGE_POST暴露 pipeline 后处理阶段,见 #2182。 - 一个模型调用处理多个 pre-token 区间,见 #2304。
- 加速解码:把字节直接写入复用缓冲区,减少中间字符串与复制,加快 token 查找,支持带缓冲的流式处理和并行批量解码。
- 加入
role_to_token支持,见 #2343,以及 Node.js 绑定,见 #2281。
结果页补充,WordPiece 获得双数组 trie、零分配编码路径和共享词缓存;Unigram 也使用减少分配的 pipeline 与词缓存。它们的加速幅度小于 BPE,是作者后续重点。
1.0.0 与后续路线图
原文列为 1.0.0 待完成的工作包括:在训练验证中使用 tk-encode,统一训练与推理的编码实现;仅在请求时计算 offsets、masks 等元数据;重构 normalizer;基于 atomnorm 加入 bitnorm(#2209);支持原文所列的 spm precompiled;简化 Python 绑定中的锁、包装类型和手写分派,同时保留子类化、序列化、自定义 decoder、可变行为和 free-threaded CPython 支持;为 ExecuTorch 和 llama.cpp 提供仅推理的 C/C++ 绑定,之后可能继续提供 JVM、Swift 和 Go 绑定。
1.0.0 之后的探索是 tok-devices:让文本与 token ID 留在设备上,研究 GPU 编码和批量解码。设想中的 decoder 只上传一次词表,在 GPU 上并行计算输出位置并收集对应字节。它将是面向大批次的可选组件,仍需原型与测量,不能视为当前已有的 GPU 加速能力。
整体提升来自多个位置上工作的减少:已知模式的专用切分器、重复片段的缓存、减少分配的合并循环,以及批次级模型调用共同作用。判断它是否能解决自己的瓶颈,需要把模型家族、文本语言、重复率、线程组织和绑定开销一起放回实际工作负载。
来源、署名与许可边界
原文:Hugging Face Blog,Arthur Zucker、Simon Brandeis、Luc Georges、Lysandre,2026-09-21;公开 Markdown 源稿;原作者交互结果页。文章页面及公开博客仓库未显示适用于整篇博客或缩略图的开放许可;本译稿与缩略图使用依据另行取得的许可,不据此推定它们为开放许可。
逐项归属与许可说明见下文“归属与许可范围”附录。随附的 LICENSE-APACHE-2.0.txt 提供 tokenizers / tokbench 软件代码的 Apache-2.0 许可证全文;该许可证不扩展至博客文字、原文缩略图或交互结果页。tokbench 与 tokenizers 仓库根目录的 NOTICE 查询均未找到 NOTICE 文件。本稿仅作静态审阅;未安装、编译或运行代码,未下载模型/语料,也未运行基准。没有对完整依赖或仓库作全面安全审计。
Attribution and license scope
Article and original thumbnail
- Source article: “tokenizers v1: encode, decode and scaling, measured,” by Arthur Zucker, Simon Brandeis, Luc Georges and Lysandre; Hugging Face Blog, published 2026-09-21.
- The original article page and the checked public blog repository did not identify an open license for the article text or thumbnail. This translation and the source thumbnail are used with separately obtained permission. That permission is not an open license.
- The thumbnail is
assets/original/tokenizers-v1-thumbnail.png, reproduced byte-for-byte from the article thumbnail. Its original size is 1804×760 pixels; it was not cropped or altered.
Software code
LICENSE-APACHE-2.0.txtis the full Apache-2.0 license supplied by both the tokenizers repository and tokbench repository. The same license text is used by both projects.- The Apache license applies to the respective software code, not to the Hugging Face Blog article, its thumbnail, or its interactive results page.
- Root
NOTICEprobes for both repositories returned 404. The candidate does not invent or add a NOTICE file. - Benchmark corpora are licensed per corpus. The public
agentic-sweconfig is marked MIT in the tokbench corpora card. Other datasets may have different terms;code-mixed,agentic-tracesand some other corpora are explicitly excluded from public redistribution.
Original technical illustration
assets/tokenizers-pipeline.png is the pre-existing self-drawn diagram supplied with the draft. It is not a source-page screenshot or a benchmark plot. Its labels and layout describe the processing stages; width, position and arrows do not encode performance values.










暂无评论内容