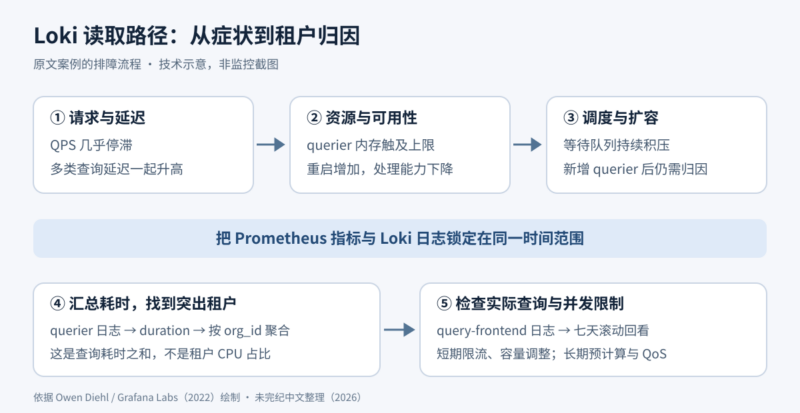



一次 Loki 读取路径排障:从查询拥塞找到抢占资源的租户
原作者:Owen Diehl,Grafana Labs。原文发表于 2022 年 1 月 25 日:A (de)bug’s life: Diagnosing and fixing performance issues in Grafana Loki’s read path。本文为获授权的中文翻译整理,技术核对日期为 2026 年 10 月 9 日。
版本说明:这是一次历史事故的排查记录。文中的仪表盘、日志字段、组件标签和配置项属于作者当时的环境,使用前应与自己的 Loki 版本和部署方式核对。下文涉及的故障现象、扩容效果及“98%”均来自原作者记录;本文没有连接集群,也没有执行查询。标有“编者注”的段落是本次整理补充。
“哔,哔,哔——读取路径的 SLO 告警又响了,而我差一点就能找到那个抢占资源的邻居!”这正是作者当时的处境,未来也可能再次遇到。随着 Grafana Labs 负责构建和运行 Loki 的团队不断扩大,他决定记录自己发现与诊断问题的方法:把排查过程中反复出现的模式写下来,也让同事,以及在公司、家中或其他地方运行 Loki 的用户,能够借鉴这些经验。
这篇文章复盘的是 Grafana Cloud Logs 的一次真实调查。思路是先用指标缩小方向,再用日志验证推断。案例中的 Loki 运行在 Kubernetes 集群里,一个租户消耗了过多资源,导致其他租户的查询一起变慢。排障使用 Grafana 仪表盘、Prometheus 和 Loki。
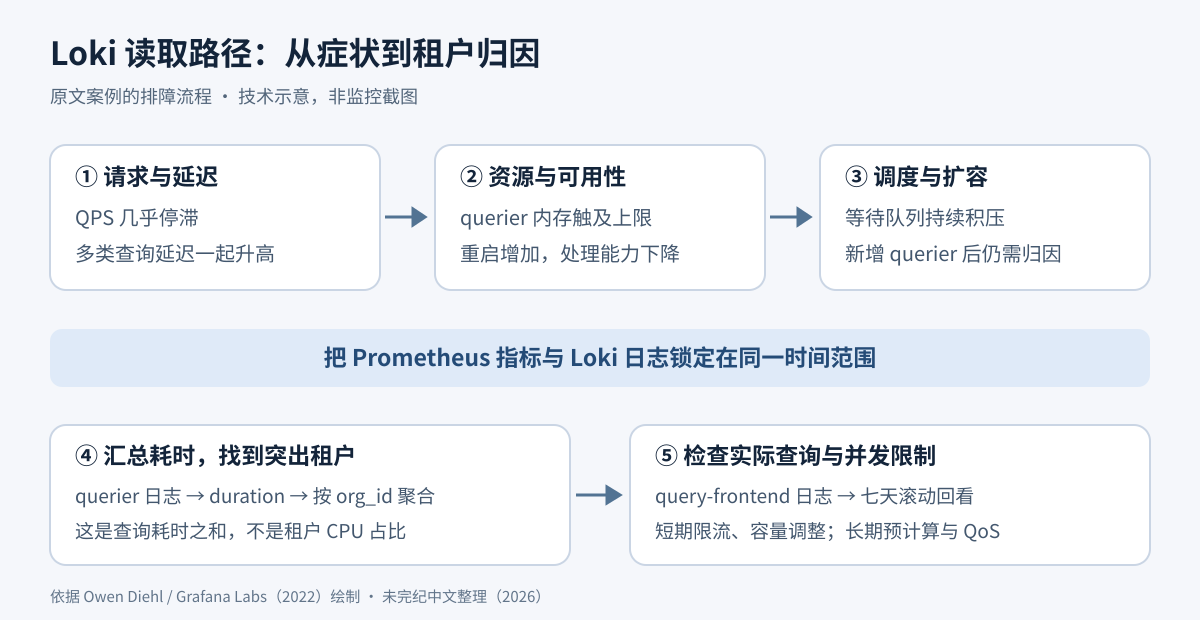
先分辨:请求失败了,还是变慢了?
收到告警后,第一件事是判断问题类型:请求究竟能否完成,还是只是非常慢?大量 HTTP 5xx 与慢查询的严重程度不同,因此作者先从请求结果与延迟入手。
他打开 loki-mixin 提供的 Loki / Reads 仪表盘。原文图中有一段时间,成功处理的查询每秒速率(QPS)几乎停滞,同时查询延迟陡增。这让作者怀疑读取路径发生了拥塞:请求在排队,真正开始执行的查询也变得很慢。各类查询的延迟都一起升高,进一步支持了“querier 数量不足,或者 querier 已经超载”的判断。
接下来,他切换到同样由 loki-mixin 提供的 Loki / Reads Resources 仪表盘查看资源用量。出问题的时间段内,querier Pod 的内存一下子冲到了上限。再到 Loki / Operational 仪表盘查看,就能看到许多 querier 随之重启。
情况因此进一步恶化。作者此时已经很有把握:读取路径被代价很高的查询占满,这些查询又使 querier 因内存不足而重启;在 querier 恢复前,其他租户也无法使用这些资源。随后,query scheduler 中等待执行的查询越来越多。
编者注:上述因果判断属于原文事故分析。将方法用于新集群时,应同时核对 Pod 终止原因、OOM 事件与时间顺序。单独看到“重启次数上升”并不能证明每一次重启都是内存耗尽。
先缓解拥塞:增加读取路径容量
既然症状表现为拥塞,眼前可以采取什么措施?等待队列已经积压,扩展读取路径,尤其是增加 querier 数量,是合理的短期动作。更多 querier 可以提高这个 Loki 集群的查询处理能力,有望分担一部分负载。
不过,作者增加若干 querier 后,再看同一组仪表盘,问题并没有消失:成功处理的 QPS 没有改善。就像高速公路增加了车道,能通过的车辆却没有变多,这说明前方仍存在堵塞。
作者于是怀疑某个租户提交了绕过当时“吵闹邻居”控制的查询。但在多租户环境中,并不能直接把每一点 CPU 和内存用量都准确分配给某个租户,应该从哪里找起?
把指标和日志对齐到同一时间范围
先在 Grafana 仪表盘中选择 Prometheus 指标异常的时间区间,然后通过 Explore 保留这个时间范围。接着,保持起止时间一致,把数据源切换到 Loki,从该时段的 querier 日志中提取统计信息。这样,日志能够回答一个明确的问题:哪些租户占用了集群读取路径里最多的处理时间?
原文使用的 LogQL 查询如下,<cluster> 和 <namespace> 需要换成待排查环境的实际标签值。
# 哪些租户占用了最多的读取路径处理时间?
topk(10, sum(sum_over_time(
{cluster="<cluster>", namespace="<namespace>", container="querier"}
  |= "metrics.go"
  | logfmt
  | unwrap duration(duration)
  [5m]
)) by (org_id))
这段查询先选择 querier 日志,再保留包含 metrics.go 的记录,用 logfmt 解析字段,最后把 duration 字段转换成秒数。在每个五分钟窗口内,sum_over_time 对查询耗时求和;外层 sum ... by (org_id) 把各日志流按租户合并,topk(10, ...) 选出耗时最高的十个租户。
原文展示的结果中,一个租户明显高于其他租户;图中的租户标识已被作者隐去。这里统计的是日志记录中的查询耗时总和,并非直接测得的租户 CPU 时间、内存字节数或独占资源占比。并发执行的请求耗时可以重叠,因此总和也可能超过窗口本身的时长。
编者注:解析错误处理。原查询没有显式过滤解析或转换错误。当前 LogQL 指标查询文档说明,转换失败会附加 __error__ 标签。若日志格式并不完全一致,可在 unwrap 后加入错误过滤,写成下面的整理版。与原文相比,仅新增 | __error__="" 并调整排版;这会丢弃失败记录,不能据此把不完整日志当作完整统计。
topk(
  10,
  sum by (org_id) (
    sum_over_time(
      {cluster="<cluster>", namespace="<namespace>", container="querier"}
        |= "metrics.go"
        | logfmt
        | unwrap duration(duration)
        | __error__=""
      [5m]
    )
  )
)
从租户回到具体查询
找到突出的一方后,作者进一步查看 query-frontend 的日志,填入集群、命名空间及该租户的标识,查清它到底在执行什么。
{cluster="<cluster>", namespace="<namespace>", container="query-frontend"}
  |= "metrics.go"
  | logfmt
  | org_id="<offending_tenant>"
日志显示,该租户执行了许多代价高昂、回看时间特别长的查询。原文给出的典型形态是:
quantile_over_time(
  0.99,
  {foo="bar"} | json | unwrap duration(response_time) [7d]
)
该示例保留原文含义,仅把网页中的弯引号规范为 LogQL 可使用的直引号并重新排版。它是用于说明事故原因的昂贵查询示意,不应直接拿到生产集群里复现负载。
在作者当时的实现与配置下,Loki 会按时间拆分查询,但每个结果数据点都仍然需要处理此前七天的数据。其中相当多的数据会反复参与计算。即使把整个查询分成约三十分钟一段,每一段也仍然需要取得它所对应的七天回看窗口内的日志。
因此,“把查询时间区间拆小”并不自动等于“把每个计算窗口也缩小”。这里真正昂贵的是七天的滚动回看,再叠加大量并行工作。作者由此找到了本次事故的根因。
短期缓解与长期改进
原文给出的短期措施有三项:
- 增加读取路径容量,减轻当前拥塞。
- 调低问题租户的
max_query_parallelism,限制它同时调度的查询数量,把更多读取资源留给其他租户。 - 建议该租户为周期性执行的昂贵查询使用 recording rules(记录规则),避免每次临时查询都重复做同样的重计算。
长期措施则包括继续扩展读取能力,为读取路径增加更细致的观测手段,研究更有效的昂贵查询并行方式,尤其是长区间查询,以及改进 QoS(服务质量)控制,使集群繁忙时单个租户更难占用超出合理份额的资源。作者在这次调试后提交了 Querier worker/inflight metrics,PR #5124,补充相关指标和日志,以便更快判断饱和度并按租户分析。
编者注:不要照搬 2022 年的配置结论。2026 年 10 月 9 日查阅的 Loki 配置参数文档将 max_query_parallelism(默认 32)用于非 TSDB schema,并为 TSDB schema 单列 tsdb_max_query_parallelism(默认 128)。这些是当前文档列出的默认值,实际限制仍须结合部署版本、索引 schema、租户覆盖配置和调度方式核对。原文约“三十分钟切分”是当时案例参数,不能当作当前产品的通用默认值。扩容和限流是否有效,应回到相同指标与时间范围核查,而不能只看实例数量增加了多少。
再加一个查询:慢查询到底归因于谁?
原作者在结尾感谢读者,并坦言,记录问题及解决过程比预想中困难,但希望这些思考方式能帮助别人更快定位日志系统的问题。他还留下了一个用于租户归因的查询:统计一小时内,执行时间超过十秒的 instant query 中,各租户分别占多少比例。
下面保留原查询的计算逻辑。整理差异:原文写死的生产集群与 query-frontend job 标签已替换成显式占位符,避免误把作者的环境配置当作通用值;统计阈值与窗口仍是原文的 10s 和 1h。
sum(
  count_over_time(
    {cluster="<cluster>", job="<query_frontend_job>"}
      |= "metrics.go"
      | logfmt
      | range_type="instant" and duration > 10s
    [1h]
  )
) by (org_id)
/ on () group_left
sum(
  count_over_time(
    {cluster="<cluster>", job="<query_frontend_job>"}
      |= "metrics.go"
      | logfmt
      | range_type="instant" and duration > 10s
    [1h]
  )
)
* 100分子是各租户满足筛选条件的日志条数,分母是同一筛选条件下的全部日志条数;on () group_left 让多个租户序列与汇总后的单个总量序列匹配。结果表示全部超阈值 instant query 中,各租户的占比,并不是“某租户自己的查询有多少比例超时”,也不是所有查询的 SLO 达标率。
作者曾借此发现,一个租户贡献了某一小时内 98% 的超 SLO instant query。这是原文报告的历史结果,不代表本文进行了重放,也不保证在其他部署中出现相同分布。若分母为零或窗口中没有数据,结果不应解释为一个有意义的百分比;十秒阈值同样必须换成实际采用的 SLO 定义。
使用这些查询前,保留必要的边界
本文的查询均作了静态阅读与来源对照,没有执行测试。示例中未发现真实密钥,也没有 shell 命令或数据删除操作;不过,长窗口、大基数查询本身会消耗读取资源。应先在小时间窗口和必要的流选择器范围内确认日志格式,避免排障查询进一步加重拥塞。
租户标识和完整查询文本可能包含敏感业务信息。只在已授权的运维范围内查看;导出图表或转发日志时应保留原文隐去租户标识的做法。若把标签值接入自动化查询生成器,要使用符合 LogQL 语法的转义方式,不能把不受信任的输入直接拼接进查询。此处是对二次集成的审查提醒,原文并未提供一个存在注入漏洞的查询生成器。
本文覆盖原文引言、问题识别、即时处置、租户追踪、缓解措施及结尾补充查询。原文最后的 Grafana Cloud 商业推广和当时免费额度属于历史营销信息,未作为当前产品承诺转载。原作者和来源归属保留;本中文译文与整理以及原创配图已另行获得转载授权。所读取的博客正文未列明独立的文章开放许可证;Loki 软件许可证不延伸适用于博客全文。










暂无评论内容