


处理 Polars 中的模式问题
译自 Thijs Nieuwdorp 发表于 Polars Blog 的 Handling Schema Issues in Polars(2026-04-30)。本文依次讨论字段和类型的变化,以及 CSV、Parquet、Delta Lake、Apache Iceberg 对这些变化的处理方式。
先判断发生了哪一种模式变化
数据源的结构会随时间变化。处理之前,先区分变更类别,因为“自动兼容”可能指截然不同的动作:
- 新增字段:新数据多出一列。旧记录没有这个值,系统通常以 null 表示;是否有业务默认值需要另行决定。
- 字段缺失:本批输入不再提供某一列。它可能是合法的稀疏数据,也可能意味着上游停止输出,不能一概而论。
- 类型漂移:同一列出现不同类型,例如原先都是整数,后来出现浮点值、日期或字符串。转换可能失败、丢失精度或产生 null。
- 重命名或语义变化:列名改了、单位改了,或同一类型承载了不同含义。仅按列名和物理类型自动对齐无法安全推断这种变化。
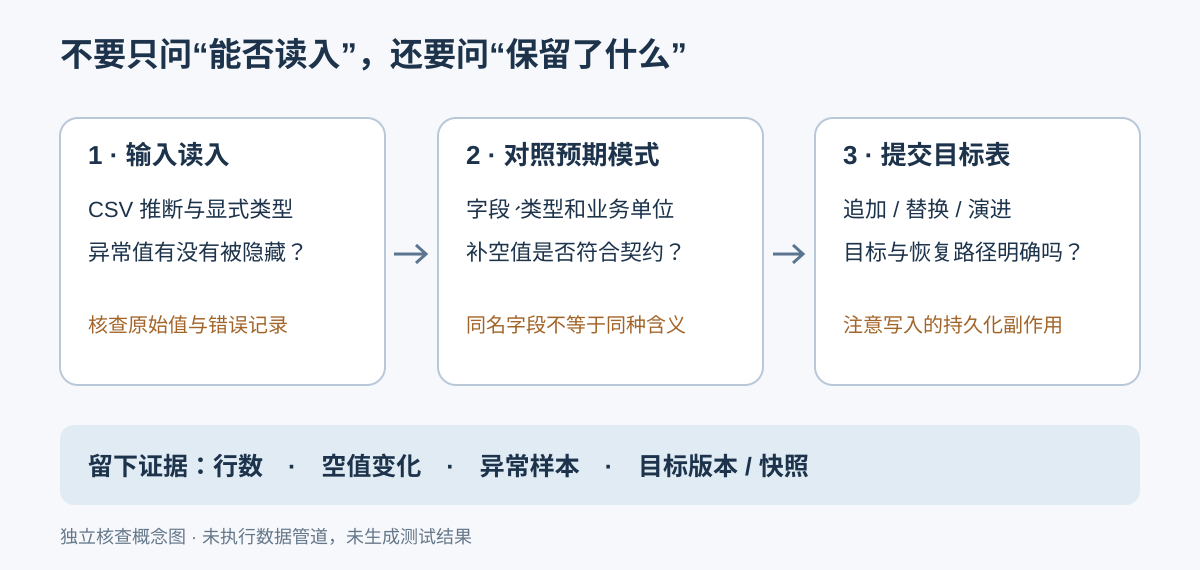
应将“观察到什么变化”与“业务允许程序怎么处理”分开记录。插入 null、忽略列、提升类型、改名和覆盖表都是不同的模式决策,不应只为让作业继续运行而默认放宽。
| 变化 | CSV | 多文件 Parquet | Delta Lake | Apache Iceberg |
|---|---|---|---|---|
| 新增列 | CSV 无类型元数据;由字段契约或逐列覆盖处理 | 声明超集 schema,并为旧文件插入缺失列 | 审查后使用 schema_mode=merge | 通过 catalog 执行 update_schema |
| 缺失列 | 检查源文件和预期契约 | missing_columns=insert,补 null | schema_mode=merge 可让新行缺列为 null | 以字段 ID 读取当前表模式 |
| 类型漂移 | schema_overrides 或明确解析 | 安全上推或 diagonal_relaxed | 写入前显式转换 | 仅支持兼容的类型扩宽;其余显式转换 |
| 重命名或语义变化 | 显式映射和转换 | 显式映射和转换 | 显式映射和迁移 | 字段 ID 可承载改名;语义变化仍要人工定义 |
CSV:推断有限,类型契约要显式表达
CSV 不在文件内部记录列类型。Polars 必须根据列名和样本行推断模式;如果样本里某列看起来全是整数,后面的行才出现文本,读取便可能报类型错误。增加 infer_schema_length 可以扩大推断样本,但不能替代对上游契约的定义。
对于已知的列类型,可用 schema_overrides 按名称为部分列指定类型,不依赖其他列的顺序。完整的 schema 则要为所有列提供类型,并且必须与 CSV 中的列顺序相匹配。若先把值读为字符串(infer_schema=False),可以在检查原始值后再执行显式转换;这适合需要保留异常输入以供诊断的场景。
ignore_errors=True 会跳过部分解析错误并可能把有问题的值变成 null。它能让读取继续,却可能悄悄丢失数据。启用前应决定如何统计、保存和处置这些异常值。标识符、邮编、带前导零的编码等字段即使只含数字,也往往应保持字符串语义。
读取阶段说明:read_csv 是立即执行的读取接口,读取或解析问题会在调用过程中暴露;只有使用惰性扫描接口(如 scan_csv)时,执行才会推迟到收集结果的阶段。不要把惰性执行的错误时机套用到立即读取的示例上。
多个 Parquet 文件:文件顺序可能影响推断结果
Parquet 文件有各自的模式。扫描由 glob 匹配的一组文件时,第一个文件可能决定初始模式,因此文件枚举顺序会影响后续文件能否兼容。若新文件增加列,而旧文件没有该列,可以显式提供预期的完整模式并启用缺失列插入,让旧文件对应值补为 null;若不声明完整模式,往往需要确保首先读取包含预期字段集合的文件。
反过来,如果后续文件有额外字段,忽略这些列会使扫描继续,但内容会被丢弃。只有确认额外字段不需要保留时才这么做。对多个 LazyFrame 做拼接时,vertical 要求列结构兼容;vertical_relaxed 会尝试把类型提升到共同类型;diagonal 按列名对齐并为缺失列补 null;diagonal_relaxed 同时做列对齐和类型协调。选择哪一种仍是数据契约的决策。
Polars 的扫描选项还提供按类型配置转换的设置;部分 ScanCastOptions 接口被标记为不稳定。其选项会随版本变化,本文在后文列出 2026-10-09 查阅到的现行稳定文档选择;当前 scan_parquet 的 schema 与 cast_options 也标记为不稳定,升级时应以锁定版本重新核对精度、时区和结构体边界。
Delta Lake:显式区分模式合并与覆盖
Delta Lake 将事务日志与数据文件结合,默认会严格检查写入模式。通过 Polars 写入 Delta 时,schema_mode="merge" 可处理可兼容的字段增加或减少:新行没有旧字段时相应值可为空,新增字段也会加入表模式。字段重命名或不兼容类型变化通常需要先明确转换、重命名或迁移策略,而不是指望合并自动猜测。
不要把 schema 合并与数据覆盖混为一谈。写入模式 mode="overwrite" 会替换目标表数据;模式参数 schema_mode="overwrite" 则允许用新的模式替换现有模式,可能移除原字段。两者都需要核对目标路径、备份和恢复方式。自动重试也可能造成重复写入,必须结合事务标识或作业幂等设计验证。
Apache Iceberg:用字段标识支持表演进
Iceberg 在表元数据中维护字段 ID,使字段名改变后仍可识别逻辑字段;目录(catalog)追踪表当前元数据位置。原文用本地 SQLite 目录演示概念,适合本机实验;生产系统应使用与组织环境相符的 Hive、Glue、REST 等目录服务,并考虑并发提交、凭据和权限。
在两次写入之间通过表的 schema 更新操作(例如 table.update_schema())增加字段、重命名或扩大兼容类型。模式演进通常只更新元数据,不需要重写所有数据文件;已有行读取新增字段时会得到 null。读取器从目录找到当前快照和模式,因此使用者需要刷新或重新打开表,才能看到后续提交。对不兼容类型变化,仍应设计明确的数据转换流程。
把处理规则变成可审查的契约
每次接入最好把下列决定写进作业配置和审查记录:允许的字段增加与删除、空值含义、类型提升是否可接受、转换后的精度边界、未知字段如何处置,以及目标表采用追加、模式合并还是整体替换。将这些规则与 Polars 版本、存储格式和目录服务一起固定,才能复现问题并安全升级。
一种实用选择顺序是:先拒绝无法解释的语义变化;对已确认的兼容字段变化显式补 null 或做无损类型提升;需要保留未知字段时按名称对齐;任何忽略或覆盖操作都要有数据所有者批准、目标核对和恢复方案。
把参数放回具体情形中
下面的片段对应原文的处理方式,展示 API 的组合关系。它们只作为阅读材料,未执行;涉及写入的路径必须改成一次性临时目录,并先核对当前 Polars、Delta Lake 与 Iceberg 版本。
CSV 的四种选择
import polars as pl

# 只覆盖已知问题列的推断;其余列仍自动推断
df = pl.read_csv("sales.csv", schema_overrides={"price": pl.Float64})

# 完整模式必须按文件列的出现顺序声明
df = pl.read_csv("sales.csv", schema={"id": pl.Int64, "price": pl.Float64})

# 陌生文件先全部读作字符串,之后再检查并显式转换
df = pl.read_csv("sales.csv", infer_schema=False)

# 谨慎使用:不匹配模式的值将成为 null
df = pl.read_csv("sales.csv", ignore_errors=True)
原文的示例文件共有 150 行:前 100 行让 price 被推断为 Int64,第 101 行出现 10.50,于是整数解析失败。明确指定 Float64 后,该列以浮点数读取(例如第 1 行为 10.0、第 101 行为 10.5)。原文把此异常写作 collect 时出现;但展示调用是立即执行的 read_csv,实际应在读取/解析阶段报告。只有惰性扫描才会把执行推迟到 collect。
| 原文示例输出字段 | 第 1 行 | 第 101 行 | 第 150 行 |
|---|---|---|---|
| id | 1 | 101 | 150 |
| price(Float64) | 10.0 | 10.5 | 1500.0 |
原文样例总形状为 150 行、2 列;上表保留了原文展示的首行、发生类型漂移的行和末行。
Parquet 的新增、缺失与类型漂移
文件 glob 的初始预期模式由 Polars 首先遇到的文件决定。若 2023 文件只有 id,value,2024 文件增加 category,默认扫描会报额外列错误。extra_columns="ignore" 可丢弃新列;需要保留时,声明超集模式并为早期文件插入 null:
schema = {"id": pl.Int64, "value": pl.Int64, "category": pl.String}
df = pl.scan_parquet(
    "events_*.parquet",
    schema=schema,
    missing_columns="insert",
).collect()
反过来,若文件组中的第一个文件已经含有 category,随后文件缺少此列,可只指定 missing_columns="insert";若哪个文件先出现不可控,就提供完整超集 schema。缺失列会在这些行上补 null。忽略额外列和补缺失列都改变数据结果,选择前要确认字段是否可丢弃、null 是否有正确业务含义。
若业务明确决定丢弃新字段,原文示例使用以下选项:
df = pl.scan_parquet(
    "events_*.parquet",
    extra_columns="ignore",
).collect()
该设置会丢弃扫描中出现的额外列;保存前应验证数据契约与字段所有者的决定。
对缺少列的文件组,可只启用插入缺失列:
df = pl.scan_parquet(
    "events_*.parquet",
    missing_columns="insert",
).collect()
整数类型仅做无损上推时,可使用以下惰性扫描。若首个文件是 Int64、后续为 Int32,后者可上推;若首个是 Int32 而后面是 Int64,则需要向窄类型收窄,可能丢值,因此会拒绝:
df = pl.scan_parquet(
    "events_*.parquet",
    cast_options=pl.ScanCastOptions(integer_cast="upcast"),
).collect()
截至 2026-10-09 查阅的 Polars stable API,ScanCastOptions 仍标记为 unstable,参数可在不构成破坏性变更的情况下调整。当前文档所列可选值如下;升级前按锁定版本重新核对:
| 参数 | 当前文档列出的选择 | 需要留意 |
|---|---|---|
| integer_cast | upcast、allow-float、forbid | allow-float 会把整数转为浮点数;评估精度边界 |
| float_cast | upcast、downcast、forbid | downcast 可能损失精度 |
| datetime_cast | nanosecond-downcast、microsecond-downcast、microsecond-upcast、millisecond-upcast、downcast、upcast、convert-timezone、forbid | 精度变化或时区转换须符合业务语义 |
| missing_struct_fields | insert、raise | 插入的字段值为空 |
| extra_struct_fields | ignore、raise | ignore 会丢弃字段信息 |
| categorical_to_string | allow、forbid | 转换须符合下游契约 |
上表来自当前稳定版 API 页面;原文发表于 2026-04-30,其选项摘要与现行文档存在细节差异。不同 Polars 版本的行为应以实际安装版本文档为准。
若文件顺序不可控,或要同时容忍字段差异和类型漂移,可逐个扫描并按名称对齐:
import glob

lfs = [pl.scan_parquet(f) for f in glob.glob("events_*.parquet")]
df = pl.concat(lfs, how="diagonal_relaxed").collect()
原文用两组 LazyFrame 演示:一组的 value 为 Int32 且没有 category,另一组 value 为 Int64 且有 category;结果把 value 提升为 Int64,并给前一组的 category 补 null。四种拼接策略的规则是:vertical 要求列和类型都一致;vertical_relaxed 要求列一致但把类型协调为共同超类型;diagonal 按列名对齐并补 null、但类型须一致;diagonal_relaxed 同时按名称补列并协调类型。它对文件顺序不敏感,但自动提升仍须核验语义。
| 拼接模式 | 列结构 | 类型 |
|---|---|---|
| vertical | 必须一致 | 必须一致 |
| vertical_relaxed | 必须一致 | 协调到共同超类型 |
| diagonal | 按名称对齐,缺失值补 null | 必须一致 |
| diagonal_relaxed | 按名称对齐,缺失值补 null | 协调到共同超类型 |
| id | value | category |
|---|---|---|
| 1 | 10 | null |
| 2 | 20 | null |
| 3 | 30 | x |
| 4 | 40 | y |
原文示例的结果模式为 4 行、3 列:旧文件缺失的 category 补 null;新文件保留 x 和 y。
Delta Lake 的追加、合并和整体替换
Delta 的模式记录在与 Parquet 数据文件并列的 JSON 事务日志中;每次 write_delta 或 sink_delta 写入都会更新日志。默认严格模式下,新增或缺失字段会让追加失败。原文先建立含 id,value 的表,再写入额外带 source 的批次,默认产生字段数不匹配错误。允许经审查的新增字段时,合并模式会保留新字段,并让旧行的该字段为 null:
import polars as pl

initial = pl.DataFrame({"id": [1, 2], "value": [10, 20]})
initial.write_delta("events_delta")

new_batch = pl.DataFrame({
    "id": [3, 4], "value": [30, 40], "source": ["web", "app"]
})
new_batch.write_delta("events_delta", mode="append")
# Strict default: the differing column count raises SchemaMismatchError.

new_batch.write_delta(
    "events_delta",
    mode="append",
    delta_write_options={"schema_mode": "merge"},
)
原文的合并示例输出模式为 4 行、3 列:
| id | value | source |
|---|---|---|
| 1 | 10 | null |
| 2 | 20 | null |
| 3 | 30 | web |
| 4 | 40 | app |
同一设置也用于输入批次缺少表中已有字段的情形。原文构造了不含 source 的批次并继续追加:
slim_batch = pl.DataFrame({"id": [5, 6], "value": [50, 60]})
slim_batch.write_delta(
    "events_delta",
    mode="append",
    delta_write_options={"schema_mode": "merge"},
)
新写入行缺少该字段时会填为 null。原文示例将第五、六行追加到同一表后输出 6 行、3 列;新行的 source 均为 null:
| id | value | source |
|---|---|---|
| 1 | 10 | null |
| 2 | 20 | null |
| 3 | 30 | web |
| 4 | 40 | app |
| 5 | 50 | null |
| 6 | 60 | null |
重命名和不兼容类型变化须在写入前显式处理。原文的完整表替换示例同时指定 mode="overwrite" 与 schema_mode="overwrite":
replacement = pl.DataFrame({"product": ["x", "y"], "count": [100, 200]})
replacement.write_delta(
    "events_delta",
    mode="overwrite",
    delta_write_options={"schema_mode": "overwrite"},
)
这会用不同列(例如 product、count)替换目标表及其模式,是破坏性操作。真实作业必须先核对目标、备份和恢复流程。
Iceberg 用 catalog 处理模式演进
Iceberg 示例先建一个 SQLite 支持的本地 SqlCatalog,在 db.events 中创建 id、value 两个字段,再追加三行。随后在两次写入之间调用 table.update_schema() 加入 category,然后追加带新字段的两行。按字段 ID 解析后读取结果有五行三列,前三行的 category 为 null,后两行为 A 和 B。这里的数据目录与仓库路径属于原文本地实验设置,不表示生产服务推荐使用本地 SQLite。
import polars as pl
from pyiceberg.catalog.sql import SqlCatalog
from pyiceberg.schema import Schema
from pyiceberg.types import NestedField, LongType, StringType

catalog = SqlCatalog(
    "default",
    **{"uri": "sqlite:///catalog.db", "warehouse": "file:///data/warehouse"},
)
catalog.create_namespace("db")
schema = Schema(
    NestedField(1, "id", LongType()),
    NestedField(2, "value", LongType()),
)
table = catalog.create_table("db.events", schema=schema)
pl.DataFrame({"id": [1, 2, 3], "value": [10, 20, 30]}).write_iceberg(table, mode="append")

with table.update_schema() as update:
    update.add_column("category", StringType())
pl.DataFrame({"id": [4, 5], "value": [40, 50], "category": ["A", "B"]}).write_iceberg(table, mode="append")

df = pl.scan_iceberg(table).collect().sort("id")
print(df)
原文示例读取结果:
| id | value | category |
|---|---|---|
| 1 | 10 | null |
| 2 | 20 | null |
| 3 | 30 | null |
| 4 | 40 | A |
| 5 | 50 | B |
Iceberg 的 catalog 记录表名到当前模式和快照文件清单的映射。字段 ID 不随列名或位置变化;加列、改名或无损扩宽类型时,既有数据文件不重写,读取端从当前快照解析字段。Iceberg 能自动处理这些兼容演进,不代表它会猜测字段语义;不兼容类型仍须在写入前显式转换。










暂无评论内容