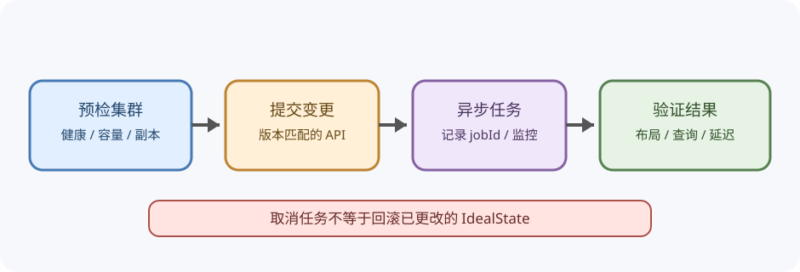



在扩缩容前预检 Pinot 分段再平衡
来源:Apache Pinot 官方运维文档《Rebalance Servers》及同系列《Examples and Scenarios》。文档页面未标个人作者;维护方为 Apache Pinot 项目。当前页面是滚动更新的 latest 文档,没有固定发行版号;2026-10-08 查阅的官方发布策略将 1.5.1 列为稳定版本。该指南横跨多个 API 年代,运行前请按部署的 Controller API 版本复核。
Pinot 的 rebalance 不是单一命令,而是一组状态变更和分段迁移步骤。常见触发原因包括增加或移除服务器、调整表的副本数、改变分段分配策略,以及把表迁移到其他 tenant。它会修改 IdealState 并移动数据,因此开始前应先检查集群状态、容量、副本与查询可用性。
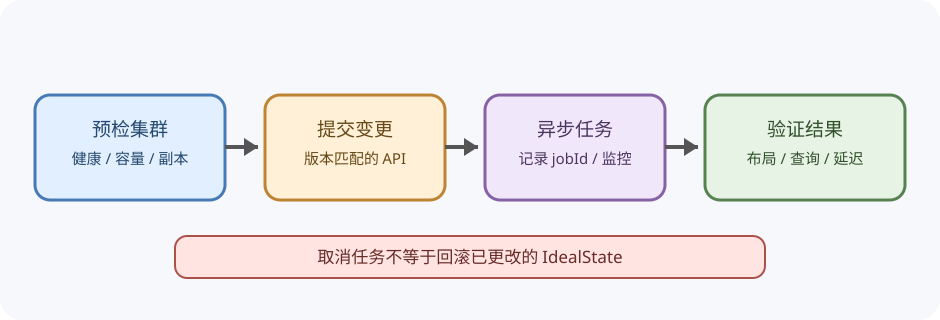
先理解 tenant tag 与分配范围
服务器按 tag 分组,同一 tag 形成 server tenant。新加服务器默认会有 DefaultTenant_OFFLINE 和 DefaultTenant_REALTIME 标签。表配置中的 tenants.server 决定哪些服务器承载该表。
{
  "tableName": "myTable_OFFLINE",
  "tenants": {
    "broker": "DefaultTenant",
    "server": "DefaultTenant"
  }
}
原文的 ZooInspector 截图用于示意 ZooKeeper 中的标签节点;图中的关键默认值已在这里逐项写明。当前候选不复用该截图,也不以流程图代替它。有关图片无法读取的细节见随附核验记录。
变更标签与停止新查询路由
Pinot 0.6.0 及更新版本可用以下 API 更新 server tags;0.5.0 及更早版本没有 updateTags API,需要使用实例更新接口及对应请求体。老版本与新版本的请求结构不同,执行前需核对目标版本文档。
PUT /instances/{instanceName}/updateTags?tags=<comma-separated-tags>PUT /instances/{instanceName}
Content-Type: application/json
{"host":"10.1.10.51","port":"7000","type":"SERVER",
"tags":["newName_OFFLINE","DefaultTenant_REALTIME"]}原文特别提醒:旧版 GET 返回结构与 PUT 请求体并不相同;实例名 Server_host_port 需要拆成独立字段。不要把 GET 输出原样回传给旧版 PUT。
维护服务器前,可以暂时停止 broker 将新查询路由到该 server;这不会关闭 Helix participant,已经路由的查询仍可能继续。
PUT /instances/{instanceName}/state?state=QUERIES_DISABLE
PUT /instances/{instanceName}/state?state=QUERIES_ENABLE
迁移表到另一个 tenant 时,应同时检查 OFFLINE 和 REALTIME 表配置,并在计划中把 reassignInstances 设为 true。
选择分配算法
默认算法会在 reassignInstances=true 时重新计算实例列表,再按分区与副本组排序。最小数据移动算法则尽量保留仍存活实例的位置,只把空位填给新实例,减少分段迁移。可在 TableConfig 的 replicaGroupPartitionConfig.minimizeDataMovement 或 segmentsConfig.minimizeDataMovement 中启用;rebalance 参数也可选择 ENABLE、DISABLE 或 DEFAULT。
重平衡前的计划结果通常能显示服务器增删、迁移分段数量、预计数据量和副本变化。status=NO-OP 表示表已平衡,没有新的分配变化。
先做 dry run,再提交重平衡
主要入口是 POST /tables/{tableName}/rebalance?type=OFFLINE 或 REALTIME。dryRun=true 只计算预期分配;preChecks=true 只能与 dryRun=true 一起使用。检查通过、审阅数据移动量与副本影响后,再考虑执行真实变更。
POST /tables/{tableName}/rebalance?type=OFFLINE&dryRun=true&preChecks=true关键参数与原文默认值如下。其他时间间隔、重试和 force commit 参数也属于版本化 API,使用前应查目标版本的完整参数表。
| 参数 | 默认值 | 影响与风险 |
|---|---|---|
| dryRun | false | 只计算预期 IdealState 与分配结果,不执行迁移。 |
| preChecks | false | 请求预检结果;必须同时设 dryRun=true。 |
| diskUtilizationThreshold | -1.0 | 覆盖预检磁盘阈值;负数时使用 Controller 配置,数值范围 0 到 1。 |
| includeConsuming | true | 适用于 REALTIME。搬迁 CONSUMING 分段会重新消费数据,可能增加内存并造成短暂数据陈旧。 |
| downtime | false | true 可一次移动全部副本,但可能让该分段短暂不可用;单副本无法保证 downtime=false。 |
| minAvailableReplicas | -1 | downtime=false 时要求重平衡过程保持的最少可用副本数。REALTIME peer-download 不应设为 0。 |
| lowDiskMode | false | 先卸载分段再添加新分段,减轻临时磁盘占用但可能延长任务;downtime=true 时不起作用。 |
| bestEfforts | false | 无法完成无停机重平衡时是否尝试尽力执行;segments 进入 ERROR 或 EV-IS 收敛超时可能导致停机。 |
| reassignInstances | true | 先更新持久化实例分配,再迁移分段;调整副本或实例分配时通常需要开启。 |
| minimizeDataMovement | ENABLE | 启用、禁用或沿用 TableConfig;减少分配变化,隐式实例分配表上可能无效果。 |
| batchSizePerServer | -1 | 每台服务器每步可新增的最大分段数;-1 表示禁用批次上限。支持范围取决于 Pinot 版本与分配策略。 |
| bootstrap | false | true 会按空表方式重新分配全部分段;只有确实需要整体重排时才考虑。 |
| externalViewCheckIntervalInMs | 1000 | 检查 ExternalView 与 IdealState 收敛的间隔。 |
| externalViewStabilizationTimeoutInMs | 3600000 | 等待视图稳定的最长时间;有进展时文档说明会自动延长。 |
| heartbeatIntervalInMs | 300000 | 任务状态更新间隔。 |
| heartbeatTimeoutInMs | 3600000 | 超过该时间无状态更新时认为任务失败。 |
| maxAttempts | 3 | 重平衡最大尝试次数。 |
| retryInitialDelayInMs | 300000 | 指数退避重试的初始等待。 |
| updateTargetTier | false | 是否同时更新分段目标 tier,仅对启用分层存储的表有意义。 |
| forceCommit | false | REALTIME 表重平衡前是否强制提交消费中的分段。 |
| forceCommitBatchSize | 2147483647 | 每批 force commit 的分段数上限。 |
| forceCommitBatchStatusCheckIntervalMs | 5000 | 检查 force commit 批次状态的间隔。 |
REALTIME 表通常需评估 includeConsuming。若只有一个副本,downtime=true 才可能完成,但应接受短暂不可用。若启用 peer-download,不要把 downtime 设为 true,也不要把 minAvailableReplicas 设为 0,以免有数据风险。
检查预检结果与迁移摘要
preChecksResult 可能检查是否启用最小数据移动、最终与临时磁盘占用、是否需要 reload、参数组合是否可疑,以及 replica group 配置。状态为 PASS、WARN 或 ERROR。WARN 表示需要人工确认;ERROR 需调查,不应盲目继续。
{
  "isMinimizeDataMovement": {"preCheckStatus":"PASS"},
  "diskUtilization": {"preCheckStatus":"PASS",
    "message":"Within threshold (<90%)"},
  "needsReloadStatus": {"preCheckStatus":"ERROR",
    "message":"Could not determine needReload status"},
  "rebalanceConfigOptions": {"preCheckStatus":"PASS"}
}
示例中的 needsReloadStatus=ERROR 表示部分服务器未返回状态,不等于自动判定整个集群不可用;应重试或手动查询 needReload,并确认来源版本差异。
rebalanceSummaryResult 分为服务器、分段和 tag 三层。核对服务器增加/移除清单、每台服务器新增与删除数量、总迁移字节估算、复制因子变化、待下载分段及消费追赶偏移量。dry run 返回 DONE 只表示计划计算完成,不表示迁移已执行。
{
  "status": "DONE",
  "description": "Dry-run summary mode",
  "segmentInfo": {
    "totalSegmentsToBeMoved": 15,
    "estimatedAverageSegmentSizeInBytes": 478983831,
    "totalEstimatedDataToBeMovedInBytes": 7184757465,
    "replicationFactor": {
      "valueBeforeRebalance": 1,
      "expectedValueAfterRebalance": 2
    }
  }
}
关联场景示例的结果要点
官方 Examples and Scenarios 页面给出七种配置变化。以下保留每个样例的主要服务器拓扑与迁移量;数字是文档中的示例输出,不是实测值。
| 场景 | 计划结果要点 |
|---|---|
| 复制因子 1 增至 2 | 增加 1 台服务器;迁移 15 个分段,估算 7,184,757,465 字节。 |
| 从平衡分配改为 replicaGroup | 示例从 2 台表服务器调整到 1 台,迁移 7 个分段,估算 3,352,886,817 字节。 |
| 每个 replicaGroup 实例数从 1 增至 2 | 增加 1 台服务器;迁移 7 个分段,估算 3,352,886,817 字节。 |
| 把表迁移到另一个 tenant | 移除旧 tenant 的服务器并加入新 tenant 服务器;迁移 15 个分段,估算 7,184,757,465 字节。 |
| 平衡分配下缩容 | 服务器数从 2 减到 1;迁移 7 个分段,估算 3,352,886,817 字节。 |
| 复制因子 2 增至 3,最小数据移动关闭 | 示例增 2 台、移除 1 台;迁移 30 个分段,估算 14,369,514,930 字节。 |
| 同一副本组场景,最小数据移动启用 | 仅增加 1 台服务器;迁移 15 个分段,估算 7,184,757,465 字节。 |
| REALTIME 消费中分段 | 样例移动 5 个 CONSUMING 分段,目标服务器还需追赶合计 1,394 个 offset;等待时间取决于实际流量。 |
追踪异步任务
正常响应会给出 jobId。用 jobId 查询进度的接口为 GET /rebalanceStatus/{jobId}。样例 status 可为 IN_PROGRESS、DONE 或 FAILED;观察初始到目标状态、ExternalView 到 IdealState 的收敛量,以及当前剩余分段和耗时。
GET /rebalanceStatus/{jobId}来源中的完成状态输出样例显示 status=DONE,三个收敛统计中的剩余分段数均为 0;IN_PROGRESS 时,timeElapsedSinceStartInSeconds 表示已运行时间。较新响应还分别提供任务总体与当前步骤的新增、删除、剩余分段数、估算数据量和完成时间。以下仅为字段结构示例:
{
  "tableRebalanceProgressStats": {
    "status": "DONE",
    "initialToTargetStateConvergence": {
      "_segmentsMissing": 0,
      "_segmentsToRebalance": 31,
      "_percentSegmentsToRebalance": 100,
      "_replicasToRebalance": 279
    },
    "externalViewToIdealStateConvergence": {
      "_segmentsMissing": 0,
      "_segmentsToRebalance": 0,
      "_replicasToRebalance": 0
    }
  },
  "timeElapsedSinceStartInSeconds": 28
}
原文还列出一个用于列举 table rebalance jobId 的 URL 示例,但路径分隔符写法有误;本文不复用该地址。请对照部署版本的 Controller API 文档核实 job-list 路由,不要照抄文中的错误路径。
取消并不会回滚
取消接口面向指定表,会取消该表仍在 IN_PROGRESS 的任务:
DELETE /tables/{tableName}/rebalance?type=OFFLINE原文样例收到的响应是被取消的任务 ID 列表:
["ffb38717-81cf-40a3-8f29-9f35892b01f9"]来源示例返回已取消 jobId 列表。取消只阻止 TableRebalancer 后续更新 IdealState;已经提交的 IdealState 变化仍会继续被集群处理。取消不会把集群恢复到重平衡前的状态,可能留下不一致布局。先排除导致取消的问题,再发起新的 rebalance 使集群收敛。
大量分段迁移时,可评估 batchSizePerServer,减少每一步修改 IdealState 的数量,让取消更快生效。该参数依版本和 replicaGroup 策略而异。
源图、版权与核验范围
原文 ZooInspector 截图所在段落说明默认服务器带 DefaultTenant_OFFLINE 和 DefaultTenant_REALTIME 标签,随后示例表配置明确 broker/server 均为 DefaultTenant。该图只展示标签节点的上下文;正文已逐项转录其关键信息。当前草稿不复用该截图,也没有用自绘流程图替代它;流程图仅概括预检到验证的文章结构。
本文静态阅读了主指南与七个场景示例,核对 API、参数、预检状态、摘要输出、任务进度与取消边界。没有向 Controller 发送 API 请求,没有安装、修改配置、移动分段或取消任务。版本、磁盘容量、查询中断与数据追赶时间均未在实际集群验证。
来源与署名:Apache Pinot 官方文档《Rebalance Servers》及《Examples and Scenarios》。公开文档页未显示该页的单独转载许可;Apache Pinot 代码仓库带有 Apache-2.0 LICENSE 和 NOTICE,但这不能自动确立该截图或文档页面的许可。本文不将 Apache-2.0 代码许可推定为文档页或截图许可。










暂无评论内容