


用 NestJS Terminus 构建健康检查
来源:NestJS 官方文档《Health checks》。核验时页面指向 NestJS v11;文档页未给出 @nestjs/terminus 的精确补丁版本。项目及文档采用 MIT 许可。本文保留来源作者与代码归属。
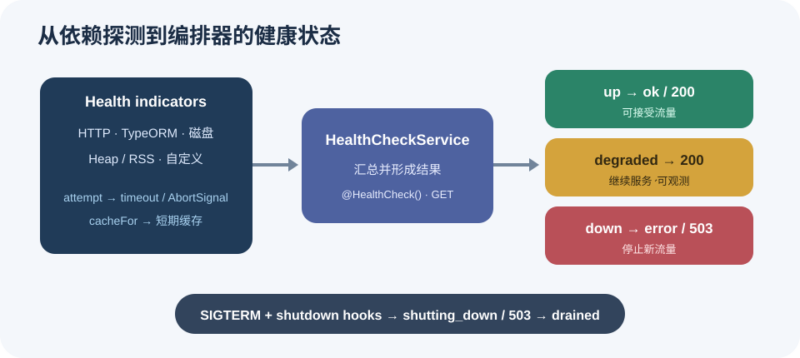
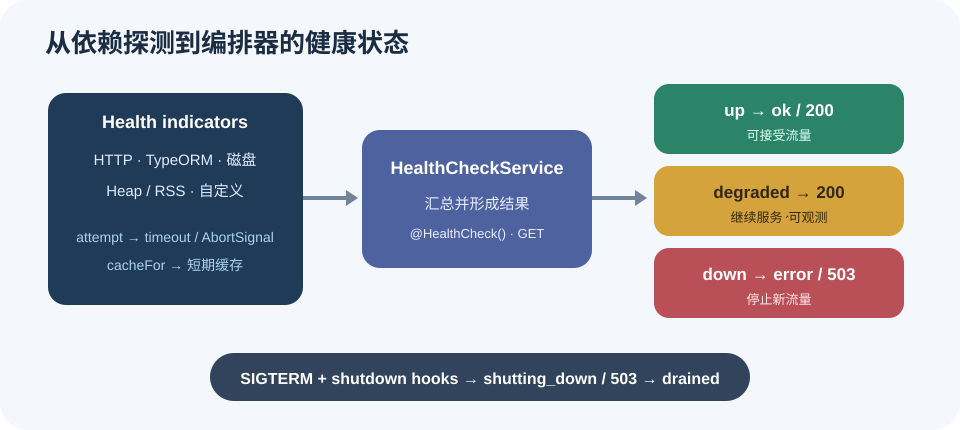
Terminus 将多个依赖探测聚合到健康检查端点,供负载均衡器或编排器决定是否继续向应用送流量。先定义端点代表的状态,再选择能反映该状态的探测项。readiness 与 liveness 常需要不同检查;外部依赖短暂故障不一定意味着应用进程应被重启。
安装并建立端点
HTTP indicator 需要 @nestjs/axios 与 axios。以下是原文的安装命令;本次未执行 npm 或项目构建。
npm i --save @nestjs/terminus @nestjs/axios axios模块需要导入 TerminusModule;HTTP 探测还需 HttpModule:
import { Module } from '@nestjs/common';
import { TerminusModule } from '@nestjs/terminus';
import { HttpModule } from '@nestjs/axios';

@Module({
  imports: [TerminusModule, HttpModule],
})
export class HealthModule {}
控制器通过 @HealthCheck() 标注探针端点,并把检查回调交给 HealthCheckService:
@Controller('health')
export class HealthController {
  constructor(
    private health: HealthCheckService,
    private http: HttpHealthIndicator,
  ) {}

  @Get()
  @HealthCheck()
  check() {
    return this.health.check([
      () => this.http.pingCheck('nestjs-docs', 'https://docs.nestjs.com'),
    ]);
  }
}
如果要验证特定 HTTP 状态码,可使用 responseCheck,例如把 204 当作成功条件。自定义请求地址应来自受控配置,不应由不可信请求参数决定。
() => this.http.responseCheck(
  'external-service',
  'https://service.example/health',
  (response) => response.status === 204,
)
数据库、磁盘与内存探测
TypeOrmHealthIndicator 会执行轻量查询来确认数据库连接仍可用:常见数据库为 SELECT 1;Oracle 使用 SELECT 1 FROM DUAL,SAP HANA 使用 SELECT now() FROM dummy。原文示例设置 1000 毫秒超时:
() => this.db.pingCheck('database').withTimeout(1000)多数据源应用可分别注入 DataSource,再在 pingCheck 的 connection 选项中指定目标连接。
DiskHealthIndicator 可按挂载点与使用率百分比检查,例如根目录使用超过 50% 即为 unhealthy;也可用绝对阈值检查空间是否超过 250 GiB。容器中的 /、Windows 的 C:\,以及实际卷挂载路径可能不同,阈值应按工作负载和容器限制选择。
() => this.disk.checkStorage('storage', {
  path: '/',
  thresholdPercent: 0.5,
})
MemoryHealthIndicator 提供 checkHeap() 和 checkRSS()。原文示例对两者都使用 150 MiB 阈值。heapUsed 只衡量 V8 堆中正在使用的内存;RSS 是进程驻留在 RAM 的总量,还包括栈、堆和驻留的共享库。它们都不能代替容器 memory limit 的判断。
() => this.memory.checkHeap('memory_heap', 150 * 1024 * 1024)
() => this.memory.checkRSS('memory_rss', 150 * 1024 * 1024)
数据库示例的来源输出为 status: ok,database.status: up,responseTime: 12。它是文档样例,不是本文运行得到的结果。
{
  "status": "ok",
  "info": {"database": {"status": "up", "responseTime": 12}},
  "error": {},
  "details": {"database": {"status": "up", "responseTime": 12}}
}
自定义指标:attempt、up、down 与 degraded
预置指标不覆盖所有场景时,可以用 HealthIndicatorService.check(key) 建立自定义指标。attempt() 会把抛出的操作错误转成 down;应把 withTimeout 提供的 AbortSignal 传给底层 I/O,让超时后请求真正取消。
isHealthy(key: string) {
  return this.healthIndicatorService
    .check(key)
    .attempt(async ({ signal }) => {
      const response = await fetch(
        'https://dog.ceo/api/breeds/list',
        { signal },
      );
      if (!response.ok) {
        throw new Error('Dog API returned a non-success status');
      }
      const { message: breeds } = await response.json();
      return { breeds: breeds.length };
    })
    .withTimeout(1000);
}
上面增加了 response.ok 检查;这是本文对来源示例的编辑补强,不是来源文档中的原始代码。
若成功条件需要显式判断,可以返回 up() 或 down(),并附加状态信息。可降级但仍可处理请求的依赖(例如缓存)可返回 degraded():整体状态为 degraded,HTTP 仍为 200,流量继续通过。如果任何指标为 down,总体状态会变为 error。由 up/down/degraded 建立的自定义指标若抛出未处理异常,会中断整项检查并产生 500;可能失败的 I/O 应用 attempt() 包裹。
文档示例给出的状态包括:
{
  "status": "degraded",
  "info": {"cache": {"status": "degraded",
    "message": "cache unreachable, serving without cache"}},
  "error": {},
  "details": {"cache": {"status": "degraded",
    "message": "cache unreachable, serving without cache"}}
}
当 Dog API 检查超过 1000 毫秒时,来源示例把 dog 标成 down,并将总体 status 设为 error;日志会显示 “timeout of 1000ms exceeded”。上述都是文档示例输出,不代表当前服务状态。
超时、缓存与日志
对 attempt() 返回值链式调用 withTimeout(1500) 可限制等待时长。到时后指标为 down,并会触发 AbortSignal;若底层请求没有使用 signal,它仍可能在后台继续运行。
cacheFor(5000) 会在 5 秒内复用同一 indicator key 的检查结果;并发检查共享一次 in-flight 执行。缓存跨请求共享,响应会带 cachedResponse: true。只对适合短期复用的探测使用缓存。
() => this.db.pingCheck('database')
  .withTimeout(1500)
  .cacheFor(5000)
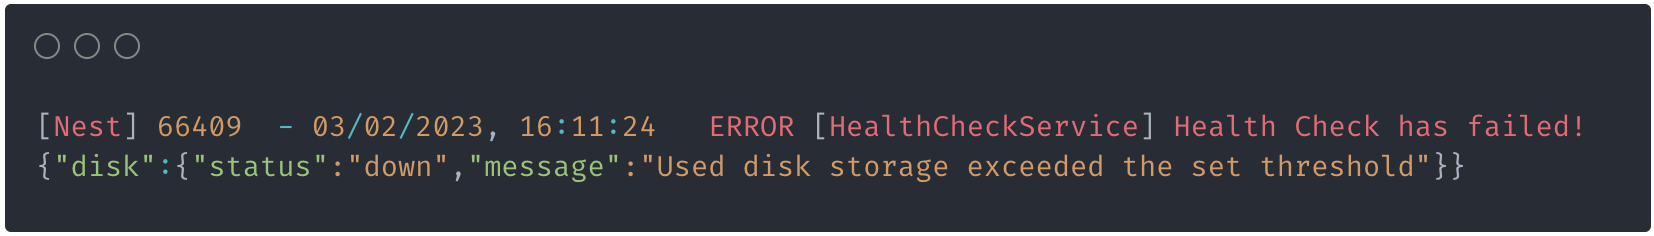
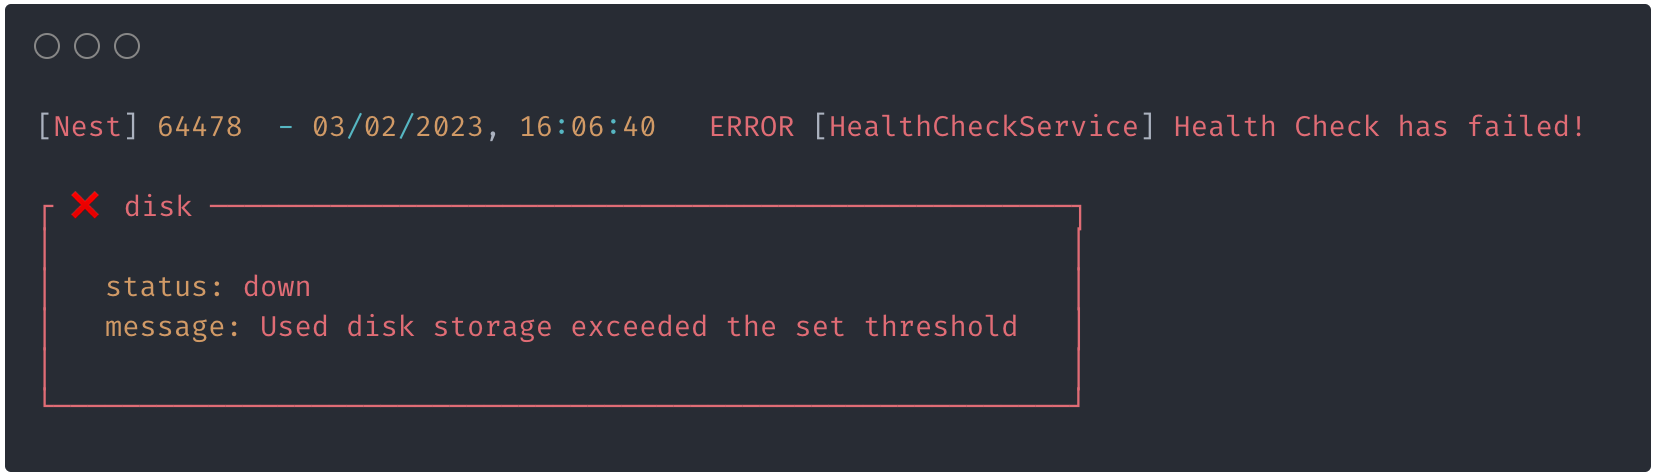
Terminus 默认在检查失败时记录错误。可通过 TerminusModule.forRoot() 注入自定义 logger、设为 false 关闭全部日志,或设置 errorLogStyle 为 json(默认)或 pretty。下面两张原文图展示同一磁盘阈值失败的两种日志格式。
SIGTERM 优雅关闭
gracefulShutdownTimeoutMs 可在 SIGTERM 后延迟退出。Terminus 可立即将健康状态切换为 shutting_down 并返回 503,让编排器停止分发新流量;等待窗口则给在途请求留出完成时间。该延迟只应用于 SIGTERM;SIGINT 等其他信号仍会立即关闭。必须启用 NestJS shutdown hooks,否则 Terminus 收不到信号。延迟长度还需结合 readiness 探针周期、请求最长耗时和编排器宽限期设置,不能仅凭配置宣称零停机。
TerminusModule.forRoot({
  gracefulShutdownTimeoutMs: 1000,
})
部署边界与核验范围
健康端点可能暴露依赖名称、内部路径、错误消息和进程指标。将其限制在可信网络或受控探针访问范围;考虑分开 readiness 与 liveness,避免外部服务抖动引发重启风暴。将回调目标限制在固定可信地址,并设置有界超时。
本文静态核对了来源页面的 HTTP、TypeORM、多数据源、磁盘、heap/RSS、自定义状态、超时、缓存、日志和 SIGTERM 示例。未运行 npm install、NestJS 项目、网络请求、数据库检查或 Kubernetes 探针;文档输出没有被当作本次运行结果。
来源与许可:NestJS 官方文档《Health checks》,页面指向 v11;项目和文档页面标注 MIT 许可。原文截图保留来源归属,代码中的 response.ok 检查为本文编辑补充。










暂无评论内容