


用 SimulStreaming 逐块转写长音频并检查延迟
Charles University / ÚFAL SimulStreaming 项目贡献者;相关论文作者 Dominik Macháček、Peter Polák;中文翻译与技术整理:未完纪。
来源:SimulStreaming。核对日期:2026-10-09。
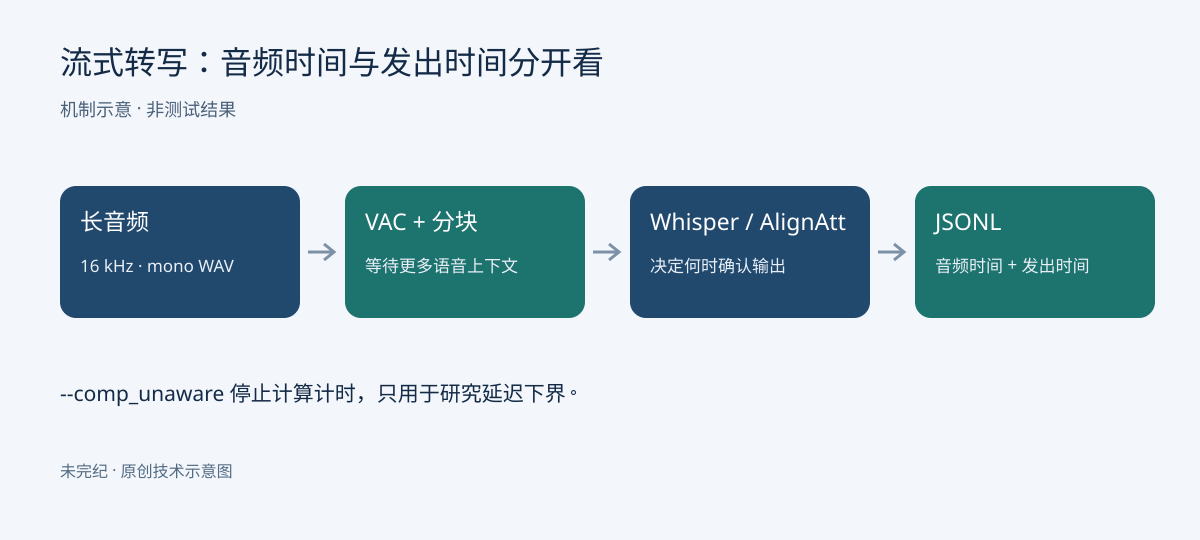
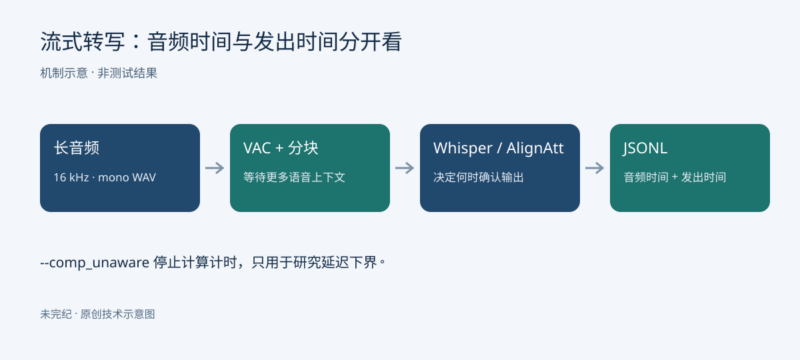
离线语音模型习惯于一次看到较完整的输入,而会议或直播的声音会不断到来。SimulStreaming 把 Whisper 接入持续更新的音频缓冲区,再用同时处理策略决定哪些内容可以输出、哪些应等待更多上下文。它结合了 Simul-Whisper 与 Whisper-Streaming 的工作,支持长音频文件模拟和简单的麦克风 TCP 演示。
仓库还包含独立的 LLM 文本翻译组件。按照本篇研究范围,这里完整讲解 Whisper 文件转写链路,不把 EuroLLM 安装或翻译服务部署混入同一个起步流程。项目关于“五倍提速”和竞赛表现的说明有其特定研究条件,本文没有复测,也不将其当作任意硬件上的性能保证。
先准备输入、依赖与模型边界
文件模拟要求 16 kHz、单声道 WAV。先检查自己的音频格式与使用授权;不要仅修改扩展名冒充格式转换。模型侧使用 PyTorch,原文建议为 large-v3(约15亿参数)准备至少10 GB显存。CPU路径可以工作,但原文不把它视为实时性能方案,较小模型也需要重新评估质量与延迟。
pip install -r requirements_whisper.txt这是原文的安装命令,本文未执行。依赖文件包含 librosa、torchaudio、torch、tqdm、tiktoken,以及带平台条件的 triton>=2.0.0。大部分没有版本上限或精确锁定,不能仅凭这份文件复现某次历史运行。应在隔离环境审查并锁定兼容组合。
较轻量的安装方式可以去掉 torchaudio,但随后不能使用 Silero 语音活动控制器,即 --vac。--model_path 指定 Whisper 的 .pt 权重;若文件不存在,程序可能自动下载。规划离线部署时,应先明确、核验并合法取得所需权重,不能在不知情的情况下把第一次运行当成纯本地操作。
以默认计时模式开始
python3 simulstreaming_whisper.py audio.wav --language en --task transcribe --vac命令中的音频文件和语言需换成实际输入,--lan 与 --language 是同一参数的别名;语言也可设为 auto。transcribe 用于源语言转写;Whisper 的 translate 路径将语音翻译为英语,不等同于仓库独立 LLM 的任意目标语言翻译。
默认模式会把计算用时计入模拟时钟。如果一次处理时间短于 --min-chunk-size,程序等待下一块;若计算期间又积累了音频,下一次处理的块会变大。这更接近实际机器处理持续输入时的情形。原文还提到在计算感知模拟前使用最初一秒做预热,因此首个调试片段可能属于预热,不应误当成额外的正式输入。
调参数时,分清等待策略与计算速度
| 参数组 | 作用 | 需要注意 |
|---|---|---|
--min-chunk-size |
最小音频块时长,单位秒 | 块更小不自动代表端到端延迟更低,更新次数也会增加 |
--vac、--vac-chunk-size |
检测并跳过无声片段;设置VAC采样块 | 停顿和结束标记依赖检测结果 |
--audio_min_len、--audio_max_len |
控制缓冲区的最小处理长度和最大长度 | 不要把音频缓冲限制误认为输出长度限制 |
--beams、--decoder |
选择束搜索或贪心解码 | beams=1用贪心;beams>1再强制greedy无效 |
--frame_threshold |
AlignAtt在缓冲区末端保留的注意力安全距离 | 原文large-v3一帧为0.02秒;不是通用模型常量 |
--init_prompt、--static_init_prompt |
提供目标语言提示与全篇保留的术语上下文 | 提示可能影响输出,不是事实保证或安全边界 |
--max_context_tokens |
上下文token限制 | 原文默认0,解释与行为应以固定版本为准 |
AlignAtt 观察解码时的编码器—解码器注意力。当注意力接近当前音频末端的“危险区”,它停止继续解码,等待新的声音进入。另一种策略 LocalAgreement 会确认连续两次更新输出的最长公共前缀;它在仓库的 LLM 翻译组件中也有重要作用。等待是为了减少不完整上下文导致的错误,与GPU执行得快慢是两回事。
CIF 与最后一个单词
--cif_ckpt_path 指向用于判断块末是否落在词边界的可选CIF模型。它必须与 Whisper 模型版本匹配;README明确说没有 large-v3 对应权重,不能把其他版本权重随意套上。
默认 --never_fire 为 false:如果配置了CIF,末词是否截断由判断决定;如果没有配置,最后一个按空格分隔的词总会被裁掉。把 --never_fire 设为 true 会覆盖这项机制,永不截断末词,也可能保留尚未说完的词。这里描述的是原文机制,不是建议无条件关闭保护。
如何读取每一行 JSONL
默认标准输出是 JSONL。每处理一个块,可能没有输出,也可能产生一条部分文字更新,或只产生语音结束标记。不能假设一块音频恰好对应一行文本。
| 字段 | 含义 |
|---|---|
start / end |
对应源音频区间的时间戳,单位秒;原文提醒这些估计可能不准确 |
text |
本次更新产生的部分文本,可能含前导空格 |
tokens |
Whisper分词器的token ID |
words |
更细粒度词片段及其时间戳和token |
is_final |
配合VAC表示源语音片段结束,不代表整个文件已经完成 |
emission_time |
该行发出时的模拟时间,单位秒;解释取决于计时模式 |
结束标记可以只有 is_final 和 emission_time,没有 text。解析器应接受这一情况。README为了说明字段曾在代码块中放入 # 注释,那是讲解文字,不是可直接交给JSON解析器的数据。
如果启用 --out-txt,文件模拟输出前三列依次是发出时间、开始时间和结束时间,单位全部改为毫秒,其后才是文字。这个简化格式不保留语音结束或词级结构。服务端同名选项又只输出开始与结束两列,不提供发出时间;不要把两种文本格式混在同一个延迟分析脚本里。
把实际计算延迟与策略下界分开
python3 simulstreaming_whisper.py audio.wav --language en --task transcribe --comp_unaware --vac这个命令对应原文展示的计算无感知模式。模型计算时,记录发出时间的时钟会暂停,输入块保持固定的最小尺寸,因此得到的是排除计算成本后、由确认策略和语言上下文造成的延迟下界。它不能作为线上用户真正等待时间的测量值。
做比较时应保留同一音频、同一模型、同一提示和分块设置,分别记录是否使用 --comp_unaware。默认模式下,emission_time - end 可用于理解某次输出相对音频末端的滞后,但它依赖时间戳估计,也不是单独完整的质量评价。还应记录模型加载、预热和队列边界;本文没有输出任何虚构的延迟数字。
--start_at 可以从指定位置开始处理,但第一次更新会得到截至该时间的整段音频,适合快速复现某一位置的问题,不等于切掉前文重新开始。README没有提供真正的完整离线最大质量模式;增大块和阈值只是原文建议的近似做法,不能保证与另一套离线推理结果一致。
调试文件和服务端需要单独的保护
同时开启 --logdir 与 --vac 会为各语音片段建立目录,保存每次更新的音频缓冲,以及上下文、强制解码缓冲和假设文本。这些是实际声音和实际内容,不是无害统计信息。对含个人资料的录音,应使用受控目录、最小权限和明确的清理周期;共享问题报告前先审查文件内容。
仓库的 Whisper TCP入口增加 --host、--port 和 --warmup-file。Linux演示通过录音工具发送16 kHz、单声道、S16_LE原始音频;Windows/macOS可用合适的音频工具替代。该演示不能直接视为具有身份验证、TLS和访问控制的生产服务。本文没有启动监听端口、录音、上传音频或下载模型。
来源、版本与检查说明
核对日期2026-10-09,README和requirements_whisper.txt来自main分支,未固定发布版本。原文large-v3显存建议与性能宣称是作者说明,不是本文测试。依赖大多未固定版本,部署前需锁定代码、依赖与权重,并核对平台支持。
项目 LICENCE.txt:MIT,Copyright (c) 2025 Charles University;嵌入的 OpenAI Whisper 代码许可为 MIT,Copyright (c) 2022 OpenAI。两份署名与MIT全文见 licenses/MIT.txt。WhisperStreaming、Simul-Whisper及各模型权重还须保留其自身许可;不从项目MIT推定所有可选模型都采用同一许可。
中文翻译与原创示意图依单独发布授权提供;模型权重及可选组件的许可仍须分别核对。
本文仅对源代码和配置做静态检查,未进行安装、运行或性能测试。文中的期望结果属于原文说明或逻辑推导,不是本文的实测结果。
- https://raw.githubusercontent.com/ufal/SimulStreaming/main/README.md
- https://raw.githubusercontent.com/ufal/SimulStreaming/main/requirements_whisper.txt
- https://raw.githubusercontent.com/ufal/SimulStreaming/main/LICENCE.txt
- https://raw.githubusercontent.com/openai/whisper/main/LICENSE
- https://aclanthology.org/2025.iwslt-1.41/










暂无评论内容