


用 Vault Autopilot 检查节点健康并清理失联成员
来源:HashiCorp / IBM 官方教程 Automate Integrated Storage management,页面未见个人署名。本文按 2026-10-09 读取的正文完整翻译整理,并静态核对伴随的 run_all.sh、cluster.sh 及 Autopilot API 参数说明。以下输出是原文实验现象,不是本次实测。
Vault 1.2 以技术预览形式引入 Integrated Storage,1.4 正式发布。它通过 Raft 在集群各节点复制数据。Vault 1.7 增加 Autopilot,负责节点健康检查、等待新节点稳定后再授予投票权,以及按配置清理失联成员。升级到 1.7 后 Autopilot 默认启用,但默认启用 Autopilot 不等于默认启用死节点清理:新节点稳定机制默认工作,自动清理必须显式打开。
实验环境:五节点集群之外,还有一个解封服务
教程要求 Vault 1.7.0 或更高版本及 sudo 权限;配套脚本支持 Linux 和 macOS,并使用 Bash、jq 和相应的进程管理工具。它会启动六个 Vault 进程,其中只有五个组成 Raft 集群:
| 实例 | API 地址 | 作用 |
|---|---|---|
| vault_1 | http://127.0.0.1:8100 | 独立 Transit 服务,提供自动解封用密钥,不属于 Raft 集群 |
| vault_2 | http://127.0.0.1:8200 | 初始化后的集群 leader,脚本写入演示 K/V v2 secret |
| vault_3 | http://127.0.0.1:8300 | 通过 retry_join 加入 |
| vault_4 | http://127.0.0.1:8400 | 通过 retry_join 加入 |
| vault_5 | http://127.0.0.1:8500 | 通过 retry_join 加入 |
| vault_6 | http://127.0.0.1:8600 | 通过 retry_join 加入,稍后模拟停机 |
如果尚不熟悉 Integrated Storage,先完成官方“Configure Vault with Integrated Storage”教程。此处六个进程都在本机,不能用来证明跨主机生产高可用性。
获取实验仓库并进入目录:
git clone https://github.com/hashicorp-education/learn-vault-raft
cd learn-vault-raft/raft-autopilot/local先读脚本再运行。配套 cluster.sh 明确声明只供教育用途:它关闭本机 HTTP listener 的 TLS,禁用 mlock,把 root token、解封/恢复密钥写入当前目录并打印到终端,还会使用 root token 为其他实例提供 Transit 解封访问。配置生成会删除同名实验 Raft 目录,进程停止通过配置路径匹配,清理会删除配置、日志、密钥、令牌及实验数据。不要在已有 Vault 数据目录中执行,也不要把这些设置移植到生产。
确认是可丢弃的隔离实验目录后,原文使用如下启动步骤。本文把 cluster.sh 的可执行权限调整移到启动前,因为 run_all.sh 会直接调用它:
chmod +x run_all.sh cluster.sh
./run_all.sh
export VAULT_ADDR=http://127.0.0.1:8200
vault operator raft list-peers配置与日志会出现在工作目录。初始化脚本完成实验认证后,list-peers 预期列出 vault_2 至 vault_6,vault_2 为 leader,其余为 follower,Voter 都是 true。它们的集群地址分别使用 8201、8301、8401、8501、8601 端口。原文启动输出包含 root token 字符串,本文不重印这些示例令牌;实际运行生成的任何令牌与恢复材料也不应进入共享日志。
读取 Autopilot 状态
vault operator raft autopilot -help
vault operator raft autopilot state
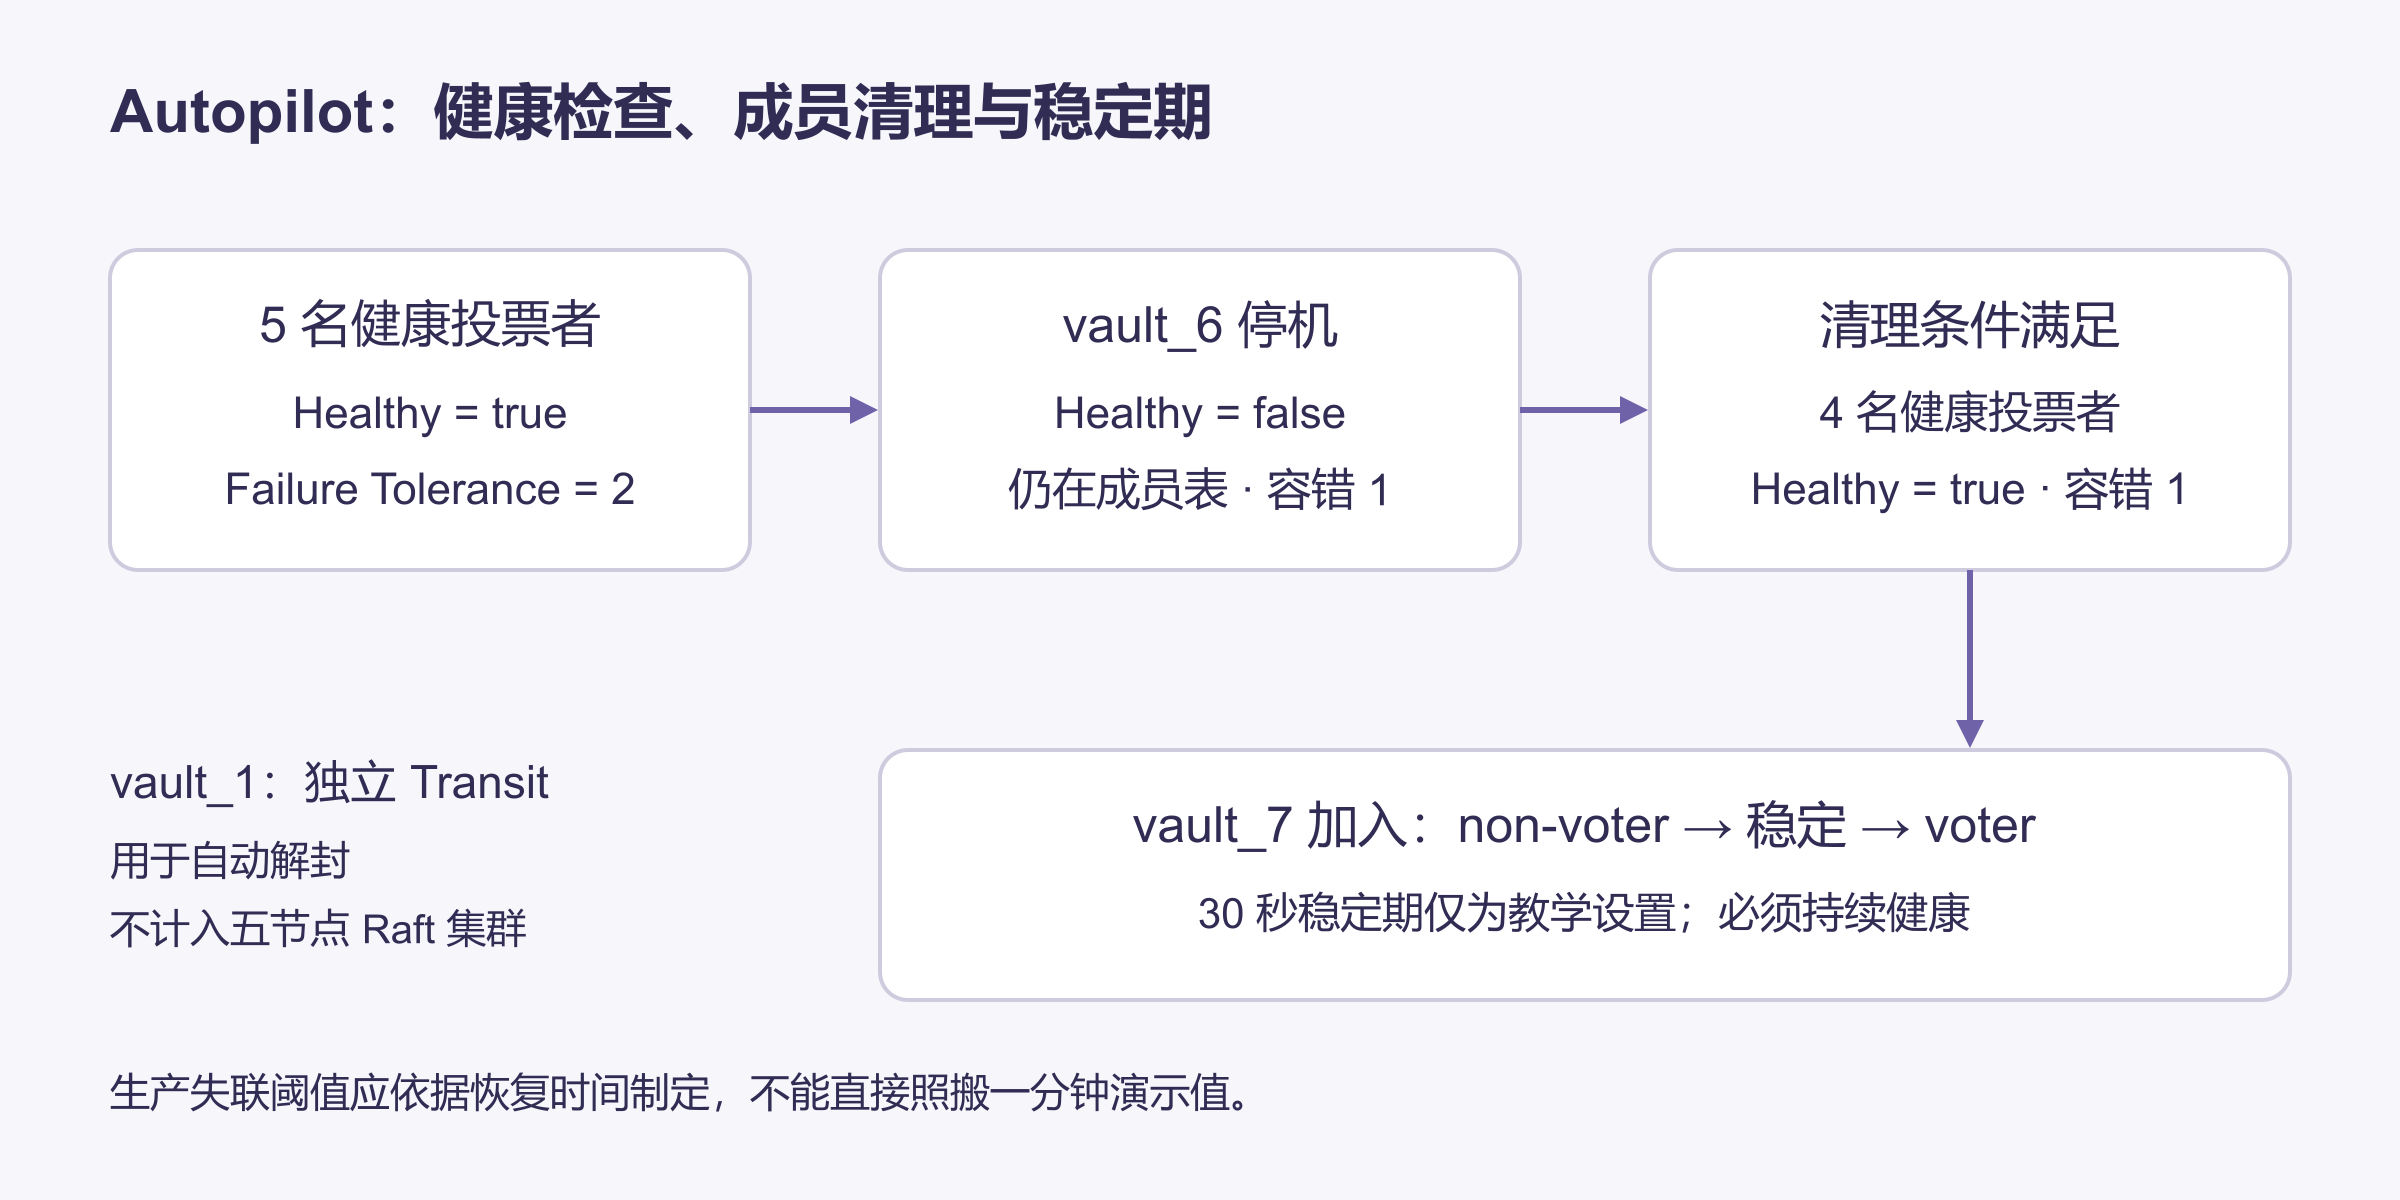
get-config 读取设置,set-config 修改设置,state 显示 Autopilot 看到的集群状态。初始状态中,Healthy 为 true,Failure Tolerance 为 2,Leader 为 vault_2,Voters 包含五个成员。五个健康投票节点需要三票维持多数,因此最多失去两个节点仍可保持法定人数。
每个服务器条目还包含 Name、Address、Status、Node Status、Healthy、Last Contact、Last Term 和 Last Index。原文示例中各节点都健康,日志索引接近 leader;具体时长、任期和索引随运行过程变化,不能把示例数值作为固定验收值。
也可通过 HTTP API 读取同一状态。教程使用 vault_2 的 root token;应仅在该隔离实验中读取 root_token-vault_2,生产自动化改用具备必要权限的管理凭据。下面的占位符需要替换,jq 只用于格式化 JSON:
curl --silent --header "X-Vault-Token: <lab-token>" \
  http://127.0.0.1:8200/v1/sys/storage/raft/autopilot/state | jq .data
JSON 对应字段为 healthy、failure_tolerance、leader、voters 和 servers;服务器中还可能出现 stable_since、version、node_type。原教程长输出包含升级信息与乐观容错等字段,它们的可用性与 Vault 版本、Enterprise 功能有关,不应要求所有 Community 版本都返回同一组字段。
停掉一个节点,观察“失联”与“移除”的区别
在实验目录中停止 vault_6:
./cluster.sh stop vault_6
vault operator raft autopilot state
原文还用 ps | grep vault 辅助查看进程;进程列表只能辅助确认停止动作,不能代替 Raft 状态检查。Autopilot 状态预期变为 Healthy=false、Failure Tolerance=1,但 Voters 仍包含 vault_6。该节点的 Healthy=false,Last Contact 持续增加。即使原输出的 Node Status 仍显示 alive,也应结合 Healthy 与最后联系时间判断。
此时 vault_6 只是不可达,尚未离开集群。Autopilot 已经发现健康问题,却不会在自动清理尚未启用时擅自把它从成员表中删除。
理解清理与稳定参数
vault operator raft autopilot get-config原教程的初始配置如下。默认值与返回字段应以目标版本实际读取结果为准:
| 参数 | 教程初始值 | 含义 |
|---|---|---|
| Cleanup Dead Servers | false | 是否自动清理失联服务器 |
| Last Contact Threshold | 10s | 多久未与 leader 联系后判为不健康 |
| Dead Server Last Contact Threshold | 24h0m0s | 多久未联系后可作为失败节点处理 |
| Server Stabilization Time | 10s | 新节点必须连续保持健康的最短时间,之后才可成为投票节点 |
| Min Quorum | 0(教程初始输出) | 清理时不能低于的集群服务器数量限制;启用清理需按实际规模显式设置 |
| Max Trailing Logs | 1000 | 允许跟随节点落后 leader 的最大 Raft 日志条数,超过即不健康 |
| Disable Upgrade Migration | false | 禁用自动升级迁移的开关;API 文档标为 Enterprise 功能 |
“不健康”门槛和“可以移除”门槛解决不同问题。生产中的失联清理门槛通常应是小时或天级;过短会剔除只是网络暂时中断、仍能恢复的节点。官方 API 说明 还要求该门槛长于新节点加载 Raft snapshot 的时间;使用 HSM 时也要覆盖它的响应时间。min_quorum 是成员清理下限,不是“设置这个数字就自动创造多数票”。
只在实验中启用一分钟失联清理
为缩短等待,教程把失联门槛改为 1 分钟、稳定时间改为 30 秒、最小服务器数设为 3。这些参数只用于观察机制,不应原样用于生产:
vault operator raft autopilot set-config \
  -dead-server-last-contact-threshold=1m \
  -server-stabilization-time=30s \
  -cleanup-dead-servers=true \
  -min-quorum=3
原文 CLI 写作 -server-stabilization-time=30;本文显式写为 30s,把单位写清。再次读配置,应看到 Cleanup Dead Servers=true、Dead Server Last Contact Threshold=1m0s、Server Stabilization Time=30s、Min Quorum=3。
vault operator raft autopilot get-config
vault operator raft autopilot state
vault operator raft list-peers
待清理条件满足并完成协调后,Healthy 恢复为 true,Failure Tolerance 为 1,vault_6 不再出现在 Voters 或 peers 中。剩下 vault_2 至 vault_5 四个投票节点。健康恢复说明成员集合已调整,不代表被停掉的机器已经自动修复。
如果使用 API,先读取 /v1/sys/storage/raft/autopilot/configuration,再提交下面的 JSON:
cat > payload.json <<'EOF'
{
  "cleanup_dead_servers": true,
  "dead_server_last_contact_threshold": "1m",
  "min_quorum": 3,
  "server_stabilization_time": "30s"
}
EOF
curl --header "X-Vault-Token: <lab-token>" \
  --request POST \
  --data @payload.json \
  http://127.0.0.1:8200/v1/sys/storage/raft/autopilot/configuration
这里将原文 JSON 的 "min_quorum":"3" 改为整数,并把 "30" 改为带单位的 "30s",对应 API 参数类型。写入后要重新 GET 配置与 state 确认实际生效;单凭 POST 命令退出或没有打印内容不能证明清理已完成。API token 仍可能出现在进程参数中,示例不能直接作为生产凭据管理方案。
新增节点为什么先没有投票权
向当前实验集群加入 vault_7:
./cluster.sh setup vault_7
vault operator raft list-peers
vault operator raft autopilot state
vault_7 的 API 监听在 8700,集群通信地址使用 8701。刚加入时,它作为 follower 出现在 peers 中,但 Voter=false;Autopilot state 中 Status=non-voter、Healthy=true。此时已有四名投票者仍是 vault_2 至 vault_5,故障容忍度仍为 1。
在节点持续健康、满足所设的 30 秒稳定期后,再检查 peers,vault_7 才会转为 Voter=true。稳定期防止一个刚连接上、却还不稳定的节点立刻改变投票成员集合;它不是从进程启动那刻起的无条件倒计时。
Enterprise 中显式配置的非投票节点不同:它们会按设计保持 non-voter,不能因为稳定期结束就期待其自动获得投票权。启用失联清理后,失败的显式非投票节点也可能被清除。此类功能需要相应 Enterprise 授权,基础自建集群仍需承担主机与运行成本。
调整状态协调间隔
原文说明 Autopilot 默认每 10 秒协调一次状态。若要改成 15 秒,在服务器 HCL 的 storage "raft" 中设置 autopilot_reconcile_interval:
storage "raft" {
  path = "/path/to/raft/data"
  node_id = "raft_node_1"
  autopilot_reconcile_interval = "15s"
}

listener "tcp" {
  address = "127.0.0.1:8200"
  tls_disable = true
}

cluster_addr = "http://127.0.0.1:8201"
上述监听和禁用 TLS 保留自本机教学示例,不是生产服务器配置。协调间隔是服务器配置项;前面的清理、稳定等参数通过 Autopilot 配置 API 管理,不能随意塞进同一 HCL stanza。实际状态变化可能等到下一轮协调后才显示。
用三个问题检查理解
-
尚未启用清理时停止 vault_6,会发生什么?集群变为不健康,容错从 2 降为 1;vault_6 仍在成员表中,但 Healthy=false。
-
vault_7 为什么先是 non-voter?Autopilot 等它保持健康达到稳定期后再晋升,无须把它当作永久非投票节点,也不是必须重启集群或手动执行某个 promote 命令。
-
自动清理如何让集群重新健康?开启清理并设置失联时间与成员下限后,Autopilot 才能在条件满足时移除失败成员,让剩余投票成员组成健康集合。
实验结束后的清理与继续阅读
原脚本提供 ./cluster.sh clean:它先停止匹配的实验服务,再删除配置、Raft 存储目录、日志、解封/恢复密钥、root token 文件及实验 snapshot。此步骤具有删除性,必须确认当前目录就是本次可丢弃实验环境,且没有需要保留的数据;本文仅说明该功能,没有执行清理,也不把它列作生产维护动作。
继续阅读可从原文末尾进入 Integrated Storage 内部说明、Autopilot 概念、CLI 与 HTTP API 参考、HA 集群教程及迁移检查清单。运行 Enterprise replication 的集群还需阅读 Autopilot 的 replication 说明,以及 Disaster Recovery Replication、Performance Replication with Paths Filter 教程;本篇的本机单集群实验不覆盖这些复制拓扑。
归属与许可:教程维护方为 HashiCorp / IBM,个人作者未列出;配套实验仓库脚本署名 Copyright (c) HashiCorp, Inc.,采用 MPL-2.0,随稿保留完整许可证文本。中文翻译与原创示意图依单独发布授权提供,并保留官方来源与脚本许可归属。本文示例未运行,也未使用真实 token、改变集群或执行删除命令。










暂无评论内容