


检查并维护 Iceberg 快照与小文件
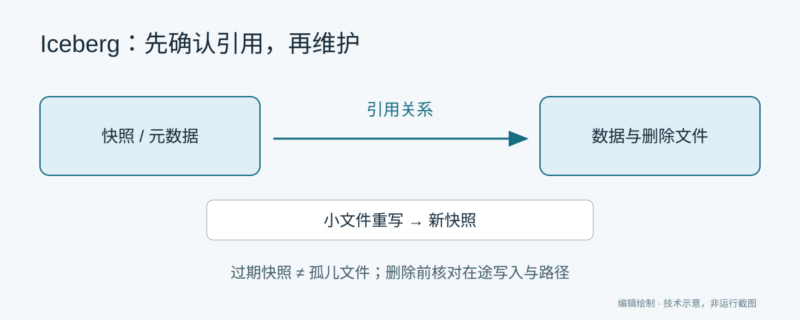
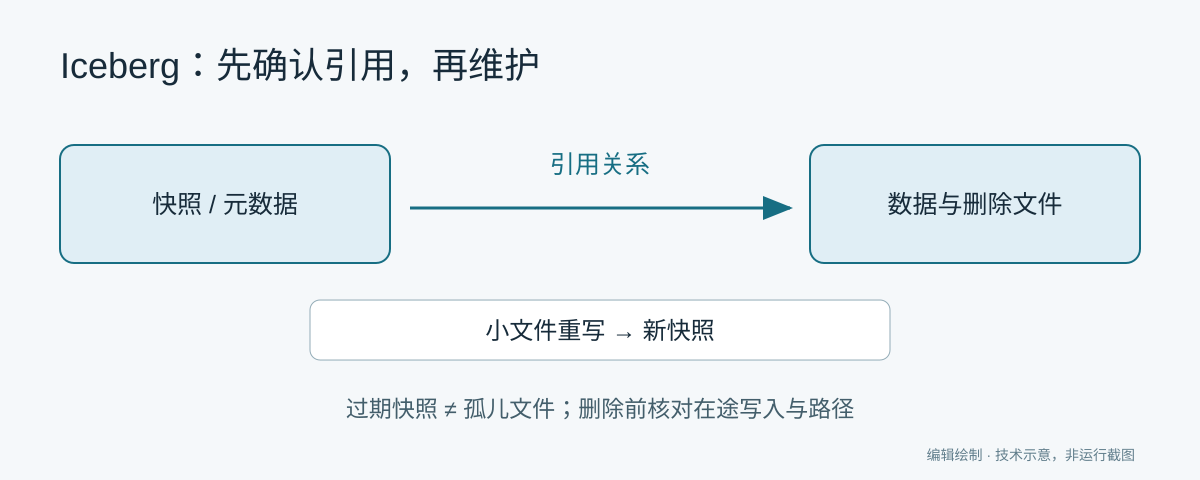
来源:Apache Iceberg 官方文档 Maintenance,维护方 Apache Software Foundation;合并相关 Spark 过程、元数据查询与入门章节。2026-10-09 复核的 latest 页面标记版本为 1.12.0。图 1 为编辑原创示意图,非源站截图。
Iceberg 的每次数据写入都会产生新的快照。快照让查询能够看到一致的表版本,也支持时间旅行与回滚;与此同时,旧快照、元数据、失败任务遗留文件和大量小文件都需要有计划地维护。正确顺序是先检查表与文件的引用关系,再决定保留政策和维护动作,最后核对返回计数及维护后的表状态。
准备能访问正确 catalog 的 Spark 会话
原 Maintenance 页的 Java 示例都从已加载的 Table 对象开始,Table table = ... 是上下文占位符,不是完整可编译程序。Spark SQL 过程则需要对应 catalog 和 Iceberg 扩展已经配置。下面保留官方入门页的本地 catalog 链,供隔离练习环境使用:
spark-sql --packages org.apache.iceberg:iceberg-spark-runtime-4.1_2.13:1.12.0 \
  --conf spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions \
  --conf spark.sql.catalog.spark_catalog=org.apache.iceberg.spark.SparkSessionCatalog \
  --conf spark.sql.catalog.spark_catalog.type=hive \
  --conf spark.sql.catalog.local=org.apache.iceberg.spark.SparkCatalog \
  --conf spark.sql.catalog.local.type=hadoop \
  --conf spark.sql.catalog.local.warehouse=$PWD/warehouse
该示例使用 Spark 4.1、Scala 2.13 对应的运行时工件,不能把坐标原样用于不同 Spark/Scala 组合。local 是基于路径的 catalog,仓库位于当前工作目录的 warehouse 下;现有生产 catalog 必须使用自己的配置和权限。上面是 POSIX shell 写法,Windows 的变量展开和续行语法不同。
下面是依据官方入门页示例统一命名后的最小练习表,使用其 local.db.table 结构并将表名改为 local.db.sample,以便后续语句保持一致。是否需要预先创建 namespace 取决于 catalog 配置;这里不添加未在本节来源中说明的建库语法。该示例未运行:
CREATE TABLE local.db.sample (id bigint, data string) USING iceberg;
INSERT INTO local.db.sample VALUES (1, 'a'), (2, 'b'), (3, 'c');
INSERT INTO local.db.sample VALUES (4, 'd'), (5, 'e');
SELECT * FROM local.db.sample;
两次写入用于说明快照变化,并不能保证产生足够多的小文件触发后面的重写。本文未运行这组语句,也没有把任何固定快照 ID、文件数量或性能数字当作本地实测结果。
先查询历史、快照和文件
Iceberg 将元数据以表的形式暴露,在完整表名后追加元数据表名即可读取:
SELECT * FROM local.db.sample.history;
SELECT * FROM local.db.sample.metadata_log_entries;
SELECT * FROM local.db.sample.snapshots;
SELECT * FROM local.db.sample.entries;
SELECT * FROM local.db.sample.files;
history 显示快照何时成为当前状态、父快照及 is_current_ancestor。同一父快照产生的两条分支中,可能有一条已被回滚,不再是当前状态的祖先。metadata_log_entries 显示元数据文件路径、时间以及最近的 snapshot/schema/sequence 信息。snapshots 列出有效快照的提交时间、ID、操作、manifest list 和 summary。
要把快照操作与提交历史关联起来,可以采用官方查询并统一到练习表:
SELECT
  h.made_current_at,
  s.operation,
  h.snapshot_id,
  h.is_current_ancestor,
  s.summary['spark.app.id']
FROM local.db.sample.history h
JOIN local.db.sample.snapshots s
  ON h.snapshot_id = s.snapshot_id
ORDER BY made_current_at;
entries 显示当前 manifest 条目,包含数据文件和删除文件。status 表示新增或删除状态,snapshot_id 标识添加或移除文件的快照,sequence 字段用于排序跨快照变更;data_file 结构包含文件级元数据,readable_metrics 提供便于阅读的列统计。
files 是判断文件大小和压实范围的重要入口。下面是编辑补充的只读检查:
SELECT content, file_path, record_count, file_size_in_bytes
FROM local.db.sample.files
ORDER BY file_size_in_bytes;

SELECT content,
       COUNT(*) AS file_count,
       SUM(file_size_in_bytes) AS total_bytes,
       MIN(file_size_in_bytes) AS smallest_bytes,
       MAX(file_size_in_bytes) AS largest_bytes
FROM local.db.sample.files
GROUP BY content;
content 的值为 0(数据文件)、1(位置删除文件)或 2(等值删除文件);不要把删除文件的物理记录数直接当作表中业务行数。当前文件与所有历史快照文件也不同:需要检查跨快照文件时,官方另提供 all_data_files、all_delete_files 和 all_entries 等元数据表。跨快照的 all 元数据表可能因同一文件被多个快照引用而返回重复记录;统计时需按问题选择合适范围,不能直接把行数当作唯一文件数。
定期让不再需要的快照到期
写入、更新、删除、upsert 和压实会产生新快照。快照会一直积累,直到执行到期操作。定期到期有助于缩小表元数据,并删除已不再被有效快照引用的数据文件。只要某个尚未到期的快照仍需要文件,该文件就不会因为另一个旧快照到期而被删除。
以下是原 Maintenance 页删除一天之前快照的 Java 示例。它展示 API,不代表推荐所有业务只保留一天:
Table table = ...
long tsToExpire = System.currentTimeMillis() - (1000 * 60 * 60 * 24); // 1 day
table.expireSnapshots()
     .expireOlderThan(tsToExpire)
     .commit();
大表可以用 Spark action 并行执行:
Table table = ...
SparkActions
    .get()
    .expireSnapshots(table)
    .expireOlderThan(tsToExpire)
    .execute();
旧快照从元数据移除后,无法继续对该快照做时间旅行查询。保留策略应同时考虑审计、回滚、长查询、分支标签和其他作业。不能因为快照“看起来旧”就清理。
Spark SQL 提供 expire_snapshots。原文示例按指定时间清理,同时至少保留最近 100 个祖先快照:
CALL hive_prod.system.expire_snapshots(
  'db.sample',
  TIMESTAMP '2021-06-30 00:00:00.000',
  100
);
时间和 catalog 是原文历史示例,必须替换为经过批准的目标及截止时间。指定 ID 的示例为:
CALL hive_prod.system.expire_snapshots(
  table => 'db.sample',
  snapshot_ids => ARRAY(123)
);
123 是示例 ID,不能是当前快照。此过程没有本文可用的 dry_run 参数;不要将孤儿清理的选项混用到快照到期上。
| 参数 | 含义 |
|---|---|
| table | 必填,目标表 |
| older_than | 截止时间,文档默认五天前;与 retain_last 均省略时使用表的到期属性 |
| retain_last | 无论时间多旧仍保留的祖先快照数,默认 1 |
| snapshot_ids | 指定需到期的快照 ID 数组 |
| max_concurrent_deletes | 删除线程池大小;默认不用线程池 |
| stream_results | 按 RDD 分区向 driver 传递删除文件,避免一次收集全部文件造成内存压力 |
| clean_expired_metadata | 清理由快照不再引用的 schema、分区 spec 等元数据 |
仍被 branch 或 tag 引用的快照不会被删除。分支和标签默认不会到期,可通过 history.expire.max-ref-age-ms 管理其保留策略;main 分支永不到期。
返回值分别统计删除的数据文件、位置删除文件、等值删除文件、manifest 文件、manifest list 和统计文件:deleted_data_files_count、deleted_position_delete_files_count、deleted_equality_delete_files_count、deleted_manifest_files_count、deleted_manifest_lists_count、deleted_statistics_files_count。应保存实际返回值,并复查 snapshots,不能只看命令无异常就断言清理符合预期。
管理旧的 metadata JSON 文件
Iceberg 每次表变更会写一个新的 metadata JSON 文件,以实现原子提交。默认保留旧文件作为历史,频繁提交的流作业尤其容易累积。每个 metadata 文件的 metadata-log 会跟踪此前的文件,跟踪数量由 write.metadata.previous-versions-max 控制。
将表属性 write.metadata.delete-after-commit.enabled 设为 true 后,新提交会删除最旧的被跟踪元数据文件,保留到指定数量。两个默认值分别为 false 和 100。它只删除仍在 metadata-log 中跟踪的文件,不会自动清理此前已经失去跟踪的孤儿元数据。
原文给出两个例子:若删除开关为 false、最多跟踪 10 个,经过 100 次提交可能有 10 个被跟踪文件和 90 个孤儿元数据文件;此时才打开删除开关不能追溯删除那 90 个,必须由孤儿文件清理处理。若开关为 true、最多跟踪 20 个,第 21 次提交后只保留 20 个被跟踪历史文件,之后每次提交都会删除最旧文件。
下面是编辑将文档属性转换为 SQL 的示例,会改变表策略,不能未经确认直接套用到现有表:
ALTER TABLE local.db.sample SET TBLPROPERTIES (
  'write.metadata.delete-after-commit.enabled' = 'true',
  'write.metadata.previous-versions-max' = '20'
);
孤儿文件:先 dry_run,再核对写入与路径
分布式任务或作业失败可能留下未被表元数据引用的文件;某些情形下,普通快照到期也无法识别和清除它们。deleteOrphanFiles action 用于清理表位置中的此类文件:
Table table = ...
SparkActions
    .get()
    .deleteOrphanFiles(table)
    .execute();
上述原文 Java action 会产生实际删除,不是预览。当数据和元数据目录很大时,扫描可能耗时较长,应周期性安排,但通常不必过于频繁。
关键边界:孤儿保留期默认三天。保留间隔若短于任意写入可能持续的时间,尚未提交的在途文件就可能被误认为孤儿并删除,从而损坏表。三天是默认值,不是所有长作业的安全保证。
另一风险来自路径比较。Iceberg 用路径的字符串表示核对文件;例如 HDFS authority 改变后,旧元数据中的 URI 和当前目录列表可能指向同一个文件却不再相等。这会导致误删。执行前必须核对元数据表路径与 Hadoop FileSystem API 列出的路径是否一致。
Spark SQL 的预览方式:
CALL local.system.remove_orphan_files(
  table => 'db.sample',
  dry_run => true
);
这里把原文 catalog 统一为前面的 local,并明确保留 dry_run=true。返回的 orphan_file_location 是候选路径;预览不会删除文件。应结合当前写入作业、文件年龄、表目录和引用关系逐一审查,而不是把有返回结果视为必须删除。
| 参数 | 作用与边界 |
|---|---|
| older_than | 只考虑指定时间前文件;默认三天前 |
| location | 扫描目录,默认表位置,不能误设到其他表或更广目录 |
| dry_run | 默认 false;true 才是只预览 |
| max_concurrent_deletes | 删除并发线程池大小 |
| stream_results | 分区传递结果以减轻 driver 内存压力;启用时输出最多 20000 个路径的样本,不是完整清单 |
| file_list_view | 使用提供的文件列表数据集,跳过目录扫描 |
| equal_schemes / equal_authorities | 显式声明等价的 scheme/authority;默认 scheme 映射为 s3a,s3n 到 s3 |
| prefix_mismatch_mode | ERROR(默认)、IGNORE 或 DELETE;选择 DELETE 会删除不匹配文件,不能作为消除报错的快捷方式 |
| prefix_listing | 使用前缀列举;FileIO 必须实现 SupportsPrefixOperations,默认 false |
如果已有可信文件清单,可以按官方示例创建临时视图。下列 Java 片段的 allFiles 和 FilePathLastModifiedRecord 仍需由调用方提供;它不是完整程序:
Dataset<Row> compareToFileList =
    spark
        .createDataFrame(allFiles, FilePathLastModifiedRecord.class)
        .withColumnRenamed("filePath", "file_path")
        .withColumnRenamed("lastModified", "last_modified");
String fileListViewName = "files_view";
compareToFileList.createOrReplaceTempView(fileListViewName);
CALL local.system.remove_orphan_files(
table => 'db.sample',
file_list_view => 'files_view',
dry_run => true
);与原文差异:这条视图调用增加 dry_run=true,先检查候选,不立即删除。原文还展示按 location 删除、忽略或删除前缀不匹配路径、声明路径等价和启用 prefix listing 的写法;这些都是实际清理选项,不构成安全预览。只有在保留期、在途作业和路径已核验后,才可在单独受控步骤中去掉 dry_run 或设为 false。本稿不执行删除。
压实小文件,同时保留逻辑数据
每个数据文件都需要 manifest 元数据。小文件过多会增加计划阶段元数据开销和执行阶段打开文件的成本。rewriteDataFiles 可通过 Spark 并行合并小文件,也能根据目标大小拆分大文件。原文按日期筛选并设置约 500 MiB 的目标:
Table table = ...
SparkActions
    .get()
    .rewriteDataFiles(table)
    .filter(Expressions.equal("date", "2020-08-18"))
    .option("target-file-size-bytes", Long.toString(500 * 1024 * 1024))
    .execute();
原文注释将该值称为 500 MB;按 1024 换算更准确的单位为 MiB。该 Java 例子要求表有 date 字段,与前面的两列练习表不是同一 schema,不应直接混用。压实改变物理文件布局并生成新快照,保留的是表的逻辑数据;它不是按条件删除业务行。
Spark SQL 的默认 binpack 调用以及一个更容易在少量练习文件上观察到动作的示例:
CALL local.system.rewrite_data_files('db.sample');

CALL local.system.rewrite_data_files(
  table => 'db.sample',
  options => map('min-input-files', '2')
);
第二条是编辑依据官方 min-input-files 选项构造的示例。是否真正重写还取决于文件组和大小等条件,返回 0 可以是正常的“没有符合条件文件”。不要为制造演示结果在生产表上启用强制全量重写。
strategy 默认 binpack,也可用 sort;sort_order 可写普通列排序、zorder(c1,c2) 或当前版本的 hilbert(c1,c2)。这些曲线排序不能与彼此或普通列排序混在同一 sort_order。where 选择可能含有匹配行的整个文件,不是只改写满足谓词的行。
| 常用选项 | 默认值与意义 |
|---|---|
| target-file-size-bytes | 536870912,即 512 MiB,继承表目标大小 |
| min-file-size-bytes / max-file-size-bytes | 目标的 75% / 180%;越界文件会被考虑重写 |
| min-input-files | 默认阈值为 5;文件组至少需有 2 个输入文件。值设为 2 时,文件数达到 2 可触发该条件 |
| rewrite-all | false;true 强制重写所选全部文件 |
| max-concurrent-file-group-rewrites | 5;同时重写的文件组上限 |
| max-file-group-size-bytes | 107374182400,即 100 GiB;按分区和大小拆分工作 |
| max-file-group-input-files | 默认 Long 最大值;设得小于 min-input-files 会让文件数量触发条件无法达到 |
| max-files-to-rewrite | 默认不限;限制本次符合条件文件总数 |
| partial-progress.enabled | false;启用后可在整体完成前提交部分文件组 |
| partial-progress.max-commits / max-failed-commits | 前者默认 10,后者默认沿用前者 |
| use-starting-sequence-number | true;使用压实开始时快照的序列号 |
| rewrite-job-order | none;可按 bytes/files 的 asc/desc 顺序处理 |
| delete-file-threshold / delete-ratio-threshold | 2147483647 / 0.3;与数据文件关联的删除条件触发阈值 |
| output-spec-id | 当前分区 spec;可将重写数据对齐到输出分区方式 |
| remove-dangling-deletes | false;true 在重写后增加提交以移除悬空删除文件 |
| cache-delete-files | false;同一删除文件应用到很多数据文件时可评估 executor 缓存 |
remove-dangling-deletes=true 按数据序列号清理;官方说明该选项不处理全局等值删除、未匹配任何数据文件的无效等值删除,或不再指向存活数据文件的位置删除记录。
sort 策略还提供 compression-factor(默认 1.0)和 shuffle-partitions-per-file(默认 1),影响输出大小估算及排序分区合并。Z-order 的可变长列贡献字节默认 8、max-output-size 默认 2147483647;Hilbert 没有这两个专有选项,且每列以完整的 8 字节基本类型宽度参与 Hilbert 索引。Hilbert 和 Z-order 不能彼此组合,也不能与普通列排序混在同一 sort_order。参数应基于真实文件和资源限制选择,不能据此承诺压实后必然更快。
过程返回 rewritten_data_files_count、added_data_files_count、rewritten_bytes_count、failed_data_files_count 和 removed_delete_files_count。若启用了部分进度,必须查看失败文件数,不能把已有部分提交误认为全量成功。维护后再次查询文件大小分布与快照;必要时在同一逻辑快照范围比较业务数据校验结果。文中只解释输出字段,没有实际运行计数。
按需要重写 manifest
manifest list 和 manifest 文件构成查询规划使用的元数据索引。它们通常按添加顺序自动合并,若写入顺序与查询过滤条件一致,例如按小时到达的数据配合时间区间查询,效果较好。写入模式与读取模式不一致时,可通过重写 manifest 重新组织文件。
原文示例选择小于 10 MiB 的 manifest,并按第一个分区字段分组:
Table table = ...
SparkActions
    .get()
    .rewriteManifests(table)
    .rewriteIf(file -> file.length() < 10 * 1024 * 1024)
    .execute();
Spark SQL 对应 rewrite_manifests,可指定 spec_id、sort_by 和 use_caching。使用缓存会增加 executor 内存占用;过程会让引用该表的 Spark 缓存计划失效。返回 rewritten_manifests_count(重写的 manifest 数)和 added_manifests_count(新增的 manifest 数)。
CALL local.system.rewrite_manifests('db.sample');位置删除文件与悬空删除引用
重写位置删除文件有两个目的:把小删除文件合并为较大文件,降低元数据与文件打开开销;在选中的文件中滤去已不再引用存活数据文件的删除记录:
Table table = ...
SparkActions
    .get()
    .rewritePositionDeletes(table)
    .execute();
只有被选中重写的删除文件受到影响。Spark SQL 对应 rewrite_position_delete_files,参数为必填 table 以及可选 options、where;不能据此认为所有历史删除文件都已处理。常用默认值包括目标文件大小 67,108,864 字节(64 MiB,继承 write.delete.target-file-size-bytes)、最小/最大文件大小为目标的 75%/180%、min-input-files 为 5(文件组超过 5 个输入文件时可按该计数条件触发)、rewrite-all 为 false、同时重写文件组数为 5、单组最大大小为 107,374,182,400 字节(100 GiB)、单组输入文件数上限默认为 9,223,372,036,854,775,807、partial-progress.enabled 为 false、partial-progress.max-commits 为 10、rewrite-job-order 默认无排序,且 max-files-to-rewrite 默认不设上限。若将单组输入文件数上限设得低于 min-input-files,文件数条件将无法触发。该过程返回 rewritten_delete_files_count、added_delete_files_count、rewritten_bytes_count 和 added_bytes_count,分别统计移除的旧删除文件数、写入的新删除文件数、移除旧文件的字节数及新增文件的字节数。
另一个 action removeDanglingDeleteFiles 是只改元数据的操作。它识别当前快照中已经不再适用于任何存活数据文件的整份删除文件:没有活数据文件的分区中的删除文件;序列号早于同分区任何数据文件的位置删除文件;序列号小于或等于同分区任何数据文件的等值删除文件。删除向量在引用的数据文件不再存活时被移除。
Table table = ...
SparkActions
    .get()
    .removeDanglingDeleteFiles(table)
    .execute();
该操作移除整份文件的引用,不重写数据或删除文件,也不能从一份同时含有效和无效记录的文件中筛掉部分记录。非分区表上它是 no-op,因为提交时已在全表范围清理相应悬空删除。当前版本没有同名 Spark SQL 过程;rewriteDataFiles 的 remove-dangling-deletes=true 可在压实后处理,rewritePositionDeletes 则处理被重写文件中的悬空记录。
补充表统计与分区统计
computeTableStats 收集列的不同值数量(NDV),写入 Puffin 统计文件,并在元数据中登记,供支持它的查询引擎做基于成本的优化。默认对当前快照全部顶层基本类型列收集,也可选择快照或列:
Table table = ...
SparkActions
    .get()
    .computeTableStats(table)
    .columns("col1", "col2")
    .execute();
上面的 col1/col2 是原文占位字段,需要替换为实际列;SQL 对应 compute_table_stats,必填参数为 table,可选参数为 snapshot_id 和 columns;过程输出 statistics_file 为新建统计文件的路径。computePartitionStats 针对分区表,从最近一次具备分区统计文件的快照增量计算到目标快照;若没有此前统计,则执行完整计算:
Table table = ...
SparkActions
    .get()
    .computePartitionStats(table)
    .execute();
SQL 对应 compute_partition_stats,必填参数为 table,可选 snapshot_id(默认当前快照);过程输出 partition_statistics_file 为新建分区统计文件的路径。前面的两列练习表没有分区,不用于演示分区统计。
两项不属于日常清理的操作
原文末尾另外介绍 deleteReachableFiles 与 rewriteTablePath。前者接收 metadata.json 路径,在表从 catalog 删除且无需其数据后,删除所有可达的数据、删除文件、manifest、manifest list 和元数据文件;该动作不可逆,其他表若共享文件也会被损坏。按研究页确定的范围,本文不将其列为可复制的维护步骤。
rewriteTablePath 则将指定源前缀改为目标前缀,暂存改写后的元数据和位置删除文件,并返回最新 metadata.json 与待复制文件清单。它不会把文件真正复制到目标位置,需要独立复制工具完成后续步骤,因此不能把调用成功当作已完成灾备。本文也不将这项示意操作扩写成未经核验的备份流程。
本次仅静态核对官方正文、参数与示例。未启动 Spark、下载运行时、创建表、提交快照、压实或删除文件。所有返回计数都描述字段意义,没有虚构运行结果。编辑新增 SQL 已标注;含删除效果的原文示例已与 dry_run 预览区别说明。路径、表名与 SQL 谓词只能来自可信配置,不能直接拼接未经校验的外部输入。
原文未列个人作者;维护方为 Apache Software Foundation。网页页脚明确声明 © 2025 The Apache Software Foundation,Licensed under the Apache License, Version 2.0;Apache Iceberg 及相关名称、标识属于相应商标。本文为中文翻译、合并与编辑补充,不代表 Apache Software Foundation 审核或认可;示意图为编辑原创。完整 Apache-2.0 许可文本见LICENSE-2.0.txt;来源署名与 Apache NOTICE 文本分别见ATTRIBUTION.txt、NOTICE.txt。参考:Maintenance、Spark procedures、Spark queries、Spark getting started、Apache-2.0。










暂无评论内容