
一份模型在磁盘上变小,并不自动意味着推理更快或者答案一样好。推理要读取权重、保存中间激活,并完成大量矩阵乘法。把原来用十六位浮点数表示的数值改用八位整数,有机会减少存储和数据搬运。但整数只有有限档位。如果很多值挤在一个狭小范围内,少数离群值却很大,用一把等距刻度同时量两者,会压缩大多数值的有效分辨率。
Dettmers 等的 LLM.int8() 研究说明了这件事为什么在 Transformer 中重要。方法把常规矩阵乘法的大部分工作交给低精度路径,同时把少量离群特征维度留给更高精度的计算。它的价值可以从一个简单的取整算例理解。真实部署还要分别验收显存、速度和任务能力,因为三项资源的瓶颈可能出现在不同位置。
八位量化改变的是什么
一个常见的对称整数近似先选择正缩放因子 s,用 round(x / s) 得到整数码,再将整数码限制在允许范围。读回时用整数乘以 s,得到对原数值的近似。若使用 −127 到 127 表示有符号量,设一组数值的最大绝对值为 a,则可取 s = a / 127。这时绝对值最大的数通常不会被裁掉,代价是更小的值只能在间隔为 s 的格点之间取整。
还需要明确量化的一组数值如何定义。将整块权重用一组缩放因子,开销低,一个离群值影响的范围却较大。按行、列或较小分组量化,能让不同局部范围分别使用刻度,同时增加缩放参数和处理开销。多数推理库还要决定累加使用什么精度、如何处理缩放、整数位宽是否有硬件指令支持。只说「模型几位」省略了这些实现差别。
权重、激活和注意力缓存也不是同一个对象。权重在推理开始前可预处理,激活的数值范围却随输入和位置变化。运行时动态估计范围时,需要额外计算和存储。自回归生成中,为避免每个新词元都重算历史,模型还常保存历史键和值。量化掉权重并不会自动缩小这些缓存。数据怎样落在内存里,取决于这几个部分是否分别处理。
一个离群值怎样改变整组分辨率
假设一组数值主要落在 −1 到 1,但其中混入一个大小为 100 的值。按最大绝对值取缩放因子,步长约是 100 除以 127,也就是 0.7874。一个 0.31 的小值在这个刻度上会被四舍五入为整数零。0.85 则变成整数一,读回来约是 0.7874。小值的细节在乘法前就已经损失。
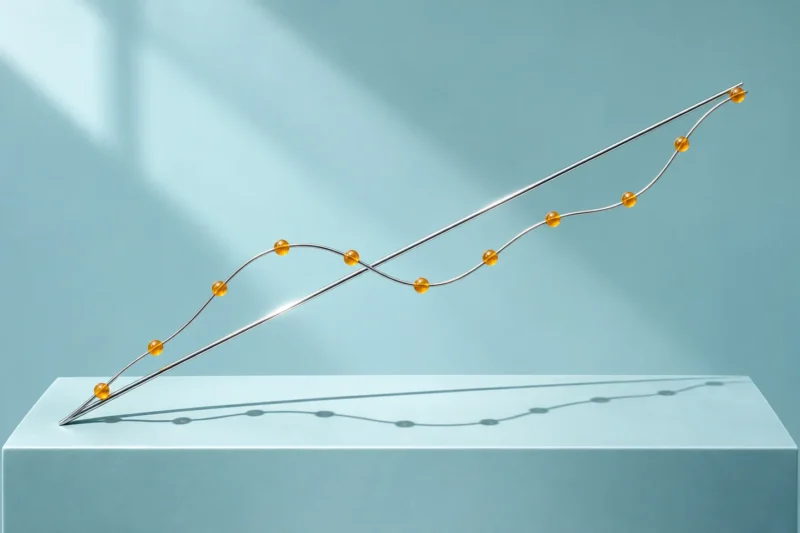
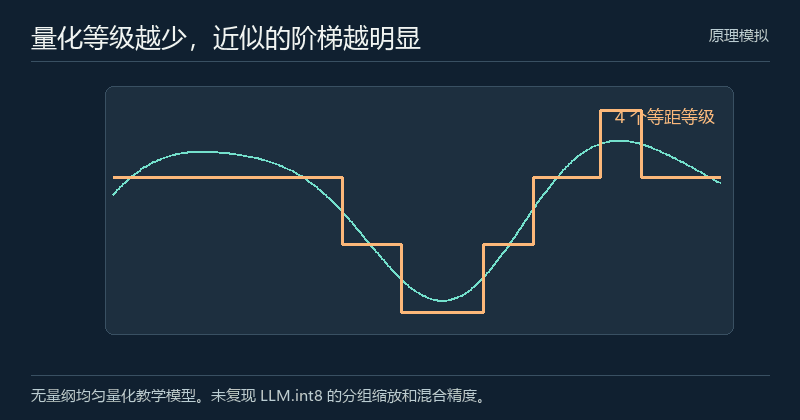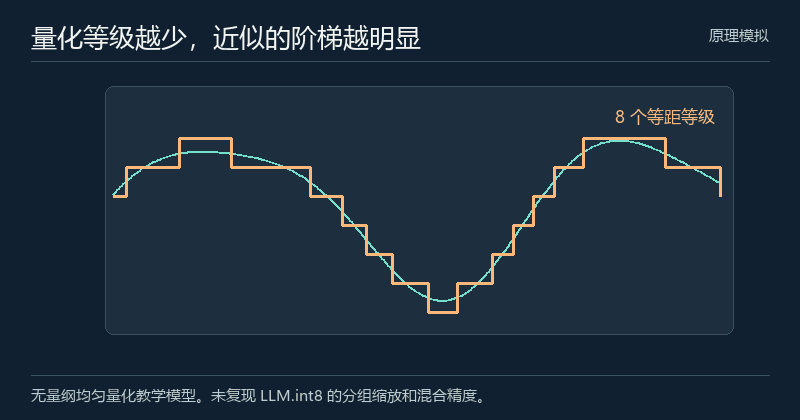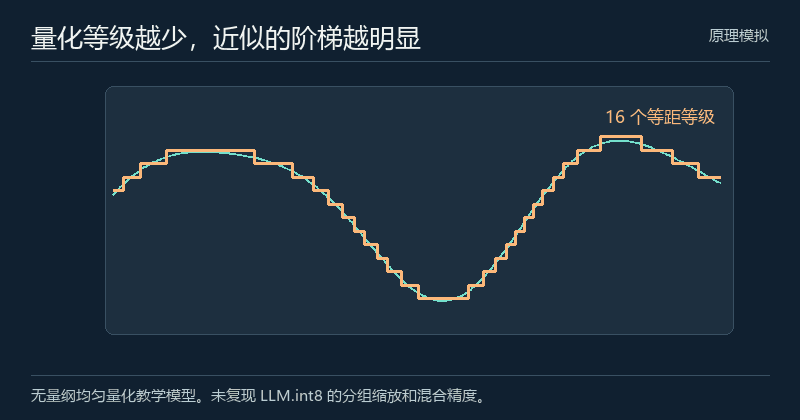
若让那个 100 走另一条高精度路径,其余小值可以在本例中以 1 除以 127 为步长。此时 0.31 对应整数 39,读回约是 0.3071。近似误差变小,是因为同样多的整数档位覆盖了更窄的值域。这组数字专为说明量化刻度而设,不能当成 LLM.int8() 的硬件测试数据。配套 GIF 用同一条连续曲线切换四、八和十六个等距等级,展示档位改变如何影响近似。
还可考虑另一种做法,把所有超过某个界限的值直接裁掉。这样能保护小值的刻度,却可能丢掉少数大值携带的贡献。在线性层计算中,一个较大的激活若恰好对应较大的权重乘积,裁剪的误差就可能明显改变结果。是否值得裁剪,应由端到端结果评估,不能只看投影后的直方图是否整齐。
展开演示动图 · 阶梯量化
LLM.int8() 怎样拆开一次矩阵乘法
把某一层收到的一批词元激活记为矩阵 X,把线性层权重记为 W。乘积 XW 的每一项,来自一个激活向量和一个权重向量的点积。LLM.int8() 先采用按向量缩放的整数矩阵乘思路,分别为输入激活的行和权重矩阵的列分配刻度。这样一个输出通道可以按其局部范围使用八位数值,整数点积之后根据缩放还原量级。
方法进一步沿参与点积的特征维划分计算。有离群激活的特征维进入较高精度的乘法,其余维进入整数矩阵乘。两条路径分别得到这部分维度的贡献,再相加得到输出。原论文在所测试的语言模型和若干任务上检查了能力保持。能保护特定实验中较重要的小部分特征,并不意味着每个架构都具有相同分布,也不意味着每种输入都值得用同一规则划分。
这一步容易与「挑几个大权重改回浮点」混淆。LLM.int8() 的混合精度拆分关注关联的激活特征维,因此高精度运算要保留这些输入维与对应权重的乘积。拆错轴会把另一个矩阵中的无关元素移到慢路径,增加开销,却救不回被挤坏的刻度。实现核对可以从一块小矩阵开始,计算分支贡献,再和同样的高精度原始乘积逐项比较。
权重和激活的量化方法需要分开对照
SmoothQuant 的研究利用一种等价变换,把激活通道的一部分缩放压力移到权重。先把一个输入通道除以某个正因子,再把相应的权重行乘回同一因子,在无限精度下乘积保持不变。改变的是两侧各自的数值范围,目的是让整数运算更易表示。与保留高精度分支相比,这种方法把工作更多放到校准和离线处理。效果取决于校准输入是否代表实际部署分布。
GPTQ 等权重量化研究解决的是另一个问题。它们重点压缩权重,并采用近似二阶信息来控制把权重取整后造成的输出误差。部署时如果激活仍使用较高精度,就不能把所得延迟直接与权重、激活同时走八位路径的方法相提并论。比较论文结果时,应先写清楚量化对象、训练和校准预算、推理内核,以及衡量性能的硬件。
这些方法可共享一个测试顺序。先在固定小样本上查看层输出偏差,再看全模型任务结果,最后测实际运行内存和吞吐。如果提高层级近似质量对任务没有可见收益,原因可能是偏差出现在不敏感位置。若模型很快却只在短文本上通过,应该继续去检查缓存随长上下文增长后的行为。保留每项指标的条件,可以把方案的优点定位到具体工作负载。
显存省下多少,可以先做一笔账
做一个纯教学估算。把 80 亿个权重全部以十六位数值保存,数据本身约占 160 亿字节。若全部以八位数值保存,数据本身约占 80 亿字节。这个理想估算省去了缩放系数以及混合精度中额外保留的数据,也没计数值内核使用的工作区。如果批次大、上下文长,运行中的缓存和激活还会占用不少空间。实测峰值显存往往不会恰好等于这笔账。
延迟也可以拆成首次响应和后续生成。对很长的输入,先处理所有输入词元的阶段会大量用到矩阵乘法。逐词元生成时,较小批次可能更多受权重读取与缓存访问影响。低精度内核如果需要额外的格式转换、重新排列或慢路径拆分,节省的字节不一定转成更低的延迟。读者应比较各项百分位耗时,同时记录批次、输入长度和生成长度,再解释快在哪里。
把模型质量和生产负载一起验收
可以先保留一份浮点基线和一份量化拷贝。让两者使用相同参数版本、相同词元化规则、同样的输入与生成设置,分别测困惑度和目标任务正确率。无论平均结果怎样,都应把数字推理、专业术语、罕见字符和长篇答案单独报告。总体分数对少见错误不敏感,而这些错误恰好可能让部署无法通过验收。
然后测真实工作负载的显存与吞吐。固定硬件、驱动和实现,记录权重、缓存及运行工作区之间的大致比例。让相同请求重复多轮,把冷启动、预热和稳定期分开。发现速度收益不足时,再查实际是否使用了支持整数指令的内核、离群分支是否占比较大,以及数据转换是否反复执行。把资源节省和质量损失放到同一张对比表里,才知道低精度策略适合哪个用途。
低精度推理真正需要保留的是能改变输出的数值信息。许多参数可以在更少的档位中表示,少量重要特征却可能决定是否还能维持能力。将它们用不同路径处理,可以在表示成本和计算误差之间找到实际可用的平衡。最后的判断来自目标设备、目标长度和目标任务的测量。