


在上一篇文章中,我们概览了 Polars 的内部工作方式。本篇深入查询优化器,解释最重要的优化规则之一:谓词下推。思路简单而有效:尽可能靠近数据源应用所有过滤条件。这样既避免为随后会丢弃的数据进行无谓计算,也减少从磁盘读取或经网络传输的数据量。
什么是谓词?在数据处理语境中,谓词指施加于数据的过滤条件,通常表示为布尔表达式,例如 column_a > 2。条件求值结果不为真的行会被丢弃。
简单示例
先用一个简单示例说明谓词的概念,再逐步讨论更常见的企业场景。假设有一个简单的 CSV 文件 net_worth.csv:
age,net_worth
1,0
30,50000
50,60000
70,100000
我们想计算年龄超过四十岁的人群的平均 net_worth:
df = (
    pl.scan_csv("net_worth.csv")
    .filter(pl.col("age") > 40)
    .select(pl.col("net_worth").mean())
)
df.show_graph(optimized=False)
计算图最好从下往上阅读,因为数据从叶节点传向根节点。
未优化的图中,过滤是数据集上的第一个计算步骤。这已经很好,但还能进一步改进:先读入整个 CSV,再丢弃不需要的数据,大文件下会消耗很多内存。更好的方法是在读取数据时立即过滤,避免整个数据集同时驻留内存。
在查询优化阶段,查询引擎收集所有谓词,并把它们交给 I/O 读取器。
df.show_graph(optimized=True)
对于 CSV 格式,这意味着可以边读取边丢弃行。但在其他情况下,收益可能更显著:完全跳过整片内存区域,甚至整个文件。下面分别讨论。
Parquet
CSV 示例仍然需要读取整个文件;Parquet 可以做得更好。Parquet 格式很复杂,完整解释足以写成多篇文章。这里采用下面的简化结构。更详细描述见官方规范。
一个 Parquet 文件大致分为文件头、数据和元数据三个部分。数据按行组(row group)存储;每个行组中,各列连续排列。末尾部分保存行组元数据,可为行组中的每列存储最小值、最大值或其他统计信息。Parquet 允许使用任意键值组合,构造特定场景所需的统计信息。
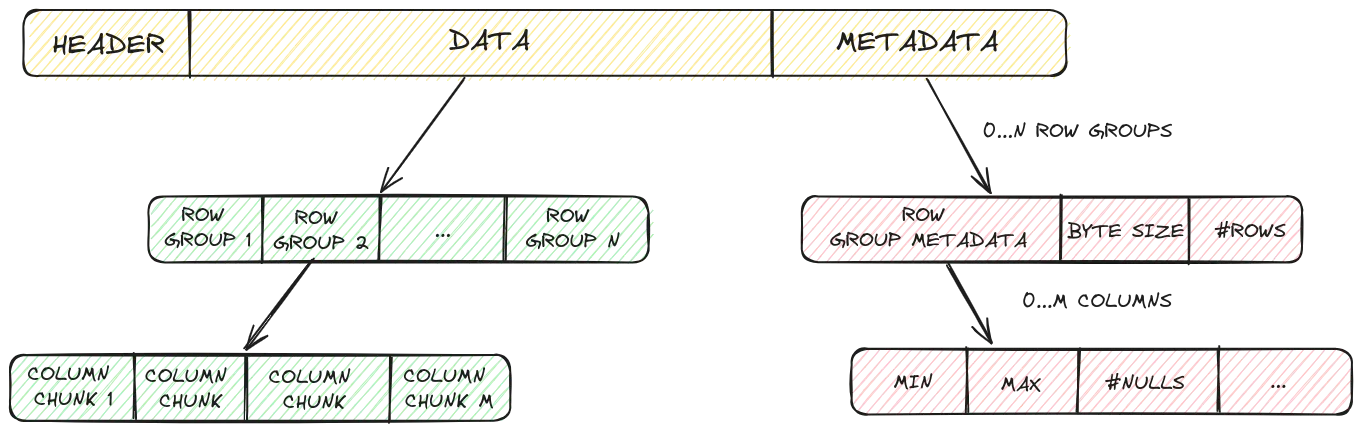
Parquet 谓词下推的一种常见模式是分两步读取文件:首先获取元数据,再用谓词判断某个行组是否需要读取。例如对 column_a > 2,读取器查看每个行组中 column_a 的列元数据及最小、最大值;若统计信息足以证明该行组不符合谓词,就不必读取它。
这样可以跳过 Parquet 文件的整片区域。相比必须读取整个文件的 CSV 示例,此时只需读取相关区域。
Parquet 数据集通常分布在多个文件中。每个文件仍需读取元数据;特别是存在很多小文件时,这可能很慢。大量小文件意味着为获取各文件元数据而向对象存储发送大量请求,从而拖慢流水线。Hive 分区可以进一步改进。
Hive 分区
Hive 分区是一种简单但有效的技术:根据某些关键列的值,把磁盘数据分为多个文件与文件夹。数据工程师预先选择关键列,例如按时间拆分数据集。
下面按 country 列拆分,把属于同一国家的数据放进独立的一个或多个 Parquet 文件。Hive 分区借用文件路径表达关键列值;例如路径可以是 /datawarehouse/dataset/country=USA.parquet。
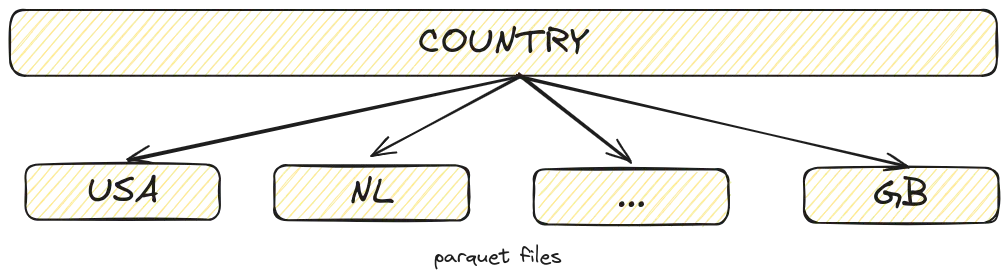
谓词下推可借助这些信息判断是否需要读取文件,连元数据都无需读取。正确使用时,这非常有效。下面查询按国家进行 Hive 分区的数据集;日志显示读取时直接跳过了 192 个国家,带来显著性能提升。
其限制是:下推只对预先选择的分区关键列起作用;若过滤另一列,这种方法便无法发挥相同作用。
pl.scan_parquet("./dataset/country=*/*.parquet").filter(pl.col("country") == "GB").collect()parquet file can be skipped, the statistics were sufficient to apply the predicate.
hive partitioning: skipped 192 files, first file : dataset/country=AD/bc8b489755c7489bbdb6418523a66aaf-0.parquetS3 Select
如果遵循“尽可能靠近数据源应用过滤”的原则,S3 Select 就是进一步的做法。S3 是 AWS 的云对象存储,数据湖方案经常用它保存底层数据。在前述示例中,除了 Hive 分区,我们仍然把数据从 S3 经网络传到计算端。虽然网络连接已经改善很多,但若不传输不需要的数据,仍然更好。
S3 Select 提供这种能力:查询引擎用特定格式提供谓词,S3 Select 直接在数据上应用过滤。过滤发生于 S3 计算服务器,比先经网络传输,再在自己的计算服务器上过滤更高效。
结论
谓词下推是一种强大的技术,能够尽早过滤数据,避免为之后会丢弃的数据进行计算。本文介绍了 Polars 中几项关键技术,用来优化谓词下推的使用,最终节省宝贵的计算和内存资源。
脚注
- 更详细的 Parquet 描述见官方规范。
- Parquet 允许用任意键值组合创建特定场景所需的统计信息。
- 大量小文件会带来许多向对象存储请求元数据的操作,使流水线变慢。











暂无评论内容