


借助 OpenTelemetry 和 Grafana Alloy——Grafana 发行的 OpenTelemetry Collector——从其他供应商迁移会容易得多。
但如果原平台采用不同的时间聚合语义,例如 Datadog 或 Dynatrace,那么接入 Grafana Cloud 这样的 Prometheus 生态时,就会遇到挑战:指标的含义没有变,显示结果却不对。
原因在于,一些不基于 Prometheus 的可观测性工具使用增量(delta)样本,报告测量值的相对变化,例如 +3、-7 等。
相比之下,Prometheus 使用的累积(cumulative)采样表示完全相同的信息,但它是相对于某个聚合时段的“绝对”值,例如10、4。
请看下面的时间序列示例,OTel 将它称为流(stream):
| 时间 |
10 |
20 |
30 |
40 |
50 |
60 |
70 |
80 |
90 |
100 |
| 累积值 |
12 |
14 |
14 |
17 |
10 |
4 |
13 |
18 |
22 |
24 |
| 增量值 |
+12 |
+2 |
+0 |
+3 |
-7 |
-6 |
+9 |
+5 |
+4 |
+2 |
Grafana Labs 博客此前更详细地介绍过这一主题,我也在 OTel Community Day 2024 分享过相关内容:

好在 Alloy 和 OpenTelemetry Collector 最近显著增强了对此场景的支持!
Grafana Labs 团队向上游贡献了 deltatocumulative 处理器,补齐了将增量样本发送到 Prometheus、Grafana Cloud 等累积型后端所需的一环。
转换增量指标
将增量样本流转换为等价的累积样本,底层数学并不十分复杂。
考虑下面的简化算法:

处理指标写入请求时,遍历样本列表。对于每个增量的增加或减少,将其加到该流的上一个值上;如果是首次看到的样本,则以上一个值为0进行计算。
由于数值随时间不断相加,结果就成了正确的累积样本。处理器保存这些值,供下一次聚合使用,同时把它们传给指标管线中的下一个消费者。
要始终正确完成转换,还需要处理时间戳和边界情况,但以上描述抓住了基本思路。
状态的作用
上述操作存在一个重要限制:它是有状态的。
注意算法持续读写的“处理器状态”。Collector 必须将它保存在内存中。又因为状态是针对每个序列分别维护的,所以某个时间序列的每一个样本都必须发送到与上一个样本完全相同的 Collector 实例。
这显然不太利于扩展,对吧?
加入负载均衡
好在另一个组件恰好可以满足这一需求:loadbalancing 导出器。
它最近增加了基于 streamID 的路由支持,正好完成我们所需的工作:始终把同一个时间序列的样本发送到固定的 Collector 端点。
为此,我们建立两层 Collector 部署:

为简洁起见,下文仅列出最重要的部分。完整配置可在 GitHub 获取:
sh0rez/deltatocumulative-scaling
使用容器
我用 Docker Compose 创建上述部署的容器,不过任何系统都可以实现,包括 Kubernetes:

services:
    # application generating delta metrics, writes to router using OTLP
    app:
        build: ./deltagen
        environment:
            OTEL_EXPORTER_OTLP_ENDPOINT: http://router:4318
            OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE: delta
        scale: 4

    # stateless collector, routing incoming metrics to workers based on stream-id
    router:
        image: otel/opentelemetry-collector-contrib:0.112.0
        volumes:
            - ./loadbal.yml:/etc/otelcol-contrib/config.yaml
        scale: 1

    # stateful collector, converting from delta to cumulative and remote_writing to prometheus
    worker:
        image: otel/opentelemetry-collector-contrib:0.112.0
        volumes:
            - ./worker.yml:/etc/otelcol-contrib/config.yaml
        scale: 2
这样便有了多个生成指标的应用实例、一个负载均衡器和两个工作节点。
Docker Compose 还会自动配置 Docker DNS 服务器,使 nslookup router 返回两个实例的 IP 地址。
配置负载均衡器
我们的应用通过 OTLP 发送指标,但也可以使用其他接收器:
receivers:
    otlp:
        protocols:
            http:
                endpoint: 0.0.0.0:4318
接下来,配置 loadbalancing 导出器,按序列执行粘性路由:
exporters:
    loadbalancing:
        routing_key: streamID # load-balance on a per-stream basis
        resolver:
            dns:
                hostname: worker # send to a stable worker of the pool
        protocol:
            otlp:
                tls:
                    insecure: true # for testing, properly configure TLS in production
这里使用 dns 解析器,对主机名 worker 执行 DNS A 记录查询,发现工作节点实例。
Docker Compose 配置内置 Docker DNS 服务器,使其在查询服务名时始终返回所有实例的 IP 地址。在 Kubernetes 中,可用无头 Service 达到相同效果。
配置工作节点
工作节点通过 OTLP gRPC 接收路由器发送的样本,将其转换为累积样本,再转发到 Collector 支持的某个后端,例如 Grafana Cloud。
receivers:
    otlp:
        protocols:
            grpc:
                endpoint: 0.0.0.0:4317
deltatocumulative 处理器开箱即用。其他配置选项见文档。
processors:
    deltatocumulative: {}
转换为累积样本后,就可以使用任何支持累积时间聚合语义的导出器,例如 prometheusremotewrite。
exporters:
    prometheusremotewrite:
        endpoint: http://prometheus:9090/api/v1/write
        resource_to_telemetry_conversion:
            enabled: true
运行处理器
启动后,使用以下查询,可以清楚看到数据点在不同工作节点之间均匀分布:
rate(otelcol_receiver_accepted_metric_points[1m])
这个示例将工作节点从2个扩至3个,再扩至5个,随后缩回2个。
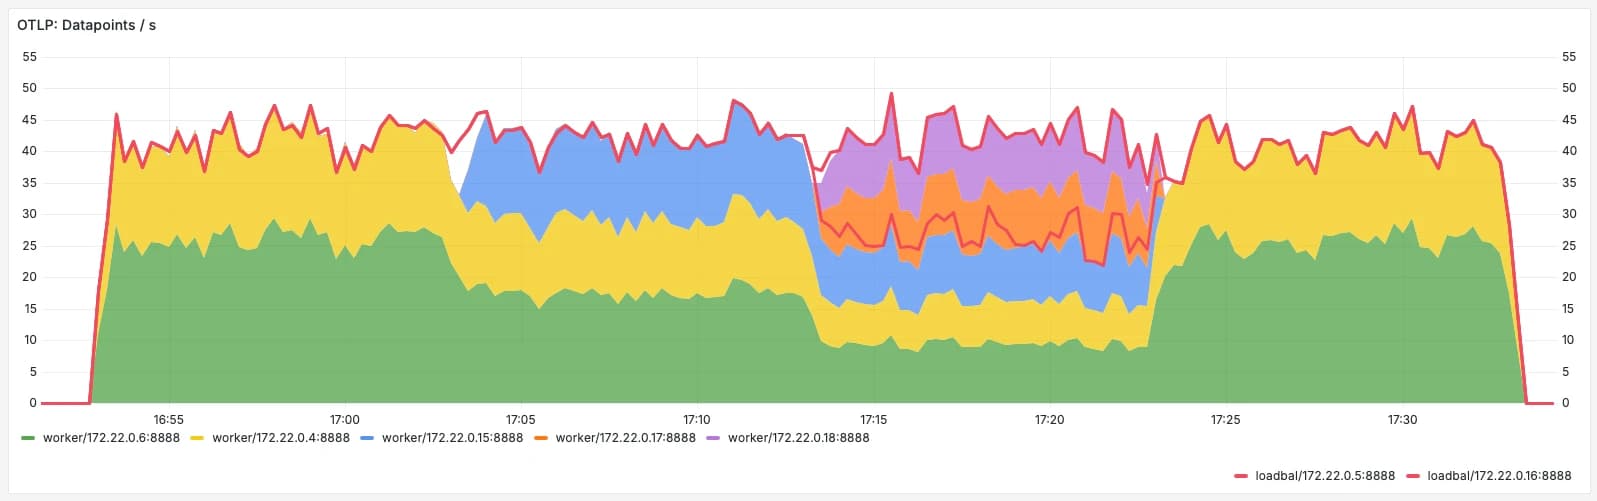
实例加入或退出时通过 DNS 被发现,loadbalancing 始终在它们之间均匀分配负载。
负载均衡器(红线)从1个扩至2个,再恢复到1个。
观察 deltatocumulative,可以看到内存中跟踪的各个流。如果5分钟没有收到新样本,相应流就会被丢弃:

后续展望
其中的大部分功能仍是刚向社区发布的早期工作。
欢迎任何测试和反馈。可以提交问题、在 Slack 交流(Grafana 社区 Slack 和 CNCF Slack 都有 #opentelemetry 频道),也欢迎贡献 PR。
功能成熟后,我们将探索降低运维复杂度的方法,例如把此功能直接集成到 Prometheus 的 OTLP 接收器或 Grafana Cloud 等后端中。
Grafana Cloud 为指标、日志、追踪、仪表板等提供便捷的入门方式。我们提供长期免费层和适合各种使用场景的套餐。现在即可免费注册。











暂无评论内容