


时间复杂度和空间复杂度是衡量一个算法效率的重要标准.
基本操作数
同一个算法在不同的计算机上运行的速度会有一定的差别,并且实际运行速度难以在理论上进行计算,实际去测量又比较麻烦,所以我们通常考虑的不是算法运行的实际用时,而是算法运行所需要进行的基本操作的数量.
在普通的计算机上,加减乘除、访问变量(基本数据类型的变量,下同)、给变量赋值等都可以看作基本操作.
对基本操作的计数或是估测可以作为评判算法用时的指标.
时间复杂度
定义
衡量一个算法的快慢,一定要考虑数据规模的大小.所谓数据规模,一般指输入的数字个数、输入中给出的图的点数与边数等等.一般来说,数据规模越大,算法的用时就越长.而在算法竞赛中,我们衡量一个算法的效率时,最重要的不是看它在某个数据规模下的用时,而是看它的用时随数据规模而增长的趋势,即 时间复杂度.
引入
考虑用时随数据规模变化的趋势的主要原因有以下几点:
- 现代计算机每秒可以处理数亿乃至更多次基本运算,因此我们处理的数据规模通常很大.如果算法 A 在规模为 的数据上用时为 而算法 B 在规模为 的数据上用时为 ,在数据规模小于 时算法 B 用时更短,但在一秒钟内算法 A 可以处理数百万规模的数据,而算法 B 只能处理数万规模的数据.在允许算法执行时间更久时,时间复杂度对可处理数据规模的影响就会更加明显,远大于同一数据规模下用时的影响;
- 我们采用基本操作数来表示算法的用时,而不同的基本操作实际用时是不同的,例如加减法的用时远小于除法的用时.计算时间复杂度而忽略不同基本操作之间的区别以及一次基本操作与十次基本操作之间的区别,可以消除基本操作间用时不同的影响.
当然,算法的运行用时并非完全由输入规模决定,而是也与输入的内容相关.所以,时间复杂度又分为几种,例如:
- 最坏时间复杂度,即每个输入规模下用时最长的输入对应的时间复杂度.在算法竞赛中,由于输入可以在给定的数据范围内任意给定,我们为保证算法能够通过某个数据范围内的任何数据,一般考虑最坏时间复杂度;
- 平均(期望)时间复杂度,即每个输入规模下所有可能输入对应用时的平均值的复杂度(给定输入概率分布下期望用时的复杂度;均匀平均是常见特例).
所谓「用时随数据规模而增长的趋势」是一个模糊的概念,我们需要借助下文所介绍的 渐近符号 来形式化地表示时间复杂度.
渐近符号的定义
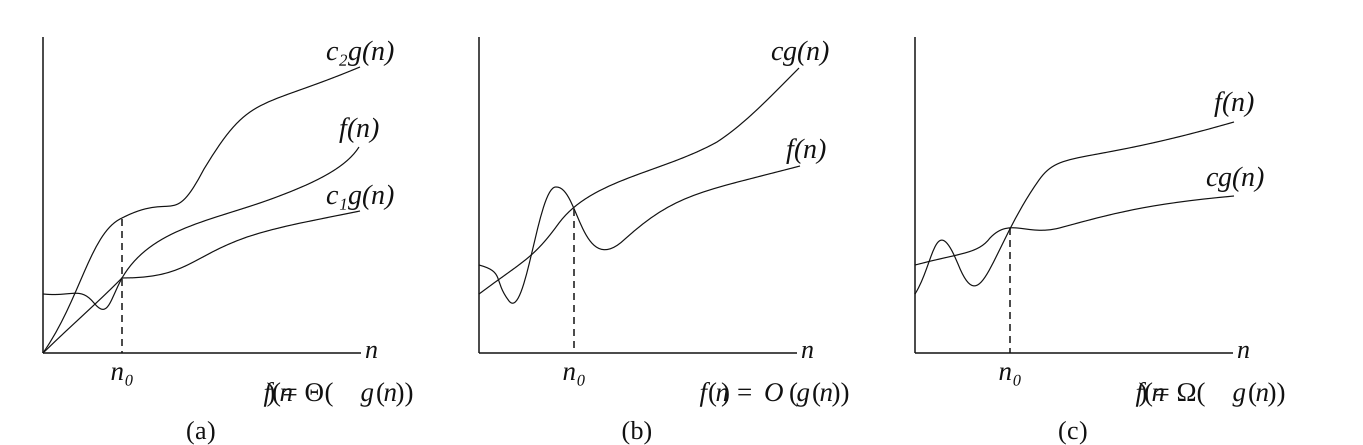
渐近符号是函数的阶的规范描述.简单来说,渐近符号忽略了一个函数中增长较慢的部分以及各项的系数(在时间复杂度相关分析中,系数一般被称作「常数」),而保留了可以用来表明该函数增长趋势的重要部分.
一个简单的记忆方法是,含等于(非严格)用大写,不含等于(严格)用小写,相等是 ,小于是 ,大于是 .大 和小 原本是希腊字母 Omicron,由于字形相同,也可以理解为拉丁字母的大 和小 .
在英文中,词根「-micro-」和「-mega-」常用于表示 10 的负六次方(百万分之一)和六次方(百万),也表示「小」和「大」.小和大也是希腊字母 Omicron 和 Omega 常表示的含义.
大 Θ 符号
对于函数 和 ,,当且仅当 ,使得 .
也就是说,如果函数 ,那么我们能找到两个正数 使得 被 和 夹在中间.
例如,,这里的 可以分别是 ;,这是因为 ,故存在足够大的 ,使被省略项不超过 .
大 O 符号
符号同时给了我们一个函数的上下界,如果只知道一个函数的渐近上界而不知道其渐近下界,可以使用 符号.,当且仅当 ,使得 .
研究时间复杂度时通常会使用 符号,因为我们关注的通常是程序用时的上界,而不关心其用时的下界.
需要注意的是,这里的「上界」和「下界」是对于函数的变化趋势而言的,而不是对算法而言的.算法用时的上界对应的是「最坏时间复杂度」而非大 记号.所以,使用 记号表示最坏时间复杂度是完全可行的,甚至可以说 比 更加精确,而使用 记号的主要原因,一是我们有时只能证明时间复杂度的上界而无法证明其下界(这种情况一般出现在较为复杂的算法以及复杂度分析),二是 在电脑上输入更方便一些.
大 Ω 符号
同样的,我们使用 符号来描述一个函数的渐近下界.,当且仅当 ,使得 .
小 o 符号
如果说 符号相当于小于等于号,那么 符号就相当于小于号.
小 符号大量应用于数学分析中,函数在某点处的泰勒展开式拥有皮亚诺余项,使用小 符号表示严格小于,从而进行等价无穷小的渐近分析.
,当且仅当对于任意给定的正数 ,,使得 .
小 ω 符号
如果说 符号相当于大于等于号,那么 符号就相当于大于号.
,当且仅当对于任意给定的正数 ,,使得 .
常见性质
- .
- .
- .
- .由换底公式可以得知,当底数为固定实数 时,对数函数都具有相同的增长率,因此渐近时间复杂度中对数的底数一般省略不写.
简单的时间复杂度计算的例子
for 循环
|
|
|
如果以输入的数值 和 的大小作为数据规模,则上面这段代码的时间复杂度为 .
DFS
在对以邻接表存储的、 个点 条边的 连通图 进行 DFS 时,由于每个节点和每条边都只会被访问常数次,复杂度为 .
哪些量是常量
当我们要进行若干次操作时,如何判断这若干次操作是否影响时间复杂度呢?例如:
|
|
|
如果 的大小不被看作输入规模,那么这段代码的时间复杂度就是 .
进行时间复杂度计算时,哪些变量被视作输入规模是很重要的,而所有和输入规模无关的量都被视作常量,计算复杂度时可当作 来处理.
需要注意的是,在进行时间复杂度相关的理论性讨论时,「算法能够解决任何规模的问题」是一个基本假设(当然,在实际中,由于时间和存储空间有限,无法解决规模过大的问题).因此,能在常量时间内解决数据规模有限的问题(例如,对于数据范围内的每个可能输入预先计算出答案)并不能使一个算法的时间复杂度变为 .
主定理
我们可以使用主定理(Master theorem)来快速求得关于递归算法的复杂度.假设 、 为常数, 非负,.为简化讨论,下面额外假设 ,其中 为非负整数.其递推关系式如下:
那么
需要注意的是,这里的第二种情况还需要满足正则条件(regularity condition),即存在常数 ,使得对足够大的 有 .
证明思路是将规模为 的问题,分解为 个规模为 的问题,然后依次合并,直到合并到最高层.每一次合并子问题,都需要花费 的时间.
证明
依据上文提到的证明思路,具体证明过程如下:
对于第 层(最高层),合并子问题需要花费 的时间.
对于第 层(第一次划分出来的子问题),共有 个子问题,每个子问题合并需要花费 的时间,所以合并总共要花费 的时间.
层层递推,我们可以画出如下递归树:

这棵树在第 层到达终点,共有 个叶子.非叶层的编号为 ,从而 ,其中 .
对于第一种情况:,因此 .
对于第二种情况,首先根节点的成本 .由正则条件,在子问题规模仍足够大时,第 层的总成本至多为 ,这些层的成本之和为 .剩余的底部常数层和叶子的总成本为 ,因此 .
对于第三种情况,令 .对规模足够大的子问题,第 层的总成本为 ,其中 为固定常数.取固定的 ,使 能达到该规模,由 可知这些层的总成本为 .其余底部常数层和叶子的总成本为 ,加上后即得结论.
下面举几个例子来说明主定理如何使用.
-
,那么 ,那么 可以取值在 之间,从而满足第一种情况,所以 ;
-
,那么 ,那么 可以取值在 之间,从而满足第二种情况,所以 ;
-
,那么 ,那么 可以取值为 ,从而满足第三种情况,所以 ;
-
,那么 ,那么 可以取值为 ,从而满足第三种情况,所以 .
均摊复杂度
空间复杂度
类似地,算法所使用的空间随输入规模变化的趋势可以用 空间复杂度 来衡量.
计算复杂性
本文主要从算法分析的角度对复杂度进行了介绍,如果有兴趣的话可以在 计算复杂性 进行更深入的了解.
本页面最近更新:2026/9/28 01:09:54,更新历史
发现错误?想一起完善? 在 GitHub 上编辑此页!
本页面贡献者:Ir1d, Tiphereth-A, ouuan, Enter-tainer, GuanghaoYe, Persdre, c-forrest, CCXXXI, Great-designer, iamtwz, ksyx, linehk, shuzhouliu, sshwy, abc1763613206, aquastripe, Backl1ght, blackwhitetony, chinggg, Enonya, GreyTigerOIer, he-zhiyuan, isdanni, Konano, lailai0916, Marcythm, Menci, mgt, nullnan, onelittlechildawa, partychicken, persdre, shawlleyw, TianyiQ, wr786, Xeonacid, YHN-ice, yyyu-star, zirnc
本页面的全部内容在 CC BY-SA 4.0 和 SATA 协议之条款下提供,附加条款亦可能应用











暂无评论内容