


如果发生了5xx错误,却没有人看到,它还算错误吗?
无论软件测试多么严格、持续多久,生产环境总能揭示新的缺陷。可能是仅在真实流量不可预测的并发模式下发生的奇怪竞态条件,也可能是用户输入了你完全想不到的数据,导致输入校验崩溃。无论哪种情况,“抛出500”都是一件大事。
HTTP 5xx错误会直接呈现在用户面前,让企业十分尴尬,短时间内就可能损害声誉。而且,在生产环境中调试这些错误可能极其困难。首先,日志数据量巨大,定位问题会话如同大海捞针。即使已经汇总所有组件的日志,也未必有足够数据理解问题。
将NGINX用作应用的反向代理或负载均衡器时,有些功能可以帮助你在生产环境中调试。本文将围绕一种典型反向代理应用架构,介绍error_page指令的一种具体用法,并加入一点特别设计。
引入调试服务器
这个特别设计是部署一台专用应用服务器——称为调试服务器(Debug Server)——只把在普通应用服务器上造成错误的请求发送给它。NGINX能够检测上游应用服务器返回的5xx错误,并使用另一个上游组重试相关请求;这里的另一个上游组包含调试服务器。因此,调试服务器只接收已经产生错误的请求,其日志文件只包含错误事件,可以直接用于调查。原本从一堆干草中找针,现在只需检查一小把针。
与主要应用服务器不同,调试服务器无需围绕性能构建。因此,可以启用所有可用的日志与诊断工具,例如:
- 以调试模式运行应用,启用完整堆栈跟踪。
- 应用服务器的调试日志。
- 应用性能剖析,以识别进程间超时。
- 记录服务器资源使用情况。
这些调试工具通常只在开发环境使用,因为生产环境需要为性能优化。不过,调试服务器只接收出错的请求,因此可以在尽可能多的组件上启用调试模式。
我们的应用基础架构如下图所示。
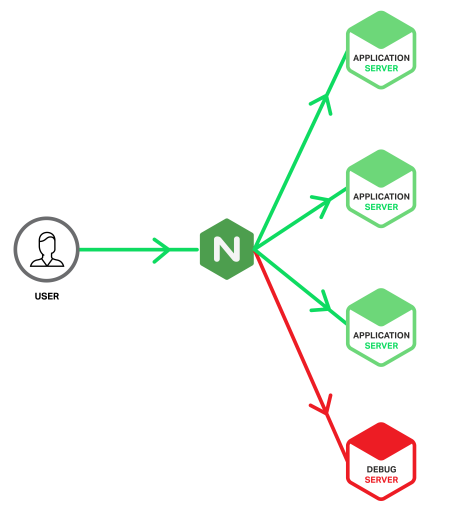
理想情况下,调试服务器的部署与配置应和应用服务器相同。不过,将调试服务器构建为虚拟机也有好处:可以克隆、复制它,进行离线分析。但这也带来风险——严重问题导致5xx错误突然激增时,服务器可能承受不住。使用NGINX Plus时,可以在server指令中加入max_conns参数,限制发送给调试服务器的并发连接数量,以防止这种突增(见下方示例配置)。 (max_conns)
此外,调试服务器的负载不像主应用服务器那么高,因此,主应用服务器上产生5xx的请求,在调试服务器上未必也会出错。这可能意味着主应用服务器已经接近扩展极限,真正的原因是资源耗尽,而非软件缺陷。无论根因是什么,这种情况都能避免用户遭遇5xx错误,从而改善体验。
配置
以下NGINX示例配置展示如何让调试服务器接收已经在主应用服务器上产生5xx错误的请求。
upstream app_server {
  server 172.16.0.1;
  server 172.16.0.2;
  server 172.16.0.3;
}

upstream debug_server {
  server 172.16.0.9 max_conns=20;
}

server {
  listen *:80;
  location / {
    proxy_pass http://app_server;
    proxy_intercept_errors on;
    error_page 500 503 504 @debug;
  }
  location @debug {
    proxy_pass http://debug_server;
    access_log /var/log/nginx/access_debug_server.log detailed;
    error_log /var/log/nginx/error_debug_server.log;
  }
}
首先,在upstream app_server块中指定应用服务器地址,然后在upstream debug_server块中指定调试服务器的单一地址。 (upstream)
第一个location块配置一个简单的反向代理,使用proxy_pass指令在app_server上游组的应用服务器间分配请求(没有指定负载均衡算法,因此采用默认的轮询算法)。proxy_intercept_errors指令表示HTTP状态码为300或更高的响应由error_page指令处理。本配置只拦截500、503和504错误,并将其交给@debug位置。404等其他状态码原样返回给客户端。 (location;proxy_pass;proxy_intercept_errors;error_page)
location @debug块做两件事。首先,把所有请求代理到debug_server上游组,其中包含专用调试服务器。其次,将日志条目同时写入单独的访问日志与错误日志。将应用服务器错误请求产生的消息与普通访问消息分离后,更容易把这些错误与调试服务器自身产生的错误关联起来。
注意,access_log指令引用了名为detailed的特殊日志格式。我们在顶层http上下文内、server块之前加入以下log_format指令来定义它。 (access_log;log_format)
log_format detailed '$remote_addr - $remote_user [$time_local] '
                    '"$request" $status $body_bytes_sent "$http_referer" '
                    '"$http_user_agent" $request_length $request_time '
                    '$upstream_response_length $upstream_response_time '
                    '$upstream_status';
detailed格式在默认combined格式上增加了五个变量,提供更多关于转发到调试服务器的请求及其响应的信息。
- $request_length——请求总大小,包含请求头和请求体,单位为字节。
- $request_time——请求处理时间,原文表述为毫秒;实际变量单位见下方核验提示。
- $upstream_response_length——从调试服务器获得的响应长度,单位为字节。
- $upstream_response_time——接收调试服务器响应所花的时间,原文表述为毫秒;实际变量单位见下方核验提示。
- $upstream_status——调试服务器响应的状态码。
这些额外日志字段对于识别格式不正确的请求和耗时过长的请求十分有用。后者可能指向应用内部超时,或其他进程间通信问题。
重试请求时考虑幂等性
有时,你可能不希望将失败请求发送给调试服务器。例如,应用或API在处理一个涉及多条数据库记录修改的请求时,中途失败;重试这个请求可能再次执行已经成功完成的数据库操作。这可能让数据库比完全不重试时更加混乱。
只有请求是幂等的,重试才安全——也就是说,无论执行多少次,结果始终相同。HTTP GET、PUT和DELETE请求被定义为幂等,而POST不是幂等的。不过,对你的应用来说,哪些HTTP方法实际具有幂等性,可能与官方定义不同。
幂等性问题让调试服务器有三种选择:
- 让调试服务器使用只读数据库连接。因为根本不能修改数据,重复请求是安全的。仍然记录产生5xx错误的请求,但调试服务器提供的诊断信息较少,调查根因的能力也受到限制。
- 只向调试服务器发送幂等请求。这能隔离产生5xx错误的请求,但不包括使用POST方法的请求。
- 部署第二台调试服务器,使用只读数据库连接,并把非幂等请求发送给它;幂等请求继续发送给主要调试服务器。这样可以捕获全部失败请求,但需要第二台服务器及更多配置。
为了完整起见,下面查看方案3的配置,并突出显示与前一份配置不同的部分。
upstream app_server {
  server 172.16.0.1;
  server 172.16.0.2;
  server 172.16.0.3;
}

upstream debug_server {
  server 172.16.0.9 max_conns=20;
}

upstream readonly_server {
  server 172.16.0.10 max_conns=20;
}

map $request_method $debug_location {
  'POST' @readonly;
  'LOCK' @readonly;
  'PATCH' @readonly;
  default @debug;
}

server {
  listen *:80;
  location / {
    proxy_pass http://app_server;
    proxy_intercept_errors on;
    error_page 500 503 504
    $debug_location;
  }

  location @debug {
    proxy_pass http://debug_server;
    access_log /var/log/nginx/access_debug_server.log detailed;
    error_log /var/log/nginx/error_debug_server.log;
  }

  location @readonly {
    proxy_pass http://readonly_server;
    access_log /var/log/nginx/access_readonly_server.log detailed;
    error_log /var/log/nginx/error_readonly_server.log;
  }
}
部署新的只读调试服务器后,map指令使用$request_method变量,根据请求方法的幂等性设置新变量$debug_location。执行到error_page指令时,使用$debug_location变量,把请求处理引导到适合该HTTP方法的调试服务器。 (map;$request_method)
常见做法是使用proxy_next_upstream指令,让NGINX在上游组剩余服务器上重试失败请求,然后再尝试调试服务器。它通常用于网络层错误,但也可以扩展到5xx错误。在NGINX开源版1.9.13及之后版本中,默认不会重试因5xx错误失败的非幂等请求。如果可以接受重试非幂等请求,就在proxy_next_upstream指令中加入non_idempotent参数。NGINX Plus R9及之后版本也启用了这个行为与新参数。 (proxy_next_upstream)
location / {
  proxy_pass http://app_server;
  proxy_next_upstream http_500 http_503 http_504
  non_idempotent;
  proxy_intercept_errors on;
  error_page 500 503 504 @debug;
}
结论
抛出500错误是一件大事。无论你采用DevOps模式、试验持续交付,还是只想减轻一次性大规模升级的风险,NGINX都提供了工具,帮助你更好地应对真实环境中的问题。
原文封面摄影:Tony Moorey(CC)。 (Tony Moorey)











暂无评论内容