


回想你最近交付的一个大型功能:你把它塞进一个巨大的拉取请求(PR),还是拆成范围更小的多个 PR?多年来,开发者总在两种选择中权衡:要么让一个 PR 越长越大,最终难以评审;要么把它拆成一串小 PR,但必须手动照看、同步,并在底层引入改动后不断解决冲突。
两种方式各有代价:一种难评审,另一种难维护。当天的选择往往只是看哪一种更不痛苦。
再加上编码智能体。它们产出很快。原文援引 Gartner 的预测,到2028年,智能体将在软件开发生命周期的各阶段带来50%的生产率提升。不过,智能体无法替你决定如何组织 PR,它们反而让这项决策更必要。
下面通过一个例子,演示如何使用堆叠 PR 简化评审。
具体案例:为购物助手添加产品搜索
假设你发出提示,让智能体为购物助手添加产品搜索,然后离开几分钟,再回来评审、调整并批准。但看看通常会落进这一个 PR 的内容:
- 新的数据模型和种子数据。
- API 路由及输入验证。
- 客户端接线、UI,以及空结果、回退和错误状态。
所有这些,以及更多改动,都在一个超过1000行的巨大 diff 中。
智能体主要从传统代码编写方式中训练而来,因此这也是它们默认的交付方式。让我们把这个过程走一遍。
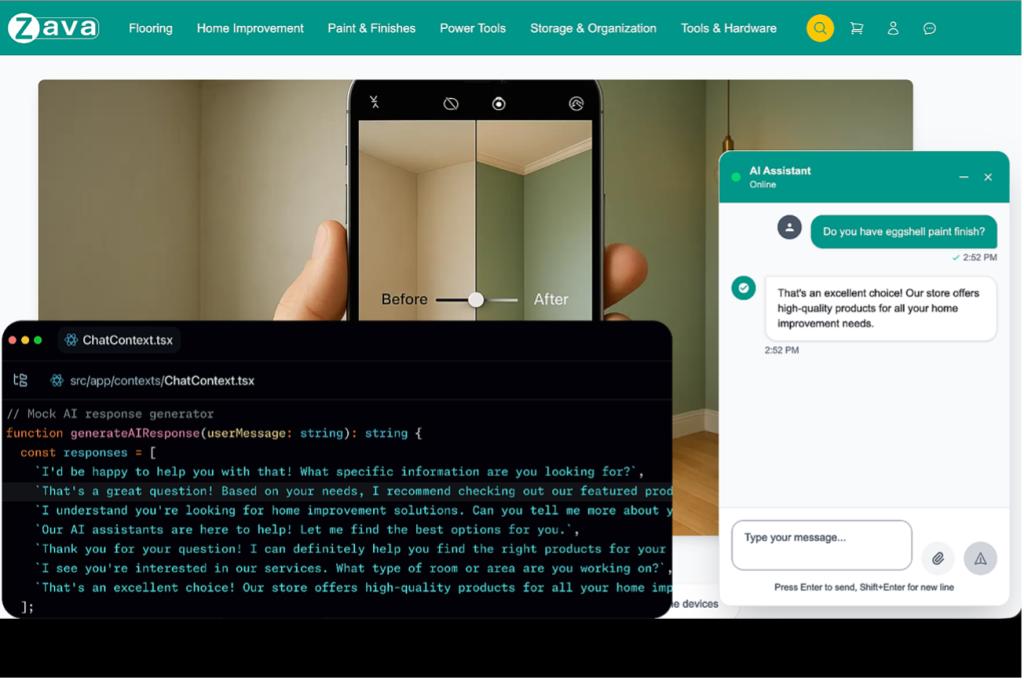
现有 Web 应用的起点是:
- 一个从随机句子生成器获取回复的模拟 AI 助手。
- 产品数据不一致,硬编码并分散在各组件里。
- 没有目录模块、API、数据层,什么都没有。
为实现该功能创建一个 issue,典型流程是创建功能分支,交给一个编码智能体,或多个自定义智能体,得到整套实现及更新后的测试的初稿。然后你阅读代码——也许读了——还需手动验证功能、作必要修改、推送并创建 PR。PR 附带一份冗长却肤浅的 AI 生成描述,你确认 CI 通过、自查 diff,再请求评审。
评审者:改了1721行!描述也没什么帮助。我晚点再看。
随后是熟悉的问题:
- 巨大的 PR 难以评审,于是一直搁着。
- 评审者丢失上下文,反馈质量下降。
- 合并更慢。
功能落地前,由此展开一个手动、混乱、耗时而且易冲突的过程;最后往往在评审不足的情况下合并。
GitHub 堆叠拉取请求
堆叠 PR 提供另一种交付结构,原则很简单:拆分。不再追求用一个 PR 完整解决 issue,而是把功能拆成逻辑层,识别到达最终目标的依赖链。你和智能体可以用原生方式,把原本会成为一个巨型 PR 的工作拆成一串小、专注、能够独立评审的层。
难评审的大 PR 变成多个逻辑有序的小 PR:每个聚焦一种关注点,小到评审者可以掌握全部内容,并自然承接前一个已经评审的 PR 的必要上下文。
下面开始实现。
堆叠结构
首先设置堆叠基底。这很关键,因为堆叠管理全过程中的 CI 检查和合并规则,都会依据基底进行评估。
再找出最核心的基础工作,把它放在靠近基底的位置,即堆叠底部;依赖它的工作依次放在上层。
| 层/分支 | 交付内容 | 依赖 |
|---|---|---|
| L1(feat/catalog-data) | 带类型的产品目录、种子数据、验证和数据访问模块 | main(堆叠基底) |
| L2(feat/search-api) | 经过验证的 /api/products/search 端点 | feat/catalog-data |
| L3(feat/chat-grounding) | 聊天调用API,用真实产品数据回答 | feat/search-api |
| L4(feat/grounded-ui) | 产品引用卡片及状态处理 | feat/chat-grounding |
数据、API、接线、用户体验的独立关注点由此变得清楚,可以分别分配给不同评审者:数据负责人评审数据,UI 负责人评审体验。
GitHub 原生的堆叠 PR 支持可以从 PR 界面启动,也通过 gh stack CLI 延伸到终端。
安装堆叠 PR CLI 扩展
运行:
gh extension install github/gh-stack过去做到这里就可以开始工作。但现在有智能体与你协作,需要让它们学会如何创建和管理堆叠。gh-stack skills 教授的正是这些能力:
gh skill install github/gh-stack或者使用:
npx skills add github/gh-stack针对本例功能,工作流中的自定义智能体各有明确工作范围,并严格限定改动范围,以得到小而单一职责的 PR。
| 层/分支 | 智能体 |
|---|---|
| L1(feat/catalog-data) | 数据建模智能体 |
| L2(feat/search-api) | 后端智能体 |
| L3(feat/chat-grounding) | 前端智能体 |
| L4(feat/grounded-ui) | 前端智能体 |
最后确认 CI 已存在。每个 PR 会依据堆叠基底进行评估,各层都运行这些检查。现在开始工作。
第一层:产品目录基础
如今许多智能体工作流会自动化地自主循环运行,但为了说明,这里按步骤介绍:
- 用适当提示调用数据建模智能体。
- 智能体用
gh init stack初始化新堆叠,把main设为第一分支feat/catalog-data的基底。 - 检出分支,完成工作并运行验证。
- 全部检查通过就提交该层,否则继续迭代。
第二层:产品搜索 API
流程类似:
- 用适当提示调用后端智能体。
- 智能体用
gh stack add在第一层上增加feat/search-api;基底是feat/catalog-data,可以导入完成的数据访问模块。 - 检出分支,完成工作并运行验证。
- 开发者手动测试 API。
- API 能正常工作且全部检查通过,才提交本层,否则继续迭代。
第三层:将聊天连接到 API
- 用适当提示调用前端智能体。
- 在第二层之上增加
feat/chat-grounding,基底是feat/search-api。该分支具备数据访问模块和经过验证的 API。 - 检出分支,完成工作并运行 Playwright 浏览器测试。
- 全部检查通过则提交本层,否则继续迭代。
第四层:有数据依据的 UI 与引用
第三层和第四层虽由同一个前端智能体编写,却刻意分开。UI 负责人不应被迫检查底层数据流,反之亦然。这个结构支持独立评审。
- 在第三层之上增加
feat/grounded-ui,基底是feat/chat-grounding。 - 检出分支,完成工作并运行 Playwright 浏览器测试。
- 全部检查通过则提交,否则继续迭代。
提交堆叠
四个本地堆叠分支准备好了。先用 gh stack push 推送到远程,再用 gh stack submit 在 GitHub 上创建相互关联的 PR。
堆叠地图与每层 CI
切到 GitHub,四个 PR 已打开。每个 PR 顶部都有堆叠地图,允许单击切换到堆叠中的其他 PR。
评审并更新堆叠
现在换到评审者视角。堆叠地图像指南针,帮助评审者在顶部和底部之间导航,最终成功合并。方向是:自上而下理解,自下而上评审。
- 自上而下阅读以获得上下文:在开始评审时就知道最终目标,例如“我们要在聊天界面显示产品卡片”。
- 自下而上评审:逐步建立预设检查点。理解前一层以后,后一层的实现才有意义。
无需像本例最初那样,一次评审1720多行的 PR;评审可以分成堆叠中小而自包含的目标。
作为参与循环的人类评审者,你从底部第一层开始,看到自动 Copilot Code Review(CCR)捕获了两个问题,并同意需要修复。
底层收到了修改请求,开发者接下来:
- 把反馈交给拥有第一层分支的数据建模智能体。
- 应用建议,测试、提交并推送。
- 修复落进
feat/catalog-data后,考虑第二、第三、第四层如何随之变化。
由于 feat/catalog-data 在评审后单独推送,GitHub 标出“Some branches in this stack have diverged and must be rebased”(堆叠中的部分分支已分叉,必须变基),并显示“Unable to merge as a stack”(无法作为堆叠合并),阻止合并。
PR 页面会出现一键Rebase stack按钮。使用前要注意:网页变基在 GitHub 服务器上运行,会把提交者(committer)设为点击按钮的人,产生的提交没有签名。如果分支保护要求签名提交,这次点击就可能导致检查失败。
终端中的对应做法是运行 gh stack rebase,在本地使用自己的 Git 配置进行同样的级联变基、交互解决冲突,然后执行 gh stack push。
最后用 gh stack sync 同步堆叠,让本地与 GitHub 上的其他层赶上最新变化。
这一整合流程先从 origin 拉取,然后将 feat/catalog-data 之上的各分支逐层变基到新提交,推送变基后的分支,并同步 GitHub PR 状态。改动由此向上传递,无需手动处理第二、第三、第四层。
回到 GitHub,所有检查重新运行并通过,堆叠地图恢复为从 main 到 feat/grounded-ui 的清晰、可合并直线。











暂无评论内容