


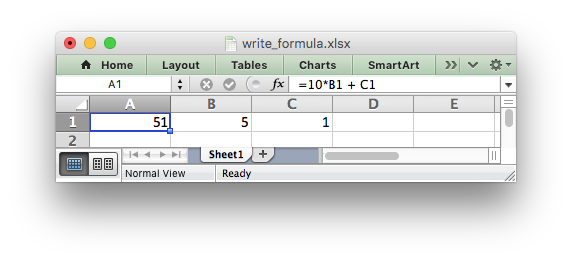
通常,Excel 中的公式可以直接交给 write_formula() 方法使用:
worksheet.write_formula('A1', '=10*B1 + C1')
不过,这里存在一些需要了解的潜在问题与差异,下面逐一说明。
非美国地区的 Excel 函数与语法
无论最终用户的 Excel 使用哪种语言或地区设置,Excel 文件内部都以美国英语版本的格式存储公式。因此,使用 XlsxWriter 写入的所有公式函数名都必须是英文:
worksheet.write_formula('A1', '=SUM(1, 2, 3)')    # OK
worksheet.write_formula('A2', '=SOMME(1, 2, 3)')  # French. Error on load.
公式也必须使用美国风格的分隔符或范围运算符,即逗号,而不是分号。包含多个值的公式应这样写:
worksheet.write_formula('A1', '=SUM(1, 2, 3)')   # OK
worksheet.write_formula('A2', '=SUM(1; 2; 3)')   # Semi-colon. Error on load.
如果使用非英文版 Excel,可以通过多语言公式翻译器转换公式;该工具也能将分号替换成逗号。
公式结果
XlsxWriter 不会计算公式结果,而是把数值 0 保存为公式的缓存结果。随后,它会在 XLSX 文件中设置一个全局标志,要求应用在打开文件时重新计算全部公式和函数。
这是 Excel 文档推荐的方法,在电子表格应用中通常能正常工作。不过,没有公式计算功能的应用只会显示缓存的 0,例如 Excel Viewer、PDF 转换器,以及部分移动设备应用。
如有需要,可以通过 write_formula() 的可选 value 参数提供已经计算好的结果:
worksheet.write_formula('A1', '=2+2', num_format, 4)
value 可以是数字、字符串、布尔值,也可以是下列 Excel 错误代码之一:
#DIV/0!
#N/A
#NAME?
#NULL!
#NUM!
#REF!
#VALUE!
通过 write_array_formula() 创建数组公式时,也可以指定计算结果:
# Specify the result for a single cell range.
worksheet.write_array_formula('A1:A1', '{=SUM(B1:C1*B2:C2)}', cell_format, 2005)
不过,该参数只会为结果数组左上角的单元格写入一个值。如果多单元格数组公式需要全部缓存结果,可以用 write_number() 将其余结果写入相应单元格:
# Specify the results for a multi cell range.
worksheet.write_array_formula('A1:A3', '{=TREND(C1:C3,B1:B3)}', cell_format, 15)
worksheet.write_number('A2', 12, cell_format)
worksheet.write_number('A3', 14, cell_format)
动态数组支持
Excel 在 Office 365 中引入了“动态数组”,并新增了使用动态数组的函数:
BYCOL()BYROW()CHOOSECOLS()CHOOSEROWS()DROP()EXPAND()FILTER()HSTACK()MAKEARRAY()MAP()RANDARRAY()REDUCE()SCAN()SEQUENCE()SORT()SORTBY()SWITCH()TAKE()TEXTSPLIT()TOCOL()TOROW()UNIQUE()VSTACK()WRAPCOLS()WRAPROWS()XLOOKUP()
动态数组还引入了以下特殊函数:
SINGLE():见下文关于隐式交集运算符@的说明。ANCHORARRAY():见下文关于溢出范围运算符#的说明。LAMBDA()和LET():见下文关于 Excel 365LAMBDA()的说明。
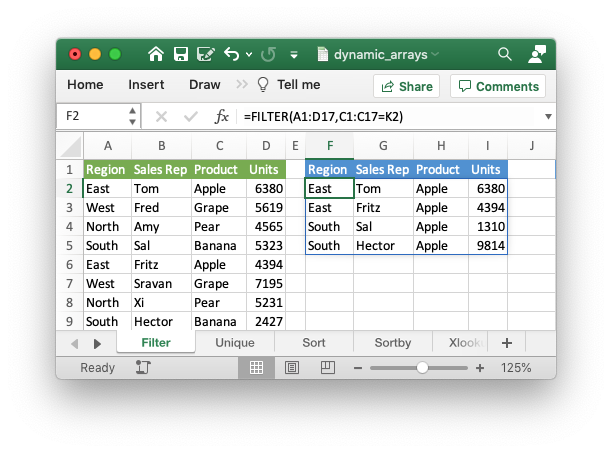
动态数组是一组返回值,其范围大小可随计算结果变化。例如,FILTER() 会返回一个数组,数组大小取决于筛选结果。下面的代码摘自动态数组公式示例:
worksheet1.write('F2', '=FILTER(A1:D17,C1:C17=K2)')
结果如下图所示。这里的动态范围是 F2:I5,但筛选条件改变时,范围也可能不同。
旧的 Excel 函数也能表现出动态数组行为。例如,=LEN(A1) 作用于单个单元格,返回一个值;也可以通过 {=LEN(A1:A3)} 这样的数组公式,对一组单元格计算并返回一组值。这种“静态”数组公式称为 CSE 公式,因为传统上要用 Ctrl+Shift+Enter 输入。
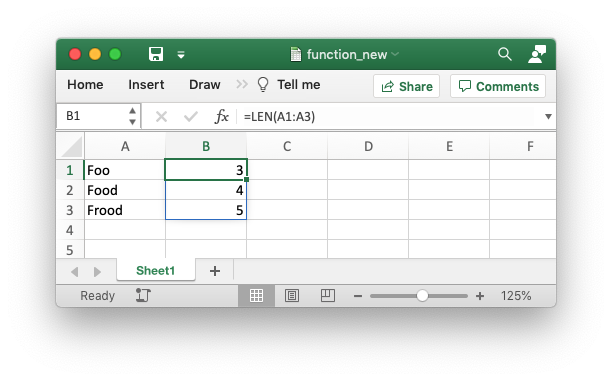
Excel 365 引入动态数组后,可以直接写 =LEN(A1:A3),获得动态范围的返回值。在 XlsxWriter 中,工作表方法 write_array_formula() 用于静态/CSE 数组,而 write_dynamic_array_formula() 用于动态数组。例如:
worksheet.write_dynamic_array_formula('B1:B3', '=LEN(A1:A3)')
其结果如下:
两类数组函数的区别见微软文档动态数组公式与传统 CSE 数组公式。其中把 CSE 称为“传统”公式,文档内容也表明动态数组对 Excel 今后的发展很重要。更广泛的入门介绍可参阅 Excel 动态数组公式。
动态数组:隐式交集运算符 @
Excel 365 使用隐式交集运算符 @,标识公式中本来可能返回范围或数组、但实际上隐式返回单个值的位置。
以前面使用的 =LEN(A1:A3) 为例。在不支持动态数组的 Excel 版本,也就是 Excel 365 之前的版本中,该公式会取输入范围中的一个值进行计算,并返回单个结果:
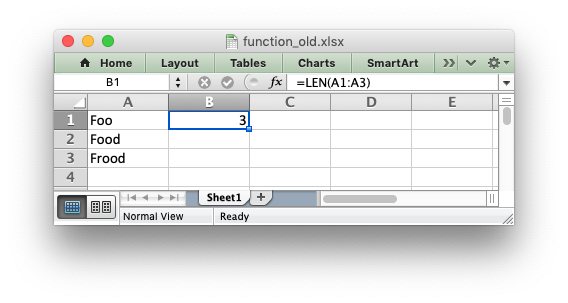
这里发生了隐式转换:输入范围 A1:A3 被转换为单个值 A1。由于这是旧版 Excel 的默认行为,界面不会特别标明这种转换。但是,在 Excel 365 中打开同一个文件时,会看到:
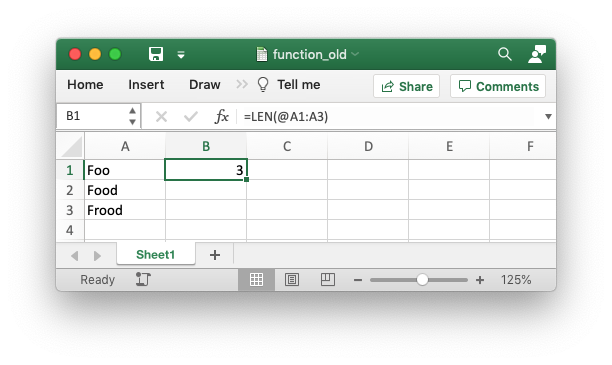
需要特别注意,公式结果没有改变:它仍然只操作并返回一个值。差别在于公式中出现了 @,明确说明它从指定范围中隐式使用了单个值。
最后,如果在 Excel 365 中直接输入该公式,或者在 XlsxWriter 中使用 write_dynamic_array_formula() 写入,它就会对整个范围操作,并返回一个值数组:
第一次接触 @ 时,常见疑问是:“为什么 Excel 或 XlsxWriter 在我的公式里加了 @?”实际处理时,如果不希望出现它,通常应将公式写成 CSE 数组公式或动态数组公式,也就是使用 write_array_formula() 或 write_dynamic_array_formula()。
完整解释见微软文档隐式交集运算符 @。
另一个重要细节是:@ 并不会随传统公式一起存储,只是 Excel 365 读取传统公式时显示出来的标记。不过,必要时也可以使用 SINGLE() 或 _xlfn.SINGLE(),把对应行为明确写入公式。上面的微软文档介绍了可能需要这样做的少见情况。
动态数组:溢出范围运算符 #
动态数组公式可以返回大小不固定的结果范围。Excel 文档将其称为“溢出”范围或数组,因为结果会扩展到所需数量的单元格中。更多说明见动态数组公式和溢出数组行为。
由于溢出范围大小会变化,需要一种新的方式引用它:溢出范围运算符 #。下图中的 F2# 引用了单元格 F2 中 UNIQUE() 返回的动态数组。示例同样来自 XlsxWriter 的动态数组公式示例。
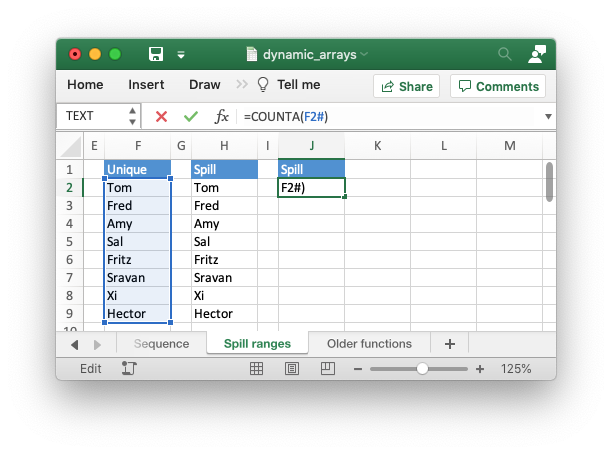
不过,Excel 内部并不按这种形式保存公式。在 XlsxWriter 中,需要用显式函数 ANCHORARRAY() 引用溢出范围。上图通过以下代码生成:
worksheet9.write('J2', '=COUNTA(ANCHORARRAY(F2))') # Same as '=COUNTA(F2#)' in Excel.
Excel 365 的 LAMBDA() 函数
较新的 Excel 365 引入了功能强大的 LAMBDA(),它类似于 Python 及其他语言中的 lambda 函数。
下面的 Excel 表达式将变量 temp 从华氏温度转换为摄氏温度:
LAMBDA(temp, (5/9) * (temp-32))
可以直接传入参数调用它:
=LAMBDA(temp, (5/9) * (temp-32))(212)
也可以将其赋给一个定义名称,随后作为用户自定义函数调用:
=ToCelsius(212)
这与下面的 Python 示例相似:
>>> to_celsius = lambda temp: (5.0/9.0) * (temp-32)
>>> to_celsius(212)
100.0
Excel 365 LAMBDA() 示例给出了实现相同 Excel 效果的 XlsxWriter 程序。公式写法如下:
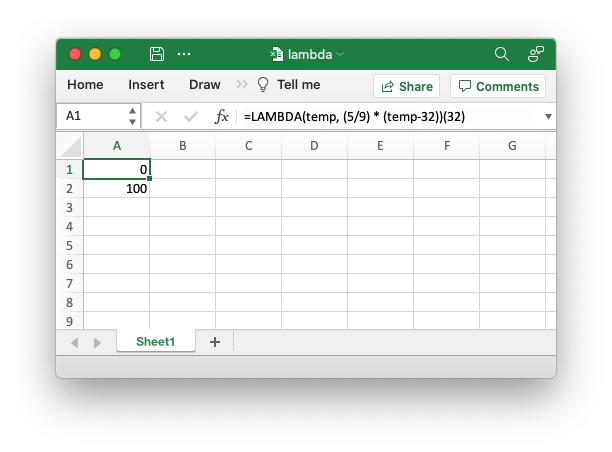
worksheet.write('A2', '=LAMBDA(_xlpm.temp, (5/9) * (_xlpm.temp-32))(32)')
注意,LAMBDA() 的参数必须带有 _xlpm. 前缀,以兼容 Excel 内部保存公式的方式。如下图所示,Excel 中显示公式时不会出现这些前缀。
LET() 常与 LAMBDA() 配合,用来给计算结果命名。
Excel 2010 及之后版本新增的公式
Excel 2010 及之后的版本加入了一些原始文件规范未定义的函数。微软将它们称为“未来函数”(future functions),例如 ACOT、CHISQ.DIST.RT、CONFIDENCE.NORM、STDEV.P、STDEV.S 和 WORKDAY.INTL。
通过 write_formula() 写入时,需要按下方清单使用完整限定名,加上 _xlfn. 或其他规定前缀。例如:
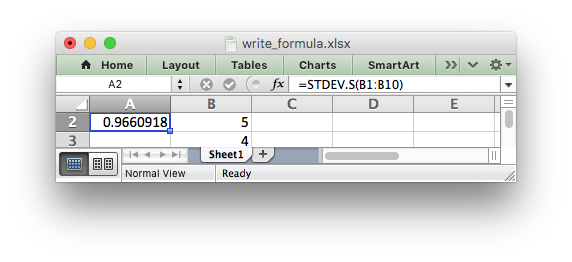
worksheet.write_formula('A1', '=_xlfn.STDEV.S(B1:B10)')
Excel 显示这些函数时不会显示前缀:
另一种方法是在 Workbook() 构造函数中启用 use_future_functions,让 XlsxWriter 按需自动添加前缀:
workbook = Workbook('write_formula.xlsx', {'use_future_functions': True})

# ...

worksheet.write_formula('A1', '=STDEV.S(B1:B10)')
如果公式中的任意函数已经包含 _xlfn. 前缀,该公式将被跳过,不再进一步展开。
注意:启用 use_future_functions 会给 XlsxWriter 的所有公式处理增加开销。如果应用包含大量公式,或者对性能敏感,最好显式使用 _xlfn. 前缀。
以下清单摘自微软 XLSX 扩展规范的未来函数文档:
_xlfn.ACOTH_xlfn.ACOT_xlfn.AGGREGATE_xlfn.ARABIC_xlfn.ARRAYTOTEXT_xlfn.BASE_xlfn.BETA.DIST_xlfn.BETA.INV_xlfn.BINOM.DIST.RANGE_xlfn.BINOM.DIST_xlfn.BINOM.INV_xlfn.BITAND_xlfn.BITLSHIFT_xlfn.BITOR_xlfn.BITRSHIFT_xlfn.BITXOR_xlfn.CEILING.MATH_xlfn.CEILING.PRECISE_xlfn.CHISQ.DIST.RT_xlfn.CHISQ.DIST_xlfn.CHISQ.INV.RT_xlfn.CHISQ.INV_xlfn.CHISQ.TEST_xlfn.COMBINA_xlfn.CONCAT_xlfn.CONFIDENCE.NORM_xlfn.CONFIDENCE.T_xlfn.COTH_xlfn.COT_xlfn.COVARIANCE.P_xlfn.COVARIANCE.S_xlfn.CSCH_xlfn.CSC_xlfn.DAYS_xlfn.DECIMALECMA.CEILING_xlfn.ERF.PRECISE_xlfn.ERFC.PRECISE_xlfn.EXPON.DIST_xlfn.F.DIST.RT_xlfn.F.DIST_xlfn.F.INV.RT_xlfn.F.INV_xlfn.F.TEST_xlfn.FILTERXML_xlfn.FLOOR.MATH_xlfn.FLOOR.PRECISE_xlfn.FORECAST.ETS.CONFINT_xlfn.FORECAST.ETS.SEASONALITY_xlfn.FORECAST.ETS.STAT_xlfn.FORECAST.ETS_xlfn.FORECAST.LINEAR_xlfn.FORMULATEXT_xlfn.GAMMA.DIST_xlfn.GAMMA.INV_xlfn.GAMMALN.PRECISE_xlfn.GAMMA_xlfn.GAUSS_xlfn.HYPGEOM.DIST_xlfn.IFNA_xlfn.IFS_xlfn.IMAGE_xlfn.IMCOSH_xlfn.IMCOT_xlfn.IMCSCH_xlfn.IMCSC_xlfn.IMSECH_xlfn.IMSEC_xlfn.IMSINH_xlfn.IMTAN_xlfn.ISFORMULA_xlfn.ISOMITTED_xlfn.ISOWEEKNUM_xlfn.LET_xlfn.LOGNORM.DIST_xlfn.LOGNORM.INV_xlfn.MAXIFS_xlfn.MINIFS_xlfn.MODE.MULT_xlfn.MODE.SNGL_xlfn.MUNIT_xlfn.NEGBINOM.DISTNETWORKDAYS.INTL_xlfn.NORM.DIST_xlfn.NORM.INV_xlfn.NORM.S.DIST_xlfn.NORM.S.INV_xlfn.NUMBERVALUE_xlfn.PDURATION_xlfn.PERCENTILE.EXC_xlfn.PERCENTILE.INC_xlfn.PERCENTRANK.EXC_xlfn.PERCENTRANK.INC_xlfn.PERMUTATIONA_xlfn.PHI_xlfn.POISSON.DIST_xlfn.QUARTILE.EXC_xlfn.QUARTILE.INC_xlfn.QUERYSTRING_xlfn.RANK.AVG_xlfn.RANK.EQ_xlfn.RRI_xlfn.SECH_xlfn.SEC_xlfn.SHEETS_xlfn.SHEET_xlfn.SKEW.P_xlfn.STDEV.P_xlfn.STDEV.S_xlfn.T.DIST.2T_xlfn.T.DIST.RT_xlfn.T.DIST_xlfn.T.INV.2T_xlfn.T.INV_xlfn.T.TEST_xlfn.TEXTAFTER_xlfn.TEXTBEFORE_xlfn.TEXTJOIN_xlfn.UNICHAR_xlfn.UNICODE_xlfn.VALUETOTEXT_xlfn.VAR.P_xlfn.VAR.S_xlfn.WEBSERVICE_xlfn.WEIBULL.DISTWORKDAY.INTL_xlfn.XMATCH_xlfn.XOR_xlfn.Z.TEST
前面介绍的动态数组函数也属于未来函数:
_xlfn.ANCHORARRAY_xlfn.BYCOL_xlfn.BYROW_xlfn.CHOOSECOLS_xlfn.CHOOSEROWS_xlfn.DROP_xlfn.EXPAND_xlfn._xlws.FILTER_xlfn.HSTACK_xlfn.LAMBDA_xlfn.MAKEARRAY_xlfn.MAP_xlfn.RANDARRAY_xlfn.REDUCE_xlfn.SCAN_xlfn.SINGLE_xlfn.SEQUENCE_xlfn._xlws.SORT_xlfn.SORTBY_xlfn.SWITCH_xlfn.TAKE_xlfn.TEXTSPLIT_xlfn.TOCOL_xlfn.TOROW_xlfn.UNIQUE_xlfn.VSTACK_xlfn.WRAPCOLS_xlfn.WRAPROWS_xlfn.XLOOKUP
由于这些函数是 Excel 一项重要新功能的组成部分,对最终用户很有价值,XlsxWriter 即使没有启用相应未来函数选项,也会自动将其简写转换为带显式前缀的完整形式。如果需要覆盖自动转换,可以直接使用上面列出的带前缀版本。
在公式中使用表格
使用 add_table() 可以向工作表添加表格:
worksheet.add_table('B3:F7', {options})
默认按照添加顺序将表格命名为 Table1、Table2 等,也可以通过 name 参数自行命名:
worksheet.add_table('B3:F7', {'name': 'SalesData'})
在公式中引用 TableX 这样的表名时,要使用 TableX[] 形式,类似 Python 列表:
worksheet.write_formula('A5', '=VLOOKUP("Sales", Table1[], 2, FALSE')
处理公式错误
公式语法有误时,Excel 通常显示 #NAME?;也可能在打开文件时发出警告。遇到这种情况,可按以下顺序排查:
- 把公式复制到 Excel 单元格,确认它在 Excel 中有效。应使用 Excel 本身,而不是 OpenOffice 或 LibreOffice,因为其他应用的语法可能略有差异。
- 确保公式使用逗号作为分隔符,而不是分号。
- 确保公式函数名使用英文。
- 检查是否包含上述 Excel 2010 及之后版本的未来函数;如果包含,确保前缀正确。
- 如果公式能加载,但 Excel 给它添加了一个或多个
@,它很可能属于数组公式,应使用write_array_formula()或write_dynamic_array_formula()写入。
如果完成这些步骤后仍然出现 #NAME?,可以检查一个有效的 Excel 文件,查看正确的内部语法。先在 Excel 中创建可用公式并保存文件,然后解压文件,检查其中的 XML。
下面使用 Linux 的 unzip 与 libxml 的 xmllint 格式化 XML,使其更易阅读:
$ unzip myfile.xlsx -d myfile
$ xmllint --format myfile/xl/worksheets/sheet1.xml | grep '</f>'

        <f>SUM(1, 2, 3)</f>
原文版权声明:© Copyright 2013-2025, John McNamara。许可信息见 XlsxWriter License。
原文:Working with Formulas。本文为该文档的中文译文,示例代码保留原文。











暂无评论内容