


本 Notebook 展示如何构建多模态检索增强生成(RAG)系统:使用 ColQwen2 检索文档,用 MonoQwen2-VL-v0.1 重排,再让 Qwen2-VL 视觉语言模型(VLM)生成答案。它们共同把文本型文档与视觉数据结合起来,改善查询响应。引入量化 VLM 后,这个 Notebook 针对单张消费级 GPU 的使用场景进行了优化。
这里不依赖复杂的 OCR 文档处理流水线,而是让文档检索模型直接根据用户问题找到最相关的文档,使系统更容易扩展,也更高效。
本教程延续了上一篇 使用文档检索(ColPali)与视觉语言模型构建多模态 RAG 的思路。尚未阅读的读者,建议先了解该 Notebook。
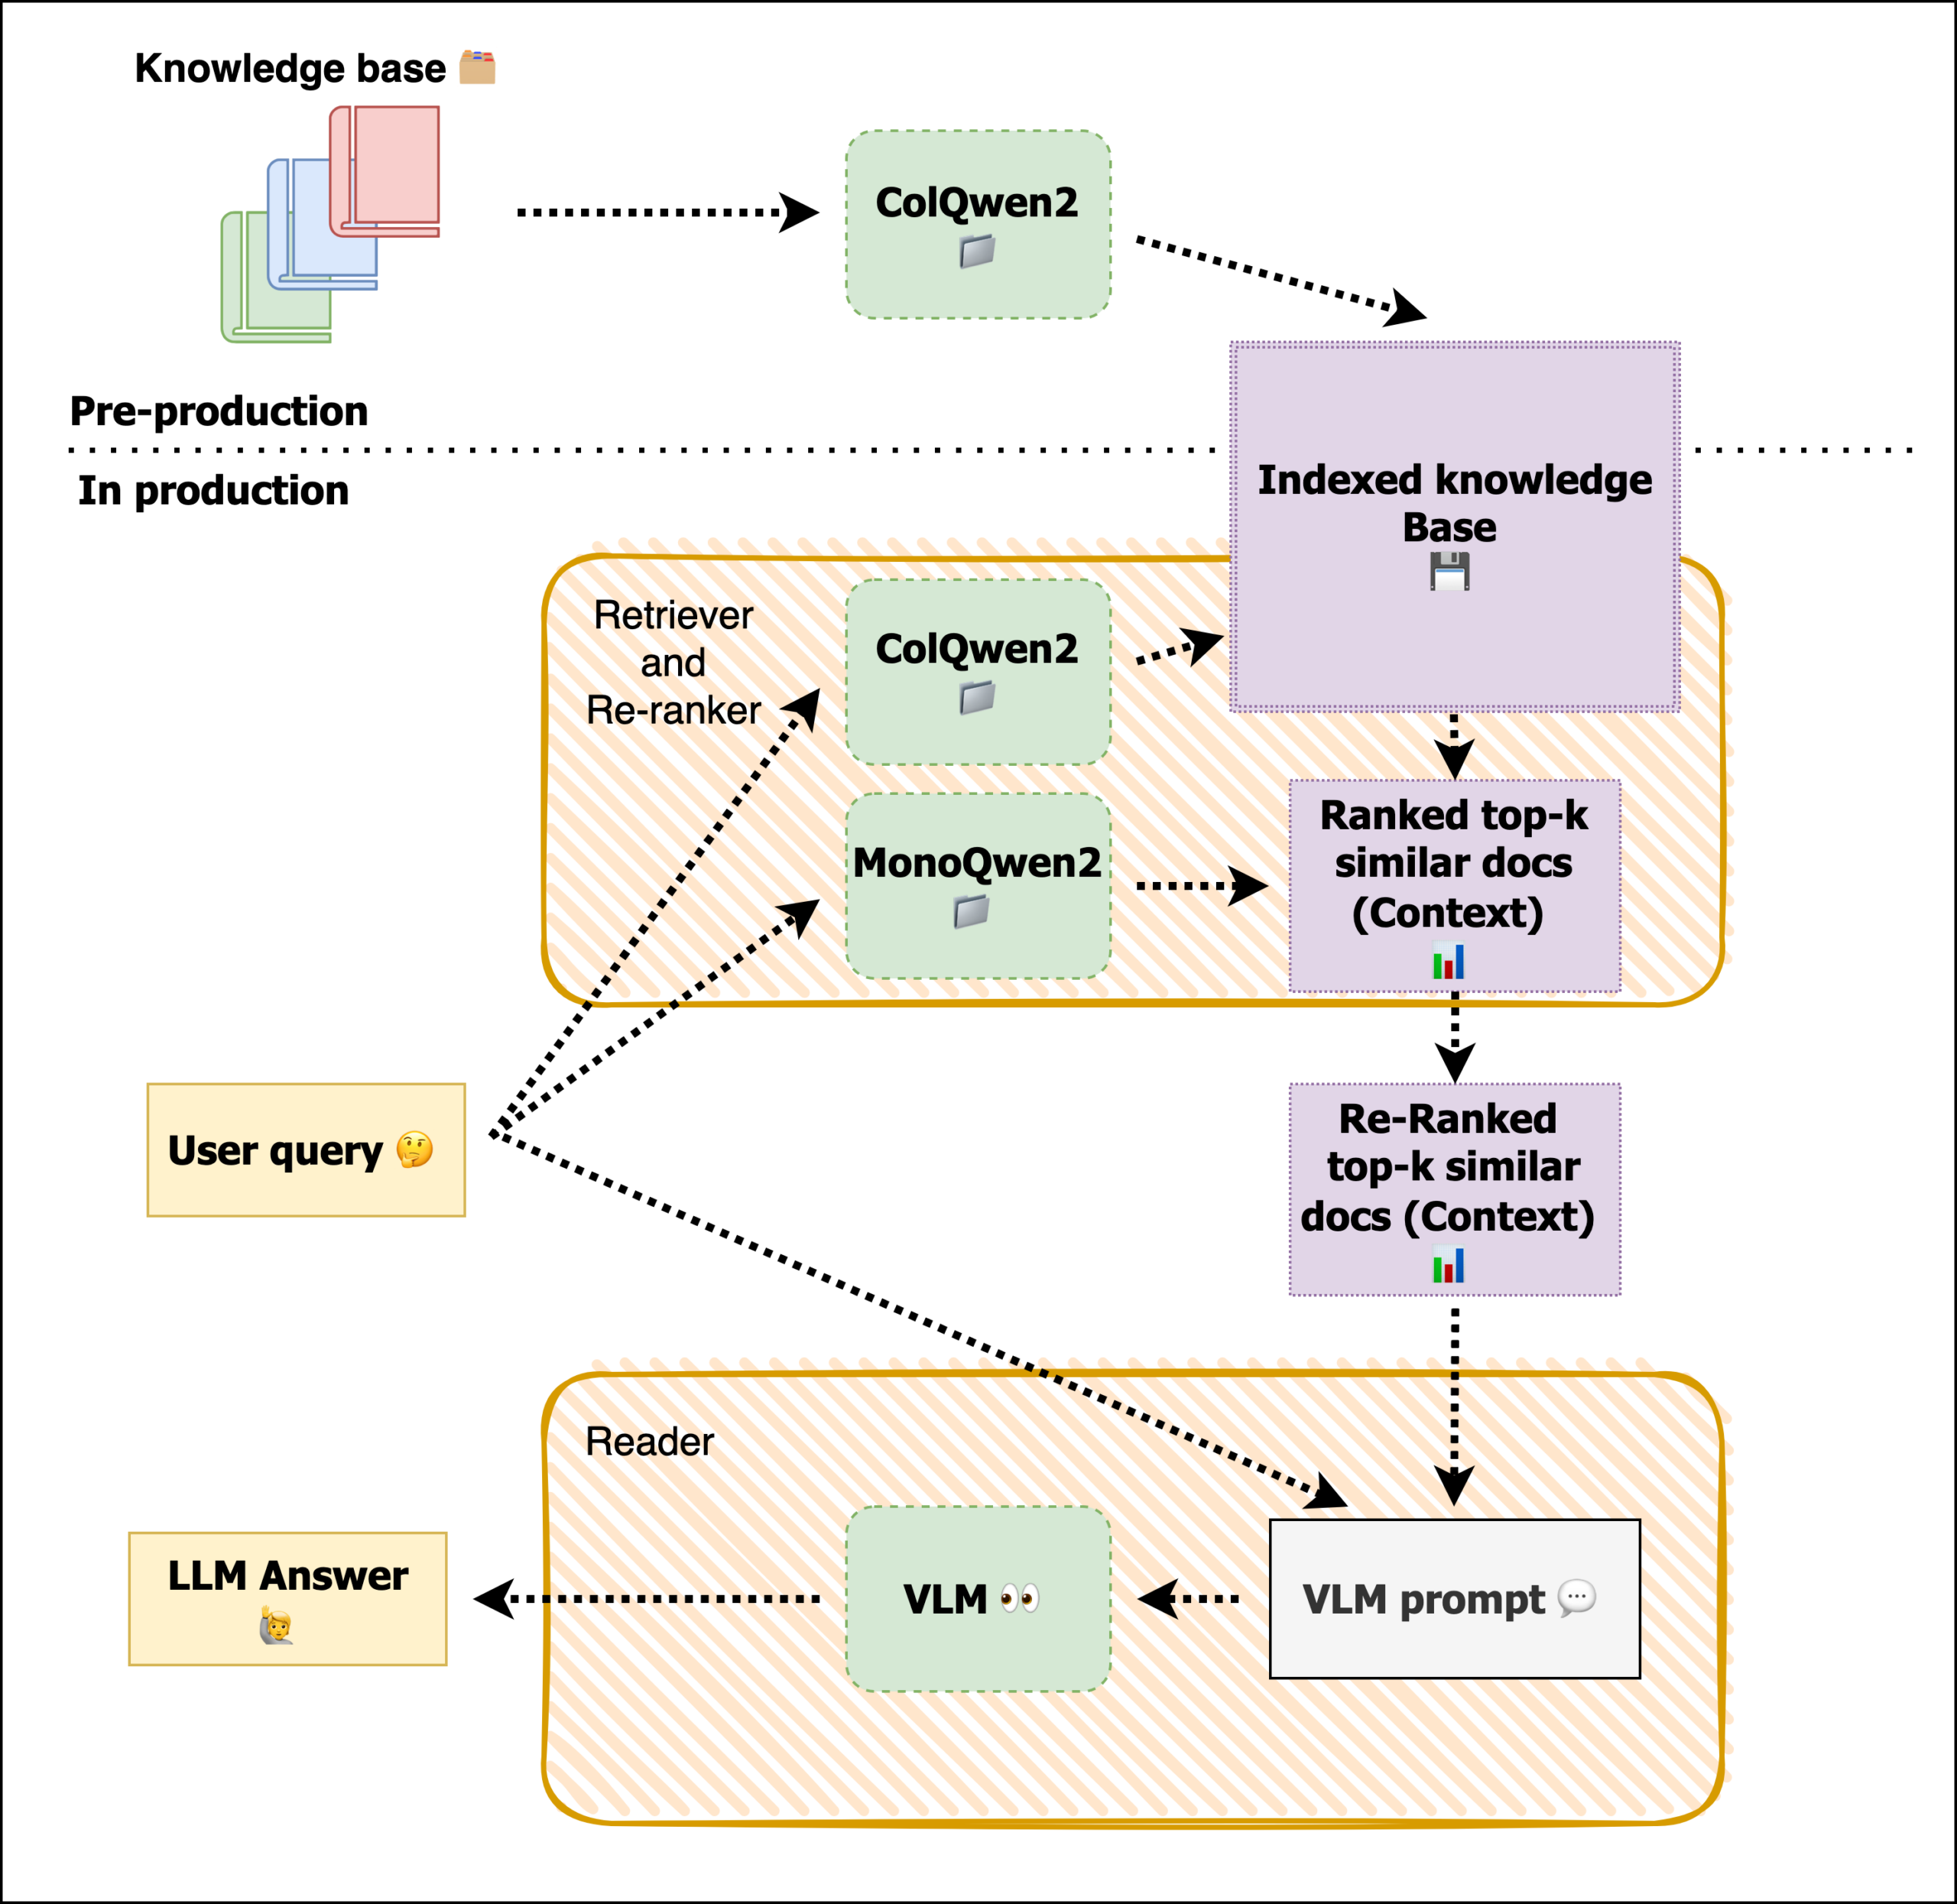
此流程图受到 Aymeric Roucher 在 高级 RAG 和 RAG 评估 配方中相关工作的启发。
1. 安装依赖
首先安装项目所需的基础库。
!pip install -U -q byaldi pdf2image qwen-vl-utils transformers bitsandbytes peft
# Tested with byaldi==0.0.7, pdf2image==1.17.0, qwen-vl-utils==0.0.8, transformers==4.46.3
!pip install -U -q rerankers[monovlm]2. 加载数据集
本 Notebook 使用 Our World in Data 的图表与地图。该站提供大量可公开访问的数据和可视化资料;这里聚焦于预期寿命数据。
为了便于使用,作者从中整理了一个较小的示例数据集。
这里仅选择几个样本作演示。在真实场景中,可以处理规模大得多的视觉数据集,进一步增强模型能力。
数据引用:
Saloni Dattani, Lucas Rodés-Guirao, Hannah Ritchie, Esteban Ortiz-Ospina and Max Roser (2023) - “Life Expectancy” Published online at OurWorldinData.org. Retrieved from: 'https://ourworldindata.org/life-expectancy' [Online Resource]from datasets import load_dataset
dataset = load_dataset("sergiopaniego/ourworldindata_example", split='train')下载视觉数据后,将其保存到本地,供后续 RAG 系统建立文件索引。这样文档检索模型 ColQwen2 才能高效处理与使用这些视觉内容。此外,把图像缩小到 448×448,以减少内存占用、加快处理;大规模运行时,这一点尤为重要。
import os
from PIL import Image

def save_images_to_local(dataset, output_folder="data/"):
    os.makedirs(output_folder, exist_ok=True)

    for image_id, image_data in enumerate(dataset):
        image = image_data['image']

        if isinstance(image, str):
            image = Image.open(image)

        image = image.resize((448, 448))

        output_path = os.path.join(output_folder, f"image_{image_id}.png")

        image.save(output_path, format='PNG')

        print(f"Image saved in: {output_path}")

save_images_to_local(dataset)
接下来加载图像,探索数据并了解视觉内容。
import os
from PIL import Image

def load_png_images(image_folder):
    png_files = [f for f in os.listdir(image_folder) if f.endswith('.png')]
    all_images = {}

    for image_id, png_file in enumerate(png_files):
        image_path = os.path.join(image_folder, png_file)
        image = Image.open(image_path)
        all_images[image_id] = image

    return all_images

all_images = load_png_images("/content/data/")
显示几个样本,了解数据的结构、格式与布局。
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 5, figsize=(20, 15))

for i, ax in enumerate(axes.flat):
    img = all_images[i]
    ax.imshow(img)
    ax.axis('off')

plt.tight_layout()
plt.show()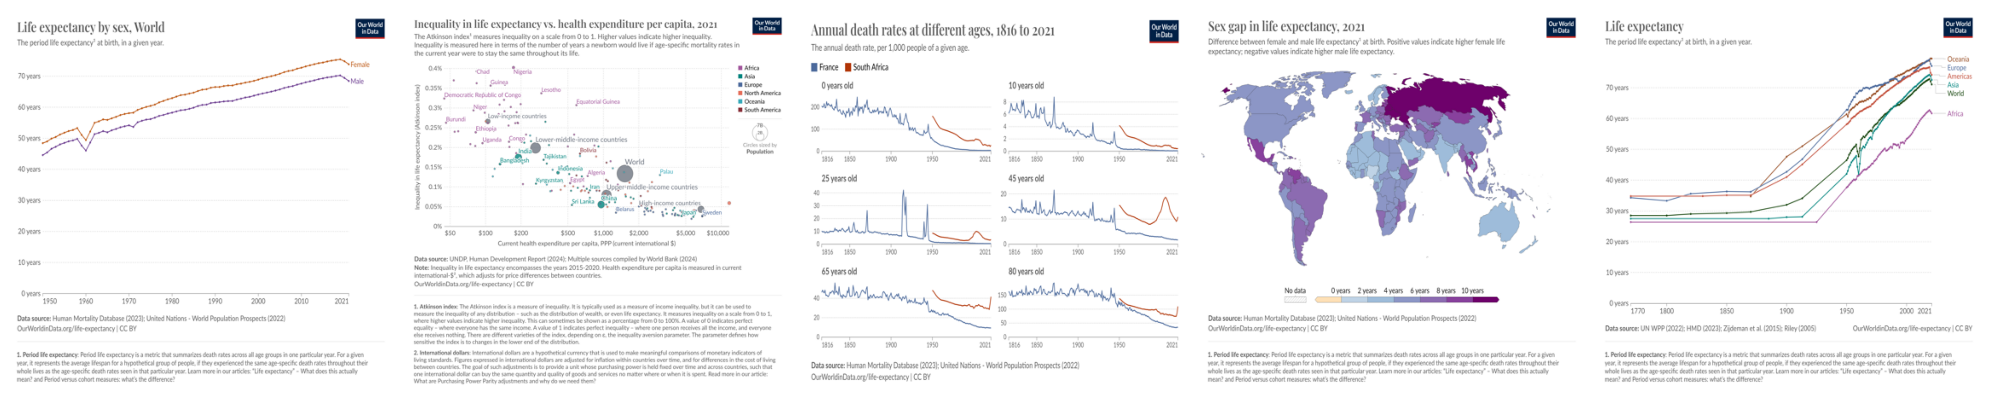
3. 初始化 ColQwen2 多模态文档检索模型
数据准备好后,初始化文档检索模型。它负责从原始图像中提取相关信息,并针对查询返回适当的文档。
借助该模型,可以增强系统的对话能力。
这里使用 Byaldi。开发者将其描述为 RAGatouille 的小型姊妹项目:它对 ColPali 仓库做了简单封装,让用户可以通过熟悉的 API 使用 ColPALI 这类后期交互多模态模型。
本项目具体采用 ColQwen2。
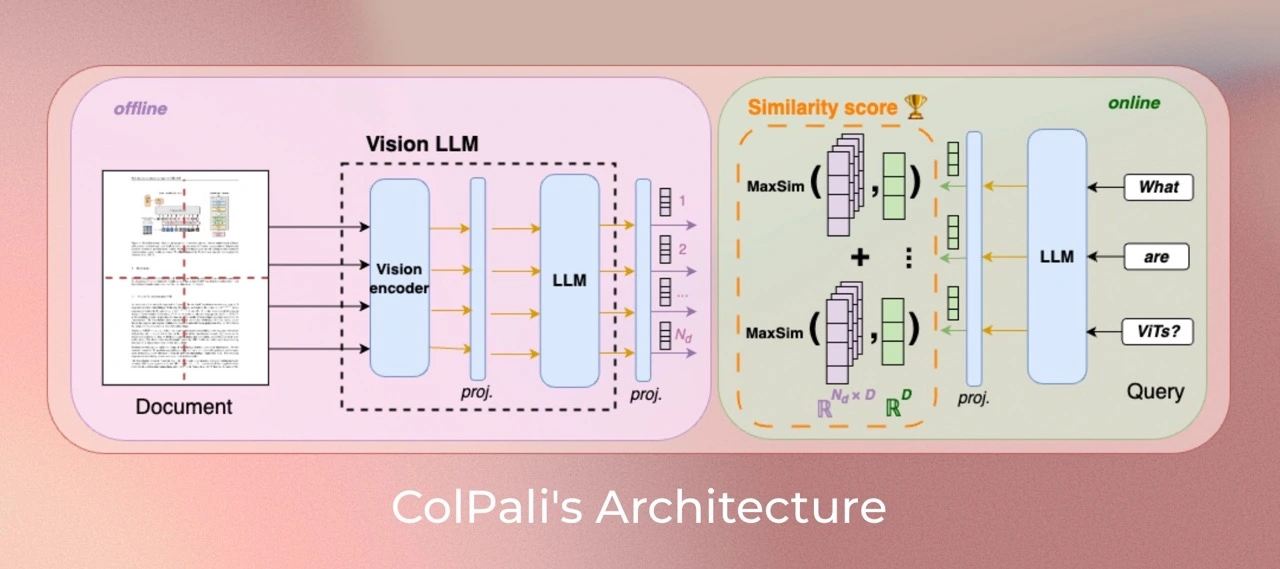
还可以通过 ViDore 视觉文档检索基准,了解表现优秀的检索器。
首先,从检查点加载模型。
from byaldi import RAGMultiModalModel

docs_retrieval_model = RAGMultiModalModel.from_pretrained("vidore/colqwen2-v1.0")
然后指定图像所在的文件夹,直接通过文档检索模型建立索引。这使模型能够处理并组织文档,以便高效响应后续查询。
docs_retrieval_model.index(
    input_path="data/",
    index_name="image_index",
    store_collection_with_index=False,
    overwrite=True
)
4. 检索文档并用重排器重新排序
初始化完成后,提交一个用户问题,查看模型检索出的相关文档。
模型先按与问题的相关程度返回排序结果,然后再用重排器改善检索流程。
先试一次查询:
text_query = 'How does the life expectancy change over time in France and South Africa?'

results = docs_retrieval_model.search(text_query, k=3)
results
原示例输出
[{'doc_id': 2, 'page_num': 1, 'score': 18.625, 'metadata': {}, 'base64': None},
 {'doc_id': 11, 'page_num': 1, 'score': 16.5, 'metadata': {}, 'base64': None},
 {'doc_id': 1, 'page_num': 1, 'score': 16.375, 'metadata': {}, 'base64': None}]
接下来查看模型具体检索了哪些文档图像,了解与查询对应的视觉内容,以及模型如何选择相关信息。
def get_grouped_images(results, all_images):
    grouped_images = []

    for result in results:
        doc_id = result['doc_id']
        page_num = result['page_num']
        grouped_images.append(all_images[doc_id])
    return grouped_images

grouped_images = get_grouped_images(results, all_images)
进一步观察检索到的文档,检查它们包含的信息,并评估其与问题的相关性和内容质量。
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 3, figsize=(15, 10))

for i, ax in enumerate(axes.flat):
    img = grouped_images[i]
    ax.imshow(img)
    ax.axis('off')

plt.tight_layout()
plt.show()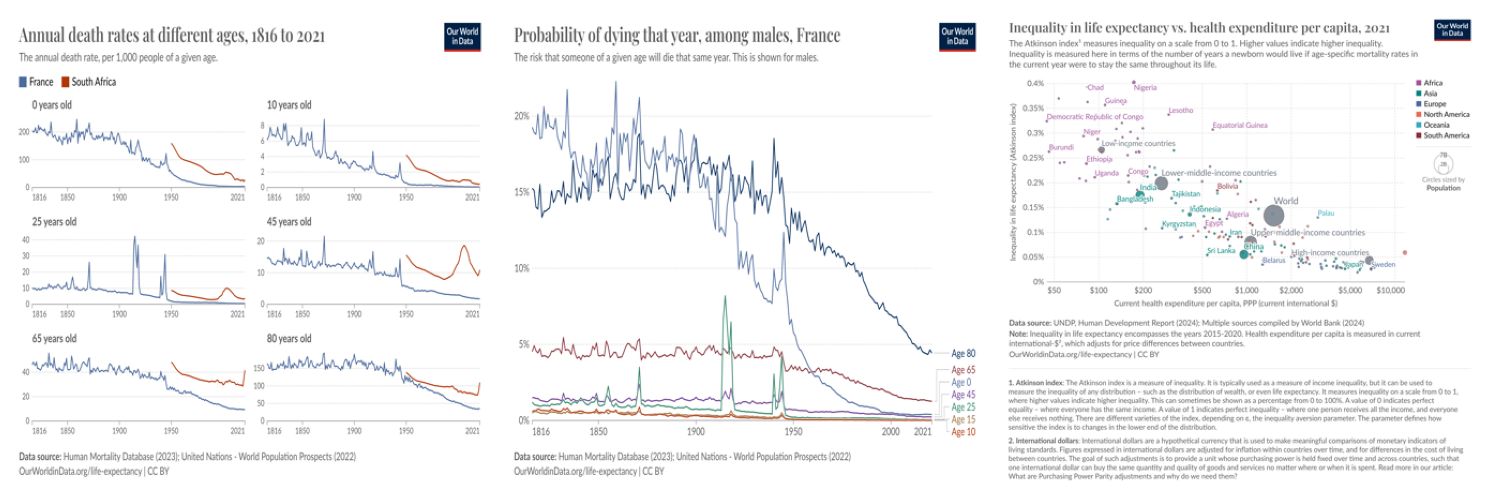
这些检索结果包含与问题有关的数据。
接下来初始化重排模型,使用 rerankers 模块。
from rerankers import Reranker

ranker = Reranker("monovlm", device='cuda')
重排器需要 base64 格式的图像,因此先转换图像,再进行重排。
import base64
from io import BytesIO

def images_to_base64(images):
    base64_images = []
    for img in images:
        buffer = BytesIO()
        img.save(buffer, format="JPEG")
        buffer.seek(0)

        img_base64 = base64.b64encode(buffer.getvalue()).decode("utf-8")
        base64_images.append(img_base64)

    return base64_images

base64_list = images_to_base64(grouped_images)
再次把 text_query 和图像列表交给重排器,让它改善检索上下文。这次不再返回之前的 3 个文档,而只返回 1 个。从原示例结果可以看到,模型给其中一张图像分配了明显更高的分数,从而调整了此前的排序。
results = ranker.rank(text_query, base64_list)def process_ranker_results(results, grouped_images, top_k=3, log=False):
new_grouped_images = []
for i, doc in enumerate(results.top_k(top_k)):
if log:
print(f"Rank {i}:")
print("Document ID:", doc.doc_id)
print("Document Score:", doc.score)
print("Document Base64:", doc.base64[:30] + '...')
print("Document Path:", doc.image_path)
new_grouped_images.append(grouped_images[doc.doc_id])
return new_grouped_images
new_grouped_images = process_ranker_results(results, grouped_images, top_k=1, log=True)原示例输出
Rank 0:
Document ID: 0
Document Score: 0.99609375
Document Base64: /9j/4AAQSkZJRgABAQAAAQABAAD/2w...
Document Path: None
完成后,就可以加载 VLM,生成用户问题的答案。
5. 初始化用于问答的视觉语言模型
这里使用 Qwen2_VL 执行视觉问答。

可以查看开放 VLM 排行榜,了解最新进展。
首先从预训练检查点加载模型,并放到 GPU 上运行。
本 Notebook 使用模型的量化版本,优化内存占用与处理速度。这对消费级 GPU 尤其重要:量化可以降低模型的内存需求,在保持当前任务表现的同时提高效率。
from transformers import Qwen2VLForConditionalGeneration, Qwen2VLProcessor, BitsAndBytesConfig
from qwen_vl_utils import process_vision_info
import torch

# BitsAndBytesConfig int-4 config
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16
)

# Load model and tokenizer
vl_model = Qwen2VLForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2-VL-7B-Instruct",
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config
)
vl_model.eval()
接下来初始化 VLM 的处理器。指定图像的最小和最大像素数量,以控制图像输入对 GPU 内存的占用。像素越多,占用通常越大,因此需要在性能与显存容量之间取得平衡。
有关通过调整图像分辨率改善性能的细节,见对应文档。
min_pixels = 224*224
max_pixels = 448*448
vl_model_processor = Qwen2VLProcessor.from_pretrained(
    "Qwen/Qwen2-VL-7B-Instruct",
    min_pixels=min_pixels,
    max_pixels=max_pixels
)
6. 组合 VLM 并测试系统
所有组件加载后,就可以组合系统。首先构造对话结构,传入检索得到的图像和用户问题。这个步骤具有较强的可定制性,可以根据需要调整交互方式,并尝试不同输入与输出。
chat_template = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": new_grouped_images[0],
            },
            {
                "type": "text",
                "text": text_query
            },
        ],
    }
]
应用对话模板,为模型交互准备输入。
text = vl_model_processor.apply_chat_template(
    chat_template, tokenize=False, add_generation_prompt=True
)
然后处理输入,使格式满足 VLM 的要求。这一步使模型能够根据所提供的数据生成答案。
image_inputs, _ = process_vision_info(chat_template)
inputs = vl_model_processor(
    text=[text],
    images=image_inputs,
    padding=True,
    return_tensors="pt",
)
inputs = inputs.to("cuda")
现在可以生成答案,观察系统如何利用处理后的输入、用户问题和检索图像作出响应。
generated_ids = vl_model.generate(**inputs, max_new_tokens=500)模型生成输出后,再进行后处理,得到最终答案。
generated_ids_trimmed = [
    out_ids[len(in_ids) :] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = vl_model_processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)print(output_text[0])原示例输出
The life expectancy in France has increased over time, while the life expectancy in South Africa has decreased over time.
7. 组合完整流水线
将整个处理过程封装为一个方法,便于在后续应用中复用。
def answer_with_multimodal_rag(vl_model, docs_retrieval_model, vl_model_processor, grouped_images, text_query, retrival_top_k, reranker_top_k, max_new_tokens):
    results = docs_retrieval_model.search(text_query, k=retrival_top_k)
    grouped_images = get_grouped_images(results, all_images)

    base64_list = images_to_base64(grouped_images)
    results = ranker.rank(text_query, base64_list)
    grouped_images = process_ranker_results(results, grouped_images, top_k=reranker_top_k)

    chat_template = [
    {
      "role": "user",
      "content": [
          {"type": "image", "image": image} for image in grouped_images
            ] + [
          {"type": "text", "text": text_query}
        ],
      }
    ]

    # Prepare the inputs
    text = vl_model_processor.apply_chat_template(chat_template, tokenize=False, add_generation_prompt=True)
    image_inputs, video_inputs = process_vision_info(chat_template)
    inputs = vl_model_processor(
        text=[text],
        images=image_inputs,
        padding=True,
        return_tensors="pt",
    )
    inputs = inputs.to("cuda")

    # Generate text from the vl_model
    generated_ids = vl_model.generate(**inputs, max_new_tokens=max_new_tokens)
    generated_ids_trimmed = [
        out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
    ]

    # Decode the generated text
    output_text = vl_model_processor.batch_decode(
        generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
    )

    return output_text
下面运行完整 RAG 流水线的调用示例。
output_text = answer_with_multimodal_rag(
    vl_model=vl_model,
    docs_retrieval_model=docs_retrieval_model,
    vl_model_processor=vl_model_processor,
    grouped_images=grouped_images,
    text_query='What is the overall trend in life expectancy across different countries and regions?',
    retrival_top_k=3,
    reranker_top_k=1,
    max_new_tokens=500
)
print(output_text[0])
原示例输出
The overall trend in life expectancy across different countries and regions is an increase over time.
import torch
torch.cuda.empty_cache()
torch.cuda.synchronize()
print(f"GPU allocated memory: {torch.cuda.memory_allocated() / 1024**3:.2f} GB")
print(f"GPU reserved memory: {torch.cuda.memory_reserved() / 1024**3:.2f} GB")
原示例输出
GPU allocated memory: 13.93 GB
GPU reserved memory: 14.59 GB
至此,原示例已组合出一条 RAG 流水线:它整合文档检索模型与视觉语言模型,并针对单张消费级 GPU 进行了优化,可根据用户问题及相关文档生成响应。
其中的重排步骤进一步细化文档检索过程,旨在提高结果相关性,改善系统整体表现。
8. 继续探索
如需进一步学习,可以阅读上一篇 使用文档检索(ColPali)与视觉语言模型构建多模态 RAG 的结论、结果和经验,加深对多模态 RAG 系统的理解。











暂无评论内容