


%matplotlib inline

import numpy as np

import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.tools.sm_exceptions import ConvergenceWarning
本示例中的 R 代码与结果已经转换为静态文本,因此构建这份文档不要求安装 R。原文的 R 对照结果使用 R 3.5.1 和 lme4 1.1 计算。以下输出与警告均来自官方示例,不是本文在本机运行所得。
%load_ext rpy2.ipython%R library(lme4)array(['lme4', 'Matrix', 'tools', 'stats', 'graphics', 'grDevices',
'utils', 'datasets', 'methods', 'base'], dtype='<U9')比较 R 的 lmer 与 statsmodels 的 MixedLM
statsmodels 的线性混合模型实现 MixedLM,遵循 Lindstrom 与 Bates 在 1988 年 JASA 论文中介绍的方法,R 的 LME4 包也采用这一路径。该领域的基础技术已经比较成熟,Stata、SAS 等软件中的相关模型也应与这种思路一致。
下面展示如何使用 statsmodels 的 MixedLM 拟合线性混合模型,并列出 R 的 LME4 结果作为对照。首先导入需要的模块。
猪的生长曲线
这是一个析因实验中的纵向数据集。响应变量是每头猪的体重,此处只使用时间作为预测变量。先拟合一个平均体重随时间线性变化、每头猪具有随机截距的模型。
模型采用公式接口;没有显式指定随机效应结构,因此默认使用每组一个随机截距。
data = sm.datasets.get_rdataset("dietox", "geepack").data
md = smf.mixedlm("Weight ~ Time", data, groups=data["Pig"])
mdf = md.fit(method=["lbfgs"])
print(mdf.summary())
Mixed Linear Model Regression Results
========================================================
Model: MixedLM Dependent Variable: Weight
No. Observations: 861 Method: REML
No. Groups: 72 Scale: 11.3669
Min. group size: 11 Log-Likelihood: -2404.7753
Max. group size: 12 Converged: Yes
Mean group size: 12.0
--------------------------------------------------------
Coef. Std.Err. z P>|z| [0.025 0.975]
--------------------------------------------------------
Intercept 15.724 0.788 19.952 0.000 14.179 17.268
Time 6.943 0.033 207.939 0.000 6.877 7.008
Group Var 40.395 2.149
========================================================
同一模型在 R 中使用 lmer 拟合:
%%R
data(dietox, package='geepack')
%R print(summary(lmer('Weight ~ Time + (1|Pig)', data=dietox)))Linear mixed model fit by REML ['lmerMod']
Formula: Weight ~ Time + (1 | Pig)
Data: dietox
REML criterion at convergence: 4809.6
Scaled residuals:
Min 1Q Median 3Q Max
-4.7118 -0.5696 -0.0943 0.4877 4.7732
Random effects:
Groups Name Variance Std.Dev.
Pig (Intercept) 40.39 6.356
Residual 11.37 3.371
Number of obs: 861, groups: Pig, 72
Fixed effects:
Estimate Std. Error t value
(Intercept) 15.72352 0.78805 19.95
Time 6.94251 0.03339 207.94
Correlation of Fixed Effects:
(Intr)
Time -0.275statsmodels 的摘要把固定效应和随机效应参数估计放在同一张表中,而 LME4 把猪的随机截距放在随机效应部分。原文解释称此项为“Intercept RE”,但上面当前生成的表格实际标示为 Group Var,应以表格字段为准。
随机效应方差与协方差的标准误是否有用,长期存在争论。LME4 不显示这些标准误,因为该包的作者认为它们未必提供有用信息。statsmodels 的作者理解这种疑虑,但仍在摘要中包含标准误,同时不显示对应的 Wald 置信区间。
接着为每头猪拟合两个随机效应:随机截距和关于时间的随机斜率。这样,每头猪可以有不同的初始体重和生长速度。公式指定 Time 的系数为随机系数。公式默认包含截距,若需去掉截距可使用 0 + Time。
md = smf.mixedlm("Weight ~ Time", data, groups=data["Pig"], re_formula="~Time")
mdf = md.fit(method=["lbfgs"])
print(mdf.summary())
Mixed Linear Model Regression Results
===========================================================
Model: MixedLM Dependent Variable: Weight
No. Observations: 861 Method: REML
No. Groups: 72 Scale: 6.0372
Min. group size: 11 Log-Likelihood: -2217.0475
Max. group size: 12 Converged: Yes
Mean group size: 12.0
-----------------------------------------------------------
Coef. Std.Err. z P>|z| [0.025 0.975]
-----------------------------------------------------------
Intercept 15.739 0.550 28.603 0.000 14.660 16.817
Time 6.939 0.080 86.925 0.000 6.783 7.095
Group Var 19.503 1.561
Group x Time Cov 0.294 0.153
Time Var 0.416 0.033
===========================================================
同一随机截距与随机斜率模型的 R 对照:
%R print(summary(lmer("Weight ~ Time + (1 + Time | Pig)", data=dietox)))Linear mixed model fit by REML ['lmerMod']
Formula: Weight ~ Time + (1 + Time | Pig)
Data: dietox
REML criterion at convergence: 4434.1
Scaled residuals:
Min 1Q Median 3Q Max
-6.4286 -0.5529 -0.0416 0.4841 3.5624
Random effects:
Groups Name Variance Std.Dev. Corr
Pig (Intercept) 19.493 4.415
Time 0.416 0.645 0.10
Residual 6.038 2.457
Number of obs: 861, groups: Pig, 72
Fixed effects:
Estimate Std. Error t value
(Intercept) 15.73865 0.55012 28.61
Time 6.93901 0.07982 86.93
Correlation of Fixed Effects:
(Intr)
Time 0.006 随机截距与随机斜率的相关性较弱。原文给出的计算为 0.294 / √(19.493 × 0.416) ≈ 0.1。这里 19.493 来自 R 的显示结果;上面的 Python 表格显示 19.503,属于这份对照中的估计差异。接着约束两个随机效应彼此不相关。
0.294 / (19.493 * 0.416) ** 0.50.10324316832591753md = smf.mixedlm("Weight ~ Time", data, groups=data["Pig"], re_formula="~Time")
free = sm.regression.mixed_linear_model.MixedLMParams.from_components(
np.ones(2), np.eye(2)
)
mdf = md.fit(free=free, method=["lbfgs"])
print(mdf.summary()) Mixed Linear Model Regression Results
===========================================================
Model: MixedLM Dependent Variable: Weight
No. Observations: 861 Method: REML
No. Groups: 72 Scale: 6.0283
Min. group size: 11 Log-Likelihood: -2217.3481
Max. group size: 12 Converged: Yes
Mean group size: 12.0
-----------------------------------------------------------
Coef. Std.Err. z P>|z| [0.025 0.975]
-----------------------------------------------------------
Intercept 15.739 0.554 28.388 0.000 14.652 16.825
Time 6.939 0.080 86.248 0.000 6.781 7.097
Group Var 19.837 1.571
Group x Time Cov 0.000 0.000
Time Var 0.423 0.033
===========================================================
把相关参数固定为 0 后,原文的对数似然约下降 0.3。将两倍差值约 0.6 与自由度为 1 的 χ² 参考分布比较,原文认为数据与相关参数等于 0 的模型相容。这个例子不是证明参数必定为 0,也不能把同样的普通 χ² 近似无条件套用于边界上的方差参数。
下面是相同约束在 R 中的对照。R 报告的是 REML criterion,此处为 −2 倍受限对数似然;原文“twice the log likelihood”的说明漏掉负号,已在这里校正。
%R print(summary(lmer("Weight ~ Time + (1 | Pig) + (0 + Time | Pig)", data=dietox)))Linear mixed model fit by REML ['lmerMod']
Formula: Weight ~ Time + (1 | Pig) + (0 + Time | Pig)
Data: dietox
REML criterion at convergence: 4434.7
Scaled residuals:
Min 1Q Median 3Q Max
-6.4281 -0.5527 -0.0405 0.4840 3.5661
Random effects:
Groups Name Variance Std.Dev.
Pig (Intercept) 19.8404 4.4543
Pig.1 Time 0.4234 0.6507
Residual 6.0282 2.4552
Number of obs: 861, groups: Pig, 72
Fixed effects:
Estimate Std. Error t value
(Intercept) 15.73875 0.55444 28.39
Time 6.93899 0.08045 86.25
Correlation of Fixed Effects:
(Intr)
Time -0.086Sitka 云杉生长数据
这是 R 中用于混合模型演示的数据集之一。响应变量是树的大小,预测变量是时间,并按每棵树分组。
data = sm.datasets.get_rdataset("Sitka", "MASS").data
endog = data["size"]
data["Intercept"] = 1
exog = data[["Intercept", "Time"]]
先用 statsmodels 的 MixedLM 拟合随机截距模型。这里直接传入响应数组 endog 与固定效应设计矩阵 exog,并用 exog_re 显式指定随机截距;即使省略它,随机截距也是默认结构。原文说明文字将参数称为 endog_re,实际代码和 API 是 exog_re,此处按代码校正。
md = sm.MixedLM(endog, exog, groups=data["tree"], exog_re=exog["Intercept"])
mdf = md.fit()
print(mdf.summary())
Mixed Linear Model Regression Results
=======================================================
Model: MixedLM Dependent Variable: size
No. Observations: 395 Method: REML
No. Groups: 79 Scale: 0.0392
Min. group size: 5 Log-Likelihood: -82.3884
Max. group size: 5 Converged: Yes
Mean group size: 5.0
-------------------------------------------------------
Coef. Std.Err. z P>|z| [0.025 0.975]
-------------------------------------------------------
Intercept 2.273 0.088 25.864 0.000 2.101 2.446
Time 0.013 0.000 47.796 0.000 0.012 0.013
Intercept Var 0.374 0.345
=======================================================
同一模型的 R 对照:
%R
data(Sitka, package="MASS")
print(summary(lmer("size ~ Time + (1 | tree)", data=Sitka)))
Linear mixed model fit by REML ['lmerMod']
Formula: size ~ Time + (1 | tree)
Data: Sitka
REML criterion at convergence: 164.8
Scaled residuals:
Min 1Q Median 3Q Max
-2.9979 -0.5169 0.1576 0.5392 4.4012
Random effects:
Groups Name Variance Std.Dev.
tree (Intercept) 0.37451 0.612
Residual 0.03921 0.198
Number of obs: 395, groups: tree, 79
Fixed effects:
Estimate Std. Error t value
(Intercept) 2.2732443 0.0878955 25.86
Time 0.0126855 0.0002654 47.80
Correlation of Fixed Effects:
(Intr)
Time -0.611现在尝试加入随机斜率,先查看 R 的代码与输出。随机斜率方差的 REML 估计接近 0。输出还包含梯度和模型可识别性的警告,即使显示 convergence code 0,也不能忽略这些诊断。
%R print(summary(lmer("size ~ Time + (1 + Time | tree)", data=Sitka)))Linear mixed model fit by REML ['lmerMod']
Formula: size ~ Time + (1 + Time | tree)
Data: Sitka
REML criterion at convergence: 153.4
Scaled residuals:
Min 1Q Median 3Q Max
-2.7609 -0.5173 0.1188 0.5270 3.5466
Random effects:
Groups Name Variance Std.Dev. Corr
tree (Intercept) 2.217e-01 0.470842
Time 3.288e-06 0.001813 -0.17
Residual 3.634e-02 0.190642
Number of obs: 395, groups: tree, 79
Fixed effects:
Estimate Std. Error t value
(Intercept) 2.273244 0.074655 30.45
Time 0.012686 0.000327 38.80
Correlation of Fixed Effects:
(Intr)
Time -0.615
convergence code: 0
Model failed to converge with max|grad| = 0.793203 (tol = 0.002, component 1)
Model is nearly unidentifiable: very large eigenvalue
- Rescale variables?用 statsmodels 的默认拟合方式运行这个随机斜率模型,原文也得到很小的方差估计,并出现“极大似然估计可能位于参数空间边界”的警告。回归斜率与 R 比较接近,但原文报告的似然值明显不同。不能仅因摘要中的 Converged: Yes 就断言所有数值问题都已消失。
exog_re = exog.copy()
md = sm.MixedLM(endog, exog, data["tree"], exog_re)
mdf = md.fit()
print(mdf.summary())
Mixed Linear Model Regression Results
===============================================================
Model: MixedLM Dependent Variable: size
No. Observations: 395 Method: REML
No. Groups: 79 Scale: 0.0264
Min. group size: 5 Log-Likelihood: -62.4834
Max. group size: 5 Converged: Yes
Mean group size: 5.0
---------------------------------------------------------------
Coef. Std.Err. z P>|z| [0.025 0.975]
---------------------------------------------------------------
Intercept 2.273 0.101 22.513 0.000 2.075 2.471
Time 0.013 0.000 33.888 0.000 0.012 0.013
Intercept Var 0.646 0.914
Intercept x Time Cov -0.001 0.003
Time Var 0.000 0.000
===============================================================
/tmp/ipykernel_5227/4173103950.py:3: ConvergenceWarning: The MLE may be on the boundary of the parameter space.
  mdf = md.fit()
还可以绘制轮廓似然进一步查看随机效应结构。先针对随机截距方差,在其估计值上下各 0.1 的区间构造轮廓。随机斜率方差接近 0,使区间内各次优化都会产生警告,因此原文在这个局部绘图代码中暂时关闭警告。
这种屏蔽只为方便展示,不表示警告可以在分析报告或模型诊断中忽略。
import warnings

with warnings.catch_warnings():
    warnings.filterwarnings("ignore")
    likev = mdf.profile_re(0, "re", dist_low=0.1, dist_high=0.1)
原文随后绘制轮廓似然曲线,并说明可把对数似然差值乘以 2,与自由度为 1 的 χ² 分布作参考比较。下面代码保留原样;但它实际绘制的是 2 * likev[:, 1],未显式扣除最大值,纵轴文字却写着“−2 times profile log likelihood”。因此不能未经核对就把图上的纵轴值当作已归一化的似然比统计量。
import matplotlib.pyplot as pltplt.figure(figsize=(10, 8))
plt.plot(likev[:, 0], 2 * likev[:, 1])
plt.xlabel("Variance of random intercept", size=17)
plt.ylabel("-2 times profile log likelihood", size=17)Text(0, 0.5, '-2 times profile log likelihood')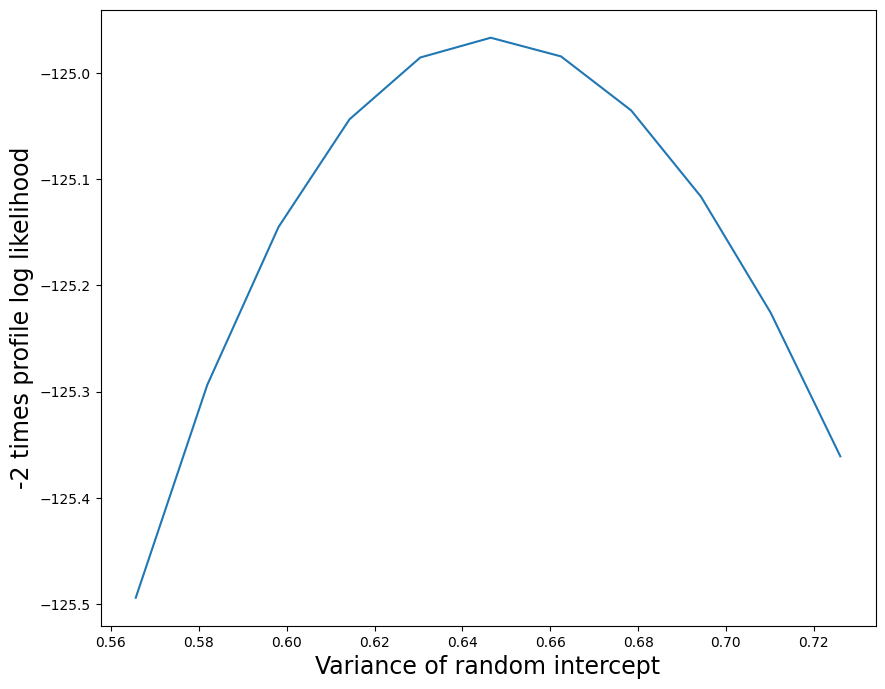
最后查看随机斜率方差的轮廓似然图。原文根据这个示例把方差估计描述为一个很小的正数、估计不确定性较低。这个判断应连同边界警告和先前的可识别性问题阅读,不能推广为任意数据上的可靠性保证。
re = mdf.cov_re.iloc[1, 1]
with warnings.catch_warnings():
    # Parameter is often on the boundary
    warnings.simplefilter("ignore", ConvergenceWarning)
    likev = mdf.profile_re(1, "re", dist_low=0.5 * re, dist_high=0.8 * re)

plt.figure(figsize=(10, 8))
plt.plot(likev[:, 0], 2 * likev[:, 1])
plt.xlabel("Variance of random slope", size=17)
lbl = plt.ylabel("-2 times profile log likelihood", size=17)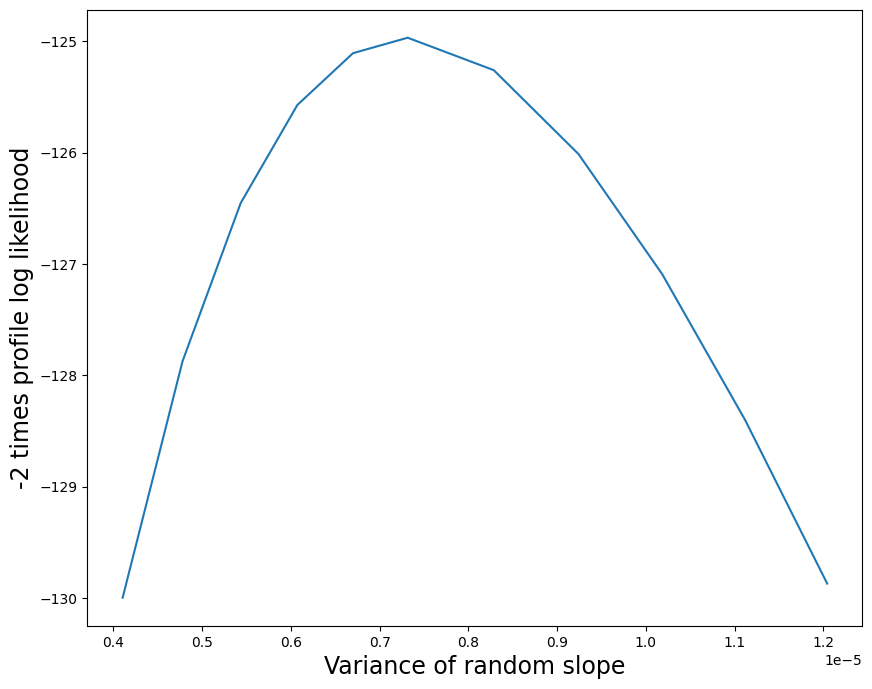
复现条件:%matplotlib inline、%R 与 %%R 是 IPython/Jupyter 语法,不能原样放进普通 Python 脚本。Python 主流程不依赖 R;如果自行重跑历史 R 对照,需要另行配置 R、rpy2 和相应 R 包。get_rdataset 还可能访问远程数据源。比较不同固定效应结构时,需明确使用 ML 还是 REML;边界方差的推断需专门处理。本文仅做静态核验,没有下载数据、拟合模型或重新生成图。
来源:statsmodels 文档与示例贡献者,Linear Mixed Effects Models,当前页面标示 statsmodels 0.15.0;官方 Notebook 源。文档页版权标示 © 2009–2025 Josef Perktold, Skipper Seabold, Jonathan Taylor, statsmodels-developers。内容按 statsmodels BSD 许可复用。本稿为中文翻译与排版,校正表格字段、REML criterion 符号及参数名称,并补充边界推断、绘图标签与复现环境的说明;代码和官方输出保留原样。
BSD 版权、条件与免责条款
Copyright (C) 2006, Jonathan E. Taylor
All rights reserved.Copyright (c) 2006-2008 Scipy Developers.
All rights reserved.Copyright (c) 2009-2018 statsmodels Developers.
All rights reserved.Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:
a. Redistributions of source code must retain the above copyright notice,
this list of conditions and the following disclaimer.
b. Redistributions in binary form must reproduce the above copyright
notice, this list of conditions and the following disclaimer in the
documentation and/or other materials provided with the distribution.
c. Neither the name of statsmodels nor the names of its contributors
may be used to endorse or promote products derived from this software
without specific prior written permission.THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS “AS IS”
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE
ARE DISCLAIMED. IN NO EVENT SHALL STATSMODELS OR CONTRIBUTORS BE LIABLE FOR
ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT
LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY
OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH
DAMAGE.











暂无评论内容