


用正则表达式提取字段并用正反例检查匹配
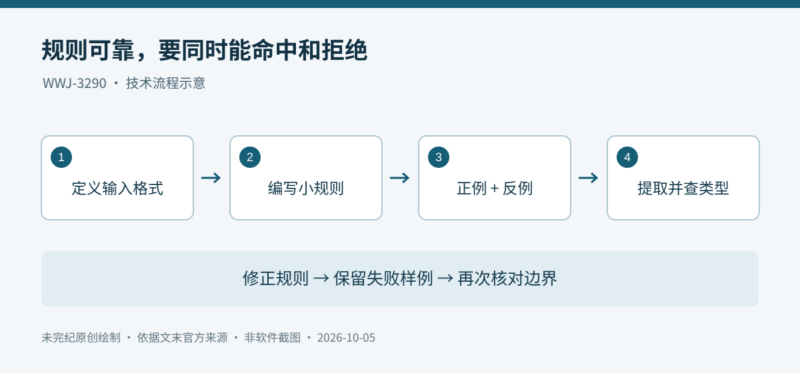
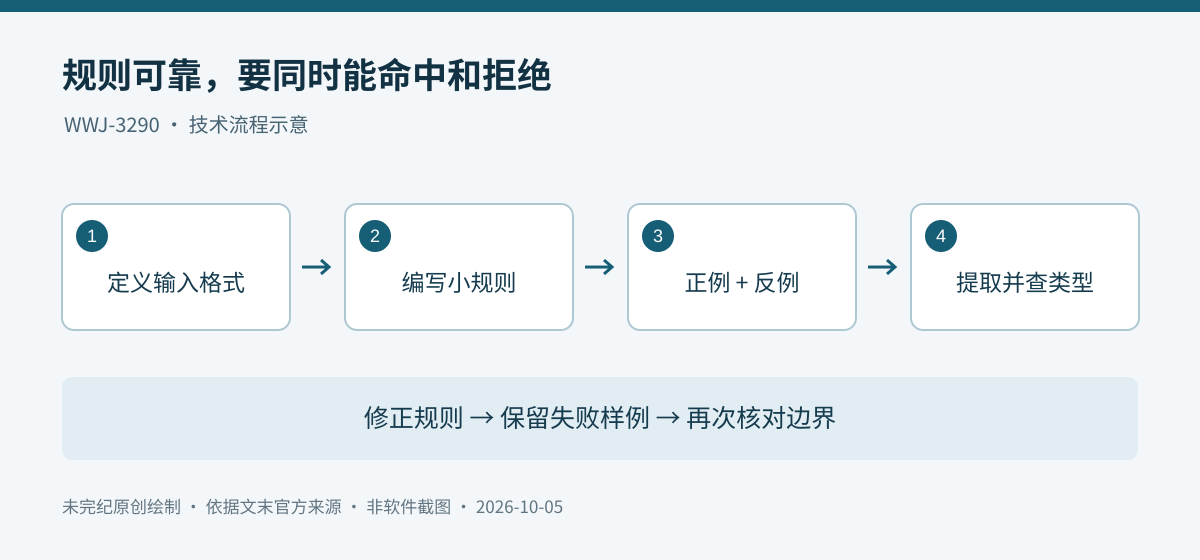
正则表达式可以把“某种格式的文字”写成一条规则,但规则能找到几个成功样例,并不代表它已经正确。更稳妥的做法是把任务拆成三件事:定义什么应该匹配,列出哪些相似输入必须拒绝,最后再把匹配结果转换为需要的字段。
本文依据 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund 所著 《R for Data Science》第二版第 15 章编译。全章及原始 QMD 已完整阅读;按本篇选题范围,使用小字符串和 stringr 自带词句,不展开 babynames 外部数据的姓名趋势分析。原文方法、编者新增样例与勘误在下文分别说明。所有代码只经静态审查,文中预期值不是本次执行记录。
先选函数,再写模式
本篇使用 stringr 处理字符向量,用 tidyr 从数据框的一列拆出多个字段。原章通过 tidyverse 加载这些包,并使用 stringr 自带的 fruit、words、sentences:它们分别包含 80 个水果名称、980 个常见英文词和 720 个短句。可以先准备:
library(stringr)
library(tidyr)
如果还要使用原书的 filter()、mutate()、summarize() 等数据框操作,可加载 dplyr 或 tidyverse。本文不附包安装命令,也没有在本机执行加载。separate_wider_regex()、str_escape() 等函数需要安装版本确实提供相应 API;不要假定多年未更新的环境与滚动文档一致。
| 目的 | 函数 | 返回的主要信息 |
|---|---|---|
| 看哪里匹配 | str_view() |
展示命中的文本位置,便于人工检查。 |
| 判断是否匹配 | str_detect() |
与输入等长的逻辑向量。 |
| 保留匹配字符串 | str_subset() |
只含匹配元素的字符向量。 |
| 返回匹配元素位置 | str_which() |
输入向量中的索引。 |
| 统计每个字符串的匹配数 | str_count() |
每个元素对应一个计数。 |
| 替换或删除匹配 | str_replace()、str_replace_all();str_remove()、str_remove_all() |
修改后的字符向量。 |
| 提取整体或捕获组 | str_extract()、str_match() |
匹配文本,或包含整体与各组的矩阵。 |
| 拆成数据框字段 | separate_wider_regex() |
带命名列的数据框。 |
str_detect() 的结果适合交给 filter,也可以用 sum 统计命中元素数,用 mean 计算命中比例。这里的统计单位是输入向量的元素,不是某个字段背后代表的人数或权重;原书在姓名例子里特别区分了“姓名比例”和“婴儿人数比例”。若输入含 NA,还要明确缺失值如何处理,不能无声地把未知当作不匹配。
从字面字符到模式
最简单的规则就是字面文字。str_view(fruit, "berry") 会显示含 berry 的水果名。正则默认可以匹配字符串中间的一部分,所以含 pineapple 的字符串也能被 apple 命中。
句点 . 是元字符,默认匹配除换行外的一个字符。因此 "a." 要求 a 后面再跟一个字符,单独的 a 不满足,ab、ae 和 eab 里的 ab 可以满足。"a...e" 则要求 a 和 e 之间有三个字符。
数量由量词控制:? 表示零次或一次,+ 表示一次或多次,* 表示零次或多次。例如:
str_view(c("a", "ab", "abb"), "ab?")
str_view(c("a", "ab", "abb"), "ab+")
str_view(c("a", "ab", "abb"), "ab*")
第一条可匹配 a 或 ab,但不会因此把 abb 的两个 b 都吃掉;第二条必须至少有一个 b;第三条即使没有 b 也能匹配。量词作用于紧邻的前一个单元,因此 ab+ 是 a 后面重复 b,不是重复 ab。若要重复整个 ab,应写 (ab)+。
字符类 [abcd] 每次匹配其中一个字符;[^abcd] 每次匹配一个不在集合中的字符。原书用 [aeiou]x[aeiou] 查找两边是元音的 x,用 [^aeiou]y[^aeiou] 展示另一种组合。竖线 | 表示备选,例如 apple|melon|nut。
编者说明:[^aeiou] 的严格含义是“不是这五个小写字母的字符”,并不天然等于“辅音”。数字、空格、标点、大写元音和其他语言字符都可能满足。只有输入已经限定为适当的英文字母集合时,才能把它近似解释为辅音条件。
计数、替换与删除的边界
x <- c("apple", "banana", "pear")
str_count(x, "p")
str_count("abababa", "aba")

str_replace_all(x, "[aeiou]", "-")
str_remove_all(x, "[aeiou]")
按规则静态推导,第一条计数应为 2、0、1;abababa 中的 aba 采用通常的非重叠匹配方式计数,应为 2,而不是把相互覆盖的位置都算进去。str_replace() 只替换每个元素中的第一个匹配,str_replace_all() 替换全部匹配;remove 系列相当于把匹配替换成空字符串。
正则默认区分大小写。统计 Aaban 的 [aeiou] 时,开头大写 A 不会被计入。原书给出三个方向:把大写元音一起放入字符类,使用 regex("[aeiou]", ignore_case = TRUE),或先用 str_to_lower() 转小写。哪种更合适,取决于是否还需要保留原始大小写,以及后面是否有多次相似处理。
数据清洗时,这些函数常与 mutate 配合,一层一层去掉不一致的格式。替换之前保留原字段,核对前后差异,通常比直接覆盖唯一文本列更容易定位误删;这是编者对实际处理流程的补充。
把一列文本拆成有名字的字段
原章用类似 <Sheryl>-F_34 的字符串展示字段提取。名字位于尖括号内,中间是一个字符的标记,最后是年龄数字。以下保留其规则,缩减为三个输入以便阅读:
df <- tibble::tribble(
  ~str,
  "<Sheryl>-F_34",
  "<Brandon>-N_33",
  "<Justin>-M_41"
)

df |>
  separate_wider_regex(
    str,
    patterns = c(
      "<",
      name = "[A-Za-z]+",
      ">-",
      gender = ".",
      "_",
      age = "[0-9]+"
    )
  )
patterns 按顺序拼出整条记录。没有名字的片段负责识别分隔格式,命名为 name、gender、age 的片段进入输出列。这里用 . 只是因为原例把标记设为任意一个字符,并不校验它是否属于某个业务枚举;[A-Za-z]+ 也仅覆盖示例中的英文字母名字,不能当作世界各地姓名格式。
提取后的 age 仍是字符列,不会因为模式只允许数字就自动变成数值。需要进行数值计算时,应在检查空值、范围和转换失败后显式转换。如果格式不匹配,原书建议使用 too_few = "debug" 查看调试信息;调试输出用于定位异常,不应被当成已经合格的业务记录。
编者新增对照:对这种规则,正例至少包含不同长度的姓名和年龄;反例可以加入缺失右尖括号、年龄含字母、标记缺失、额外尾随字段等。若业务只接受 F、M、N,才把 gender = "." 改为 gender = "[FMN]",并把这种收紧明确写进数据约定。正则能验证格式,不能替你确定实际年龄是否合理。
反斜杠经过了两层解释
匹配字面句点需要正则 \.。但 R 普通字符串也把反斜杠当作转义符,所以传入的代码应写 "\\."。先由 R 把字符串解析成 \.,再由正则引擎把它解释为“字面句点”。
str_view(c("abc", "a.c", "bef"), "a\\.c")

x <- "a\\b"
str_view(x, "\\\\")
str_view(x, r"{\\}")
第一条只找字面 a.c。后两条演示如何匹配一个字面反斜杠:普通字符串需要四个反斜杠,R 原始字符串可以省掉字符串这一层的转义,但正则这一层仍然存在。r"{\\}" 中保留两个反斜杠,是因为正则仍需要它们来表示一个字面反斜杠。
字符类有时更直观:[.] 匹配句点,[$] 匹配美元符号,[*] 匹配星号。不过字符类内部仍有自己的特殊字符,不能把所有字符都直接塞进去就认为安全。
锚点决定匹配位置,词边界决定词是否完整
^ 表示开头,$ 表示结尾。^a 找开头为 a 的字符串,a$ 找结尾为 a 的字符串;^apple$ 要求整个字符串符合 apple,而不接受 pineapple。锚点本身是零宽位置,不消耗字符;替换单独的锚点,相当于在相应位置插入内容。
\b 表示词边界,在 R 普通字符串里写为 "\\b"。原书用 "\\bsum\\b" 区分 sum 与 summary、summarize、rowsum。这里的“词”是正则引擎定义的字符类别,不等于自然语言分词;不要据此假定它能正确拆分中文句子。
原书最有启发性的例子是找以 The 开头的句子。"^The" 也会命中 These 和 They 的前缀;加上词边界后变为 "^The\\b",才表达完整单词 The。
编者补充:若处理带换行的输入并要求严格覆盖整个输入,注意 multiline 会改变 ^、$ 的含义,结尾锚点也有引擎细节。stringr 的 ICU 规则提供 \A 与 \z 表示输入的绝对开头、结尾。简单单行示例可以沿用原书写法,严谨字段校验需要把换行与尾随字符加入反例。
字符类、数量与优先级
[a-z] 表示这个范围的小写拉丁字母,[0-9] 表示 ASCII 数字;字符类里的 - 表示范围,反斜杠用于转义。例如 "[a-c]" 是 a、b、c 三个字符,而 "[a\\-c]" 是 a、连字符、c。
| 正则简写 | 含义 | R 普通字符串写法 |
|---|---|---|
\d / \D |
十进制数字 / 非数字 | "\\d" / "\\D" |
\s / \S |
空白 / 非空白 | "\\s" / "\\S" |
\w / \W |
词字符 / 非词字符 | "\\w" / "\\W" |
stringr 的 Unicode 语义比“英文字母加数字”更广:\d 可包括其他文字体系的十进制数字;\w 还包括标记、连接标点等字符,下划线也不能简单忽略。这些细节依据 stringr 官方正则说明补全。需要限定 ASCII 字段时,直接写明允许的字符集合更清楚。
除了 ?、+、*,还可以用 {n} 精确重复 n 次,用 {n,} 至少重复 n 次,用 {n,m} 重复 n 到 m 次。例如 colou?r 接受 color 和 colour,[0-9]{4} 接受四个 ASCII 数字。
量词优先级高,备选 | 优先级低。因此 ^a|b$ 相当于“以 a 开头,或者以 b 结尾”,不是“完整字符串只能是 a 或 b”。后者需要 ^(a|b)$。当多个备选共享前后限制时,先加括号再写锚点,通常更容易检查。
捕获组既可以提取,也可以回引用
括号除了改变优先级,还会建立捕获组。模式中的 \1 引用第一组此前匹配到的内容,\2 引用第二组。下面保留原书示例:
str_view(fruit, "(..)\\1")
str_view(words, "^(..).*\\1$")

str_replace(
  "one two three",
  "(\\w+) (\\w+) (\\w+)",
  "\\1 \\3 \\2"
)
第一个模式寻找相邻重复的两字符片段,例如 banana 中的 anan;第二个寻找首尾两字符相同的词。第三个示例把三个词中的第二、第三个交换,静态预期为 one three two。这里修改了原书传入整组 sentences 的展示方式,换成自写短句,让组号更直观;没有改变替换规则。
str_match() 返回矩阵:第一列是整个匹配,后面各列是捕获组。匹配不到的行会出现 NA。原书展示了先转 tibble 再给列命名的方式,而 separate_wider_regex() 把这类数据框拆列任务封装得更直接。
如果括号仅用于分组,不想增加捕获列,可以写 (?:...)。例如 gr(e|a)y 会捕获 e 或 a,gr(?:e|a)y 只改变备选范围,不增加对应的捕获列。
控制大小写、换行、注释与字面匹配
把字符串包在 regex() 中可以显式控制匹配选项:
str_detect(c("banana", "Banana", "BANANA"),
           regex("banana", ignore_case = TRUE))

x <- "Line 1\nLine 2\nLine 3"
str_view(x, regex(".Line", dotall = TRUE))
str_view(x, regex("^Line", multiline = TRUE))
ignore_case 控制大小写;dotall 允许句点跨越换行;multiline 让开头和结尾锚点面向每一行。后两项处理的是不同问题,不能互相替代。
comments = TRUE 会忽略用于排版的空格、换行以及注释标记后的说明,适合把复杂模式分行。原书以三位区号、三位号码和四位号码组成的电话文本演示它;这里保留原结构:
phone <- regex(
  r"(
    \(?      # 可选的左括号
    (\d{3})  # 三位区号
    [)\-]?   # 可选的右括号或连字符
    \ ?      # 可选的空格
    (\d{3})  # 三位数字
    [\ -]?   # 可选的空格或连字符
    (\d{4})  # 四位数字
  )",
  comments = TRUE
)
str_extract(c("514-791-8141", "(123) 456 7890", "123456"), phone)
需要匹配真正的空格或 # 时,应按该模式的规则转义,避免它们被当成排版或注释。静态审查发现:这段电话模式没有约束整个输入,左右括号也是分别可选的,因此它是格式提取演示,不是严格电话号码验证器;不能用于判定国际号码是否合法,或证明括号一定成对。
若只想寻找字面文字,可用 fixed() 退出正则规则。例如 str_view(c("", "a", "."), fixed(".")) 只找句点。fixed 也支持忽略大小写,但涉及语言地区规则时,原书建议考虑 coll()。例如土耳其语带点与不带点的 I,使用 coll("İ", ignore_case = TRUE, locale = "tr") 与简单字面大小写处理并不等价。
用正例和反例抓住看不见的错误
找句首代词时,下面这条规则看起来很像正确答案:
"^She|He|It|They\\b"实际上开头锚点只约束 She 这一分支,最后的词边界只约束 They。它可能误命中 Help、Her,或句中出现的 It。把所有代词放进同一组,才让共同约束生效:
pos <- c("He is a boy", "She had a good time")
neg <- c("Shells come from the sea",
         "Hadley said 'It's a great day'")

pattern <- "^(She|He|It|They)\\b"
str_detect(pos, pattern)
str_detect(neg, pattern)
这些是原书的正反例。静态预期分别为全 TRUE 和全 FALSE;这句话描述规则含义,不代表本文已经执行。好的反例常常来自以前踩过的坑:同前缀长词、词出现在句中、大小写不同、尾随换行、缺失字段。把它们积累起来,后续调整规则时才有机会发现旧问题再次出现。
编者新增检查写法:如果以后在自己的 R 环境中运行,可以把同样的预期写成断言:
stopifnot(all(str_detect(pos, pattern)))
stopifnot(!any(str_detect(neg, pattern)))
这两行只是待执行的检查方案。本次没有运行;小样本通过也只支持这些输入的行为,不能证明规则在所有数据上正确。含 NA 的测试数据还需要另行定义预期。
不要强迫一个正则完成所有逻辑
想找不含元音的词,除了写 ^[^aeiou]+$,也可以对 str_detect(words, "[aeiou]") 取反。在原书给定的词表范围里,两种思路适合比较;换成任意输入时,空字符串、非字母和大小写会改变它们的含义。
想找同时含 a 和 b 的词,可以写 a.*b|b.*a,也可以把两个简单判断组合起来:
words[str_detect(words, "a") & str_detect(words, "b")]如果要求五个元音都出现,不必枚举 5! 即 120 种顺序。分别检查 a、e、i、o、u,再用逻辑与连接即可。复杂规则卡住时,先拆成几个能解释的小判断,再组合结果,往往比不断添加括号更容易维护。
从词表生成模式时,先处理元字符
原书先用 "\\b(red|green|blue)\\b" 查颜色词,再把颜色放入向量,用 str_flatten 和 str_c 生成模式。还可以从 R 内置 colors() 取颜色名,排除名称带数字的变体,得到更大的备选列表。
rgb <- c("red", "green", "blue")
pattern <- str_c("\\b(", str_flatten(str_escape(rgb), "|"), ")\\b")
str_view(sentences, pattern)
这里相对原来的三种颜色示例,明确加上了 str_escape(),落实原书随后给出的通用建议。原颜色列表只含字母或数字,省略转义通常不影响那个例子;一旦模式词表来自其他数据,句点、括号、加号等就可能改变规则含义。先转义可以让这些输入按字面解释,避免把数据误当正则语法。
词边界也有前提。上例适合这些字母颜色词;若词表中有 C++ 一类以非词字符结尾的条目,即使转义正确,外层 \b 仍可能不适合。生成模式之后仍需用目标数据的正反例检查,不能把“已转义”理解为所有边界都已经正确。
练习要让规则接受什么、拒绝什么都清楚
原章的习题可以沿着本篇任务继续练:用 words 找以 y 开头、不以 y 开头、以 x 结尾、恰好三个字符或至少七个字符的词;识别元音与辅音的组合;用可选片段兼容 color/colour、gray/grey 等拼写;交换词的首尾字符,再检查结果是否仍在词表中。
也可以练习解释 ^.*$、\d{4}-\d{2}-\d{2} 和回引用,练习把斜杠替换成反斜杠后再还原,或分别用一个正则和多个 str_detect 完成同一任务。日期形状正确不代表日历日期有效;电话形状正确也不代表号码存在。练习时先写出数据约定,再设计输入。
原书还提出了颜色修饰词、内置数据集名称、英语拼写规则的练习,并链接正则填字游戏。它们适合继续训练模式组合;本文没有提供伪造的执行答案,也没有引入需要额外下载的数据分析结果。
这些规则还能用在哪里
在 tidyverse 中,matches(pattern) 可按正则选择列,能用于 select、rename_with、across 等支持 tidyselect 的位置;pivot_longer() 的 names_pattern 用带捕获组的正则拆解复杂列名。编者校正:原章把 names_pattern 描述成与 separate_wider_regex 类似的模式向量,容易误导;依据 tidyr 官方参考,这里应理解为包含捕获组的一个正则模式,而不是命名的分片向量。
separate_longer_delim() 和 separate_wider_delim() 的分隔符通常按字面处理,需要模式时可以显式传 regex(", ?"),表示逗号后可有一个空格。
在 base R 中,apropos("replace") 可寻找名称符合规则的可用对象,list.files(pattern = "\\.Rmd$") 可列出当前目录里名字以 .Rmd 结束的文件。后者只是文件名查询示例,本文没有对用户目录执行它。
不同位置未必使用同一个引擎。stringr 经由 stringi 使用 ICU;base R 常见函数使用 TRE,部分函数设 perl = TRUE 后使用 PCRE。基础语法大体相通,Unicode 字符范围、捕获、断言和 (?...) 扩展却可能不同。迁移规则时需要在目标引擎重新核对,而不是只看表达式长得一样。
来源与验证范围
原章节属于持续更新的第二版在线书,未给出可据此推定的首次发表日期。补充核对时,stringr 参考页标示 1.6.0,tidyr 参考页标示 1.3.2;它们是所读文档的版本标签,不是本地安装清单。未安装包、运行 R 代码、验证真实数据或做性能测试。
全书作者为 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund。官网版权说明采用 CC BY-NC-ND 3.0;公共许可本身不等于任意商业翻译或改编授权。本中文编译依据另行取得的翻译转载许可制作,保留原作者、来源与许可信息;原创技术图署名未完纪。










暂无评论内容