


用 NGINX 访问日志分析应用性能:从请求耗时追到应用内部阶段
原作者:Rick Nelson;原载 NGINX Community Blog,2016 年 1 月 7 日。本文按原文方法、配置和分析过程整理;涉及当前行为的说明标为“编辑补注”。原文:Using NGINX Logging for Application Performance Monitoring。
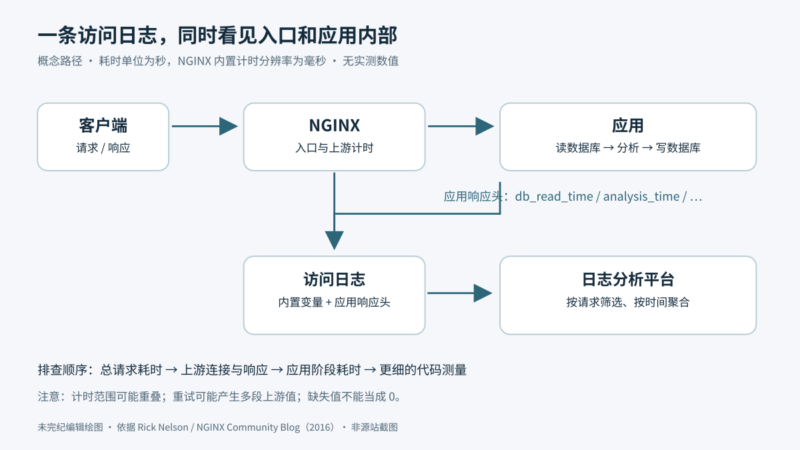
NGINX Plus 的实时监控仪表盘和 API 能呈现许多系统指标,帮助我们分析系统负载与性能。如果需要把问题缩小到某一次请求,NGINX 和 NGINX Plus 的访问日志则提供了更细的入口:从丰富的内置变量中选择所需字段,也可以给应用的不同部分定义不同的日志格式。
这种灵活性可以用来做应用性能分析。NGINX 不是完整 APM 工具的替代品,不过在应用代码里记录各阶段耗时,把结果放进响应头,再由 NGINX 写进访问日志,就能以较小的改动看见应用内部的时间分布。
原文把 NGINX 日志送到 Splunk 分析;Splunk 在这里是示例,其他能够解析字段、过滤请求并按时间聚合的日志平台也能采用相同思路。
先记录 NGINX 已有的计时变量
NGINX 提供几种可直接写入日志的计时变量,单位都是秒,分辨率为毫秒。例如,0.125 表示 125 毫秒,而不是 0.125 毫秒。
| 变量 | 它帮助我们观察什么 |
|---|---|
$request_time |
整个请求的处理时间。原文以“NGINX 读到客户端第一个字节,直到向客户端发出响应体最后一个字节”解释这个范围。 |
$upstream_connect_time |
建立上游连接所花的时间。 |
$upstream_header_time |
上游响应头的等待与接收时间。原文用从开始建立上游连接到收到响应头第一个字节来说明这一阶段。 |
$upstream_response_time |
上游响应的耗时。原文用从开始建立上游连接到收到响应体最后一个字节说明这一范围。 |
原文先定义名为 apm 的格式,除了四个计时字段,还记录请求、响应大小、状态、客户端和上游信息:
log_format apm '"$time_local" client=$remote_addr '
               'method=$request_method request="$request" '
               'request_length=$request_length '
               'status=$status bytes_sent=$bytes_sent '
               'body_bytes_sent=$body_bytes_sent '
               'referer=$http_referer '
               'user_agent="$http_user_agent" '
               'upstream_addr=$upstream_addr '
               'upstream_status=$upstream_status '
               'request_time=$request_time '
               'upstream_response_time=$upstream_response_time '
               'upstream_connect_time=$upstream_connect_time '
'upstream_header_time=$upstream_header_time';编辑补注:log_format 放在 http 配置上下文中;定义格式本身不会启用一条新日志。需要在适当的 http、server 或 location 范围通过 access_log 引用它。下文的同名格式是替换方案,不能把两个 log_format apm 同时粘到同一配置中。本文未提供可直接覆盖现网的完整配置,也未执行配置检查、重载或压测。
由总耗时定位到上游耗时
原文设定了一个排查场景:用户反馈应用响应缓慢,应用有三个 PHP 页面——apmtest.php、apmtest2.php 和 apmtest3.php。每个页面都会先查询数据库,再分析一部分数据,最后把结果写回数据库。作者向应用施加负载,分析 NGINX 访问日志;日志经 syslog 送进 Splunk。
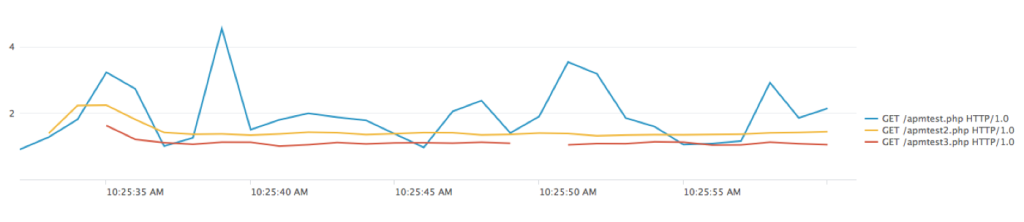
先按请求绘制 $request_time 的平均值:
* | timechart avg(request_time) by request作者给出的图表中,apmtest2.php 和 apmtest3.php 的请求耗时相对稳定,apmtest.php 则出现较大的波动。接着只筛选后者,同时观察上游响应耗时和连接耗时:
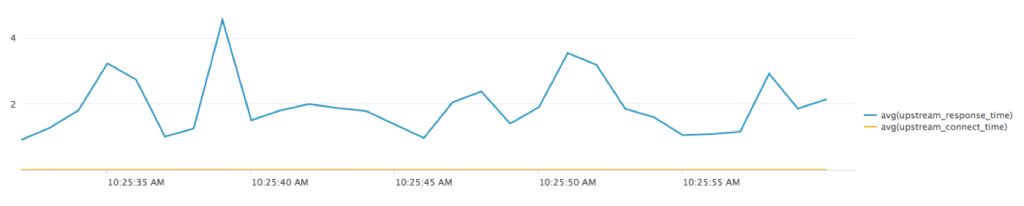
* | regex request="(^.+/apmtest.php.+$)" | timechart avg(upstream_response_time) avg(upstream_connect_time)在原文结果中,上游连接耗时很小;总响应时间较大且不稳定,主要随上游响应耗时变化。因此,这个例子下一步应继续深入应用处理过程。这里转述的是原作者的实验观察,不是本稿重新执行得到的结论。
让应用把内部阶段耗时写进响应头
上游响应慢仍然只是一个方向。要再往里看,需要由应用自行计时,然后通过响应头把各阶段的时间交给 NGINX。计时要分到多细,取决于问题和能够接受的开销。
沿用前面的场景,原文让应用返回四个字段:
db_read_time:数据库读取耗时。db_write_time:数据库写入耗时。analysis_time:数据分析耗时。other_time:其余处理耗时。
NGINX 通过 $upstream_http_ 前缀访问上游响应头。例如,响应头 db_read_time 对应 $upstream_http_db_read_time,这些变量可以像标准变量一样写进访问日志。
编辑补注:当前文档规定,响应头名称转为变量名时会改成小写,并把连字符变成下划线。新设计也可使用 Db-Read-Time 等带连字符的头名,仍对应 $upstream_http_db_read_time。这是一项互操作性建议,下面仍保留原文的命名与格式。应用需要统一时间单位、明确计时边界;这些头是否都存在、能否相加以及是否覆盖失败路径,都属于应用的计时约定,NGINX 不会自动替应用完成。
原文把这些变量追加到日志中,形成下面的第二版格式:
log_format apm 'timestamp="$time_local" client=$remote_addr '
               'request="$request" request_length=$request_length '
               'bytes_sent=$bytes_sent '
               'body_bytes_sent=$body_bytes_sent '
               'referer=$http_referer '
               'user_agent="$http_user_agent" '
               'upstream_addr=$upstream_addr '
               'upstream_status=$upstream_status '
               'request_time=$request_time '
               'upstream_response_time=$upstream_response_time '
               'upstream_connect_time=$upstream_connect_time '
               'upstream_header_time=$upstream_header_time '
               'app_db_read_time=$upstream_http_db_read_time '
               'app_db_write_time=$upstream_http_db_write_time '
               'app_analysis_time=$upstream_http_analysis_time '
               'app_other_time=$upstream_http_other_time ';
这一版并不是在第一版末尾单纯增加四个字段:原文同时给时间字段加了 timestamp=,并省去了独立的 method 和下游 status 字段。译文保留这些差异。实际使用时通常仍需保留状态信息,以免把成功请求和错误响应混在一起。
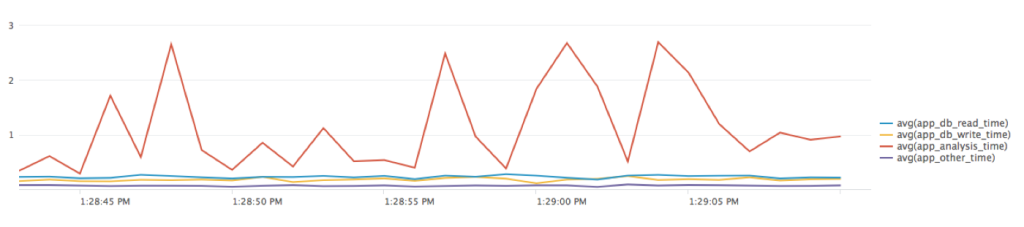
作者随后只针对 apmtest.php 再做一次测试,用下面的查询观察四类应用耗时:
* | timechart avg(app_db_read_time), avg(app_db_write_time), avg(app_analysis_time), avg(app_other_time)原文图表显示,数据分析阶段既占据最大的处理时间,也随总响应时间一起波动。接下来可以在分析代码中继续细分计时,或者回到日志明细,寻找哪些请求特征与较长的耗时有关。平均值用于这一步示例分析,并不能揭示所有慢请求;如果要持续监控,还应结合请求量、错误率和分位数,而不能仅凭平均值判定体验是否良好。
把日志方案用于实际系统前,需要补上的边界
这一节是编辑依据源配置所做的静态审查与补充,不属于 Rick Nelson 原文,也不代表任何部署或测试已经通过。
日志包含可能敏感的输入
原格式记录客户端地址、完整请求行、Referer、User-Agent 和上游地址。请求行与 Referer 可能包含查询参数或内部路径;应用计时头也不应夹带 SQL、访问令牌、用户数据或详细内部标识。应先确定真正需要的字段,再限制日志读取权限、留存时间和转发目的地。不要为了排查性能把原始业务数据一起写出。
转义不等于消除了所有解析风险
原文使用默认转义,NGINX 会转义引号、反斜杠与控制字符,因此不能把这份配置直接描述成“允许任意换行注入”。但若日志收集器把未加引号的 referer=... 或应用头简单按空格拆开,上游或客户端可控的字符串仍可能污染字段解释。需要明确日志协议和字段类型,不能只假定所有采集器都能正确解析。
下面给出一份编辑修正版格式片段。它使用 NGINX 1.11.8 起支持的 escape=json,把所有值写成 JSON 字符串;不记录完整请求行、Referer 与 User-Agent,也不包含客户端 IP。它保留方法、状态和 URI,但 URI 本身仍可能包含敏感路径,必须按业务再决定是否改用允许列表中的路由名。这个片段经过静态核对,未运行:
log_format apm_json escape=json
    '{"time":"$time_iso8601",'
    '"method":"$request_method",'
    '"uri":"$uri",'
    '"status":"$status",'
    '"request_time":"$request_time",'
    '"upstream_status":"$upstream_status",'
    '"upstream_connect_time":"$upstream_connect_time",'
    '"upstream_header_time":"$upstream_header_time",'
    '"upstream_response_time":"$upstream_response_time",'
    '"app_db_read_time":"$upstream_http_db_read_time",'
    '"app_db_write_time":"$upstream_http_db_write_time",'
    '"app_analysis_time":"$upstream_http_analysis_time",'
    '"app_other_time":"$upstream_http_other_time"}';
与原文相比,这一版更改了序列化格式、时间格式和采集字段。采集端必须先按 JSON 解码,再校验并转换数字;不要把缺失的计时头当成零。上游重试或内部跳转时,上游耗时字段可能包含以逗号或冒号分隔的多段值,不能直接当单个浮点数使用。上游响应头变量只保留最后一个上游响应的头,应用内部阶段耗时也不能自动代表此前所有失败尝试。
响应头与日志通路也需要控制
这些内部耗时头可能继续被发给客户端,应按所用代理协议决定是否在对外响应中隐藏,同时确保内部日志仍按预期采集。原文没有给出具体 syslog 传输配置,不能据此推断日志链路已经加密或可靠送达;若日志跨主机传输,需要按实际采集系统核对传输保护和丢失处理。持续采集还会增加应用计时、日志写入、存储及索引开销,应在隔离环境评估后再逐步启用。
从一次排查扩展到持续观察
成熟 APM 工具能够提供更广泛的性能分析能力,但其部署和维护也可能更复杂。原文展示的是一个直接的补充办法:把 NGINX 已有的请求计时,与应用自己知道的处理阶段放到同一条访问日志,再用日志平台找出变化发生在哪一层。
这个方法既能用于一次性的性能排查,也能长期保留应用级计时,帮助发现异常。它的价值在于提供有边界、可追溯的请求级线索;找到了相关性之后,仍应结合真实业务、请求分布与更深入的测量判断原因。










暂无评论内容