


TiDB Bookshop 分页批处理与分批删除
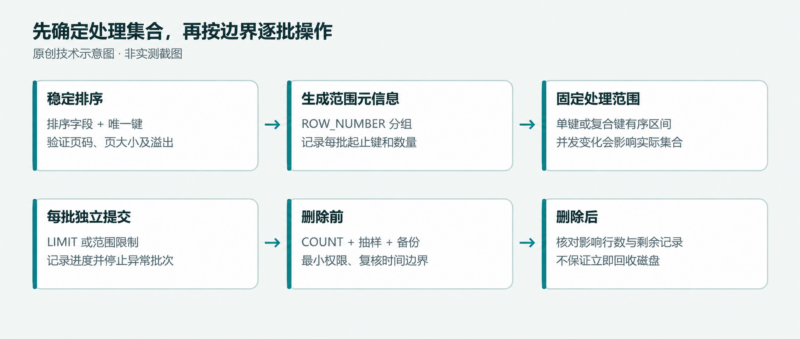
将分页查询与批量删除结合起来,保留单键、复合键范围切分和多语言示例,并补充稳定排序、错误退出、权限与并发边界。
来源:PingCAP 与 TiDB 文档贡献者,《删除数据》和《分页查询》。本稿根据两页 release-8.5 文档合并翻译;页面版本来自官方文档元数据。删除数据 · 分页查询
两章合并后的阅读顺序
下方保留 PingCAP Bookshop 教程的“分页查询”和“删除数据”两章完整译文。建议先读分页与范围元信息,再读删除操作;本稿未对任何数据库执行。
所有 SQL、Java、Go 和 Python 例子均只做静态审查。样例中的 root 空口令是本地演示配置,真实环境应使用最小权限账号和受控凭据来源,不把明文口令写进代码。
分页必须有稳定排序和输入上限
只按 published_at DESC 排序,时间相同的行之间没有唯一顺序。编辑建议补上 id DESC 等唯一键:
SELECT id, title, published_at
FROM books
ORDER BY published_at DESC, id DESC
LIMIT ?, ?;
绑定参数仍应先验证:页码不小于 1、页大小具有业务上限,并检查 (pageNumber - 1) * pageSize 是否溢出。原文只设最小页大小,不足以防止极大查询。稳定排序也不会自动给跨请求分页提供一致性快照,并发写入时仍需明确业务语义。
范围元信息不是冻结的数据集合
原文利用窗口函数给行编号,再按每页大小聚合最小键、最大键和记录数,可以减少不断增加 OFFSET 的成本。但生成元信息之后,若有新行插入某段键范围或键值发生修改,后续按范围处理的集合可能已改变。
复合键用 LPAD(...,19,0) 拼字符串的办法只适用于文中受控非负 ID。负数、超出十九位的无符号数、不同排序规则或任意字符串不能直接照搬。
分页章最后的复合键实例,文字称“删除”,给出的实际语句却是 SELECT *;应将它视为范围预览。不要把阅读查询结果等同于执行过删除。
修正 Java 出错后无限重试的问题
原删除章 batchDelete 在异常后返回 -1,外层 while (updateCount != 0) 会继续调用。数据库持续报错时可能无限重试。下面是包含完整类级结构的编辑修正版。调用方传入数据源与固定时间范围,并自行决定如何记录异常。SQL 异常会从 deleteRange 向上传播,错误时停止,不返回 -1 并重复重试。代码只作静态审查,未编译或执行:
import com.mysql.cj.jdbc.MysqlDataSource;
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.sql.Timestamp;

final class BatchDeleteExample {
    static int deleteBatch(MysqlDataSource ds,
                           Timestamp start, Timestamp end) throws SQLException {
        String sql = "DELETE FROM bookshop.ratings "
            + "WHERE rated_at >= ? AND rated_at <= ? "
            + "LIMIT 1000";
        try (Connection c = ds.getConnection();
             PreparedStatement s = c.prepareStatement(sql)) {
            s.setTimestamp(1, start);
            s.setTimestamp(2, end);
            return s.executeUpdate();
        }
    }

    static void deleteRange(MysqlDataSource ds,
                            Timestamp start, Timestamp end) throws SQLException {
        int count;
        do {
            count = deleteBatch(ds, start, end);
        } while (count != 0);
    }
}
上述片段中的连接、时间参数和必要 Java imports 由调用程序提供。若需要重试,应明确最大次数、退避和可重试错误范围,而不是无限吞错。长期持续写入同一时间窗口也可能使循环迟迟无法结束,任务必须具有确定的处理范围。
删除与回退的实际边界
执行前应使用相同 WHERE 条件计数并抽样,明确时间端点是否包含在内,准备经过验证的备份。参数化查询能保护值参数不被当作 SQL 代码解释;表名等动态标识符仍须来自受控集合。
小批 DELETE 通常每批独立提交,非事务 DML 更明确地牺牲整体原子性与隔离性。任何一种都不能承诺“中间出错时整批自动撤回”。原文讨论 TRUNCATE 是全表清空场景,不能把它当作修复慢删除的随手替代命令。
DELETE 之后磁盘占用不会立即下降;GC、旧版本保留和统计信息更新还会影响后续行为。文中的默认值是文档版本语境,操作时需核对实例配置。
下面保留两章完整译文以便逐项核对,以上是编辑补注。DELETE 和 BATCH ON 示例会改变数据;运行前应核对实例、WHERE 范围、影响行数和备份,并使用最小权限账号。本稿没有执行这些示例。
本节译自 PingCAP 官方《删除数据》文档:https://docs.pingcap.com/zh/developer/dev-guide-delete-data/
删除数据
此页面将使用 DELETE SQL 语句,对 TiDB 中的数据进行删除。如果需要周期性地删除过期数据,可以考虑使用 TiDB 的 TTL 功能。
在开始之前
在阅读本页面之前,你需要准备以下事项:
SQL 语法
在 SQL 中,DELETE 语句一般为以下形式:
DELETE FROM {table} WHERE {filter}
| 参数 | 描述 |
|---|---|
{table} |
表名 |
{filter} |
过滤器匹配条件 |
此处仅展示 DELETE 的简单用法,详细文档可参考 TiDB 的 DELETE 语法。
最佳实践
以下是删除行时需要遵循的一些最佳实践:
- 始终在删除语句中指定
WHERE子句。如果DELETE没有WHERE子句,TiDB 将删除这个表内的所有行。 - 需要删除大量行(数万或更多)的时候,使用批量删除,这是因为 TiDB 单个事务大小限制为 txn-total-size-limit(默认为 100MB)。
- 如果你需要删除表内的所有数据,请勿使用
DELETE语句,而应该使用 TRUNCATE 语句。 - 查看性能注意事项。
- 在需要大批量删除数据的场景下,非事务批量删除对性能的提升十分明显。但与之相对的,这将丢失删除的事务性,因此无法进行回滚,请务必正确进行操作选择。
例子
假设在开发中发现在特定时间段内,发生了业务错误,需要删除这期间内的所有 rating 的数据,例如,2022-04-15 00:00:00 至 2022-04-15 00:15:00 的数据。此时,可使用 SELECT 语句查看需删除的数据条数:
SELECT COUNT(*) FROM `ratings` WHERE `rated_at` >= "2022-04-15 00:00:00" AND `rated_at` <= "2022-04-15 00:15:00";
- 若返回数量大于 1 万条,请参考批量删除。
- 若返回数量小于 1 万条,可参考下面的示例进行删除:
在 SQL 中,删除数据的示例如下:
DELETE FROM `ratings` WHERE `rated_at` >= "2022-04-15 00:00:00" AND `rated_at` <= "2022-04-15 00:15:00";
在 Java 中,删除数据的示例如下:
// ds is an entity of com.mysql.cj.jdbc.MysqlDataSource

try (Connection connection = ds.getConnection()) {
    String sql = "DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= ? AND  `rated_at` <= ?";
    PreparedStatement preparedStatement = connection.prepareStatement(sql);
    Calendar calendar = Calendar.getInstance();
    calendar.set(Calendar.MILLISECOND, 0);

    calendar.set(2022, Calendar.APRIL, 15, 0, 0, 0);
    preparedStatement.setTimestamp(1, new Timestamp(calendar.getTimeInMillis()));

    calendar.set(2022, Calendar.APRIL, 15, 0, 15, 0);
    preparedStatement.setTimestamp(2, new Timestamp(calendar.getTimeInMillis()));

    preparedStatement.executeUpdate();
} catch (SQLException e) {
    e.printStackTrace();
}
在 Golang 中,删除数据的示例如下:
package main

import (
    "database/sql"
    "fmt"
    "time"

    _ "github.com/go-sql-driver/mysql"
)

func main() {
    db, err := sql.Open("mysql", "root:@tcp(127.0.0.1:4000)/bookshop")
    if err != nil {
        panic(err)
    }
    defer db.Close()

    startTime := time.Date(2022, 04, 15, 0, 0, 0, 0, time.UTC)
    endTime := time.Date(2022, 04, 15, 0, 15, 0, 0, time.UTC)

    bulkUpdateSql := fmt.Sprintf("DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= ? AND  `rated_at` <= ?")
    result, err := db.Exec(bulkUpdateSql, startTime, endTime)
    if err != nil {
        panic(err)
    }
    _, err = result.RowsAffected()
    if err != nil {
        panic(err)
    }
}
在 Python 中,删除数据的示例如下:
import MySQLdb
import datetime
import time

connection = MySQLdb.connect(
    host="127.0.0.1",
    port=4000,
    user="root",
    password="",
    database="bookshop",
    autocommit=True
)

with connection:
    with connection.cursor() as cursor:
        start_time = datetime.datetime(2022, 4, 15)
        end_time = datetime.datetime(2022, 4, 15, 0, 15)
        delete_sql = "DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= %s AND `rated_at` <= %s"
        affect_rows = cursor.execute(delete_sql, (start_time, end_time))
        print(f'delete {affect_rows} data')
注意
rated_at 字段为日期和时间类型中的 DATETIME 类型,你可以认为它在 TiDB 保存时,存储为一个字面量,与时区无关。而 TIMESTAMP 类型,将会保存一个时间戳,从而在不同的时区配置时,展示不同的时间字符串。
另外,和 MySQL 一样,TIMESTAMP 数据类型受 2038 年问题的影响。如果存储的值大于 2038,建议使用 DATETIME 类型。
性能注意事项
TiDB GC 机制
DELETE 语句运行之后 TiDB 并非立刻删除数据,而是将这些数据标记为可删除。然后等待 TiDB GC (Garbage Collection) 来清理不再需要的旧数据。因此,你的 DELETE 语句并不会立即减少磁盘用量。
GC 在默认配置中,为 10 分钟触发一次,每次 GC 都会计算出一个名为 safe_point 的时间点,这个时间点前的数据,都不会再被使用到,因此,TiDB 可以安全的对数据进行清除。
GC 的具体实现方案和细节此处不再展开,请参考 GC 机制简介了解更详细的 GC 说明。
更新统计信息
TiDB 使用常规统计信息来决定索引的选择,因此,在大批量的数据删除之后,很有可能会导致索引选择不准确的情况发生。你可以使用手动收集的办法,更新统计信息。用以给 TiDB 优化器以更准确的统计信息来提供 SQL 性能优化。
批量删除
需要删除表中多行的数据,可选择 DELETE 示例,并使用 WHERE 子句过滤需要删除的数据。
但如果你需要删除大量行(数万或更多)的时候,建议使用一个迭代,每次都只删除一部分数据,直到删除全部完成。这是因为 TiDB 单个事务大小限制为 txn-total-size-limit(默认为 100MB)。你可以在程序或脚本中使用循环来完成操作。
本页提供了编写脚本来处理循环删除的示例,该示例演示了应如何进行 SELECT 和 DELETE 的组合,完成循环删除。
编写批量删除循环
在你的应用或脚本的循环中,编写一个 DELETE 语句,使用 WHERE 子句过滤需要删除的行,并使用 LIMIT 限制单次删除的数据条数。
批量删除例子
假设发现在特定时间段内,发生了业务错误,需要删除这期间内的所有 rating 的数据,例如,2022-04-15 00:00:00 至 2022-04-15 00:15:00 的数据。并且在 15 分钟内,有大于 1 万条数据被写入,此时请使用循环删除的方式进行删除:
在 Java 中,批量删除程序类似于以下内容:
package com.pingcap.bulkDelete;

import com.mysql.cj.jdbc.MysqlDataSource;

import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.sql.Timestamp;
import java.util.Calendar;
import java.util.concurrent.TimeUnit;

public class BatchDeleteExample
{
    public static void main(String[] args) throws InterruptedException {
        // Configure the example database connection.

        // Create a mysql data source instance.
        MysqlDataSource mysqlDataSource = new MysqlDataSource();

        // Set server name, port, database name, username and password.
        mysqlDataSource.setServerName("localhost");
        mysqlDataSource.setPortNumber(4000);
        mysqlDataSource.setDatabaseName("bookshop");
        mysqlDataSource.setUser("root");
        mysqlDataSource.setPassword("");

        Integer updateCount = -1;
        while (updateCount != 0) {
            updateCount = batchDelete(mysqlDataSource);
        }
    }

    public static Integer batchDelete (MysqlDataSource ds) {
        try (Connection connection = ds.getConnection()) {
            String sql = "DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= ? AND  `rated_at` <= ? LIMIT 1000";
            PreparedStatement preparedStatement = connection.prepareStatement(sql);
            Calendar calendar = Calendar.getInstance();
            calendar.set(Calendar.MILLISECOND, 0);

            calendar.set(2022, Calendar.APRIL, 15, 0, 0, 0);
            preparedStatement.setTimestamp(1, new Timestamp(calendar.getTimeInMillis()));

            calendar.set(2022, Calendar.APRIL, 15, 0, 15, 0);
            preparedStatement.setTimestamp(2, new Timestamp(calendar.getTimeInMillis()));

            int count = preparedStatement.executeUpdate();
            System.out.println("delete " + count + " data");

            return count;
        } catch (SQLException e) {
            e.printStackTrace();
        }

        return -1;
    }
}
每次迭代中,DELETE 最多删除 1000 行时间段为 2022-04-15 00:00:00 至 2022-04-15 00:15:00 的数据。
在 Golang 中,批量删除程序类似于以下内容:
package main

import (
    "database/sql"
    "fmt"
    "time"

    _ "github.com/go-sql-driver/mysql"
)

func main() {
    db, err := sql.Open("mysql", "root:@tcp(127.0.0.1:4000)/bookshop")
    if err != nil {
        panic(err)
    }
    defer db.Close()

    affectedRows := int64(-1)
    startTime := time.Date(2022, 04, 15, 0, 0, 0, 0, time.UTC)
    endTime := time.Date(2022, 04, 15, 0, 15, 0, 0, time.UTC)

    for affectedRows != 0 {
        affectedRows, err = deleteBatch(db, startTime, endTime)
        if err != nil {
            panic(err)
        }
    }
}

// deleteBatch delete at most 1000 lines per batch
func deleteBatch(db *sql.DB, startTime, endTime time.Time) (int64, error) {
    bulkUpdateSql := fmt.Sprintf("DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= ? AND  `rated_at` <= ? LIMIT 1000")
    result, err := db.Exec(bulkUpdateSql, startTime, endTime)
    if err != nil {
        return -1, err
    }
    affectedRows, err := result.RowsAffected()
    if err != nil {
        return -1, err
    }

    fmt.Printf("delete %d data\n", affectedRows)
    return affectedRows, nil
}
每次迭代中,DELETE 最多删除 1000 行时间段为 2022-04-15 00:00:00 至 2022-04-15 00:15:00 的数据。
在 Python 中,批量删除程序类似于以下内容:
import MySQLdb
import datetime
import time

connection = MySQLdb.connect(
    host="127.0.0.1",
    port=4000,
    user="root",
    password="",
    database="bookshop",
    autocommit=True
)

with connection:
    with connection.cursor() as cursor:
        start_time = datetime.datetime(2022, 4, 15)
        end_time = datetime.datetime(2022, 4, 15, 0, 15)
        affect_rows = -1
        while affect_rows != 0:
            delete_sql = "DELETE FROM `bookshop`.`ratings` WHERE `rated_at` >= %s AND  `rated_at` <= %s LIMIT 1000"
            affect_rows = cursor.execute(delete_sql, (start_time, end_time))
            print(f'delete {affect_rows} data')
            time.sleep(1)
每次迭代中,DELETE 最多删除 1000 行时间段为 2022-04-15 00:00:00 至 2022-04-15 00:15:00 的数据。
非事务批量删除
注意
TiDB 从 v6.1.0 版本开始支持非事务 DML 语句特性。在 TiDB v6.1.0 以下版本中无法使用此特性。
使用前提
在使用非事务批量删除前,请先仔细阅读非事务 DML 语句。非事务批量删除,本质是以牺牲事务的原子性、隔离性为代价,增强批量数据处理场景下的性能和易用性。
因此在使用过程中,需要极为小心,否则,因为操作的非事务特性,在误操作时会导致严重的后果(如数据丢失等)。
非事务批量删除 SQL 语法
非事务批量删除的 SQL 语法如下:
BATCH ON {shard_column} LIMIT {batch_size} {delete_statement};
| 参数 | 描述 |
|---|---|
{shard_column} |
非事务批量删除的划分列 |
{batch_size} |
非事务批量删除的每批大小 |
{delete_statement} |
删除语句 |
此处仅展示非事务批量删除的简单用法,详细文档可参考 TiDB 的非事务 DML 语句。
非事务批量删除使用示例
以上方批量删除例子场景为例,可使用以下 SQL 语句进行非事务批量删除:
BATCH ON `rated_at` LIMIT 1000 DELETE FROM `ratings` WHERE `rated_at` >= "2022-04-15 00:00:00" AND `rated_at` <= "2022-04-15 00:15:00";
文档内容是否有帮助?
本节译自 PingCAP 官方《分页查询》文档:https://docs.pingcap.com/zh/developer/dev-guide-paginate-results/
分页查询
当查询结果数据量较大时,往往希望以“分页”的方式返回所需要的部分。
对查询结果进行分页
在 TiDB 当中,可以利用 LIMIT 语句来实现分页功能,常规的分页语句写法如下所示:
SELECT * FROM table_a t ORDER BY gmt_modified DESC LIMIT offset, row_count;
offset 表示起始记录数,row_count 表示每页记录数。除此之外,TiDB 也支持 LIMIT row_count OFFSET offset 语法。
除非明确要求不要使用任何排序来随机展示数据,使用分页查询语句时都应该通过 ORDER BY 语句指定查询结果的排序方式。
例如,在 Bookshop 应用当中,希望将最新书籍列表以分页的形式返回给用户。通过 LIMIT 0, 10 语句,便可以得到列表第 1 页的书籍信息,每页中最多有 10 条记录。获取第 2 页信息,则改成可以改成 LIMIT 10, 10,如此类推。
SELECT *
FROM books
ORDER BY published_at DESC
LIMIT 0, 10;
在使用 Java 开发应用程序时,后端程序从前端接收到的参数页码 page_number 和每页的数据条数 page_size,而不是起始记录数 offset,因此在进行数据库查询前需要对其进行一些转换。
public List<Book> getLatestBooksPage(Long pageNumber, Long pageSize) throws SQLException {
    pageNumber = pageNumber < 1L ? 1L : pageNumber;
    pageSize = pageSize < 10L ? 10L : pageSize;
    Long offset = (pageNumber - 1) * pageSize;
    Long limit = pageSize;
    List<Book> books = new ArrayList<>();
    try (Connection conn = ds.getConnection()) {
        PreparedStatement stmt = conn.prepareStatement("""
        SELECT id, title, published_at
        FROM books
        ORDER BY published_at DESC
        LIMIT ?, ?;
        """);
        stmt.setLong(1, offset);
        stmt.setLong(2, limit);
        ResultSet rs = stmt.executeQuery();
        while (rs.next()) {
            Book book = new Book();
            book.setId(rs.getLong("id"));
            book.setTitle(rs.getString("title"));
            book.setPublishedAt(rs.getDate("published_at"));
            books.add(book);
        }
    }
    return books;
}
单字段主键表的分页批处理
常规的分页更新 SQL 一般使用主键或者唯一索引进行排序,再配合 LIMIT 语法中的 offset,按固定行数拆分页面。然后把页面包装进独立的事务中,从而实现灵活的分页更新。但是,劣势也很明显:由于需要对主键或者唯一索引进行排序,越靠后的页面参与排序的行数就会越多,尤其当批量处理涉及的数据体量较大时,可能会占用过多计算资源。
下面将介绍一种更为高效的分页批处理方案:
使用 SQL 实现分页批处理,可以按照如下步骤进行:
首先将数据按照主键排序,然后调用窗口函数 row_number() 为每一行数据生成行号,接着调用聚合函数按照设置好的页面大小对行号进行分组,最终计算出每页的最小值和最大值。
SELECT
    floor((t.row_num - 1) / 1000) + 1 AS page_num,
    min(t.id) AS start_key,
    max(t.id) AS end_key,
    count(*) AS page_size
FROM (
    SELECT id, row_number() OVER (ORDER BY id) AS row_num
    FROM books
) t
GROUP BY page_num
ORDER BY page_num;
查询结果如下:
+----------+------------+------------+-----------+
| page_num | start_key  | end_key    | page_size |
+----------+------------+------------+-----------+
|        1 |     268996 |  213168525 |      1000 |
|        2 |  213210359 |  430012226 |      1000 |
|        3 |  430137681 |  647846033 |      1000 |
|        4 |  647998334 |  848878952 |      1000 |
|        5 |  848899254 | 1040978080 |      1000 |
...
|       20 | 4077418867 | 4294004213 |      1000 |
+----------+------------+------------+-----------+
20 rows in set (0.01 sec)
接下来,只需要使用 WHERE id BETWEEN start_key AND end_key 语句查询每个分片的数据即可。修改数据时,也可以借助上面计算好的分片信息,实现高效的数据更新。
例如,假如想要删除第 1 页上的所有书籍的基本信息,可以将上表第 1 页所对应的 start_key 和 end_key 填入 SQL 语句当中。
DELETE FROM books
WHERE
    id BETWEEN 268996 AND 213168525
ORDER BY id;
在 Java 语言当中,可以定义一个 PageMeta 类来存储分页元信息。
public class PageMeta<K> {
    private Long pageNum;
    private K startKey;
    private K endKey;
    private Long pageSize;

    // Skip the getters and setters.

}
定义一个 getPageMetaList() 方法获取到分页元信息列表,然后定义一个可以根据页面元信息批量删除数据的方法 deleteBooksByPageMeta()。
public class BookDAO {
    public List<PageMeta<Long>> getPageMetaList() throws SQLException {
        List<PageMeta<Long>> pageMetaList = new ArrayList<>();
        try (Connection conn = ds.getConnection()) {
            Statement stmt = conn.createStatement();
            ResultSet rs = stmt.executeQuery("""
            SELECT
                floor((t.row_num - 1) / 1000) + 1 AS page_num,
                min(t.id) AS start_key,
                max(t.id) AS end_key,
                count(*) AS page_size
            FROM (
                SELECT id, row_number() OVER (ORDER BY id) AS row_num
                FROM books
            ) t
            GROUP BY page_num
            ORDER BY page_num;
            """);
            while (rs.next()) {
                PageMeta<Long> pageMeta = new PageMeta<>();
                pageMeta.setPageNum(rs.getLong("page_num"));
                pageMeta.setStartKey(rs.getLong("start_key"));
                pageMeta.setEndKey(rs.getLong("end_key"));
                pageMeta.setPageSize(rs.getLong("page_size"));
                pageMetaList.add(pageMeta);
            }
        }
        return pageMetaList;
    }

    public void deleteBooksByPageMeta(PageMeta<Long> pageMeta) throws SQLException {
        try (Connection conn = ds.getConnection()) {
            PreparedStatement stmt = conn.prepareStatement("DELETE FROM books WHERE id >= ? AND id <= ?");
            stmt.setLong(1, pageMeta.getStartKey());
            stmt.setLong(2, pageMeta.getEndKey());
            stmt.executeUpdate();
        }
    }
}
如果想要删除第 1 页的数据,可以这样写:
List<PageMeta<Long>> pageMetaList = bookDAO.getPageMetaList();
if (pageMetaList.size() > 0) {
    bookDAO.deleteBooksByPageMeta(pageMetaList.get(0));
}
如果希望通过分页分批地删除所有书籍数据,可以这样写:
List<PageMeta<Long>> pageMetaList = bookDAO.getPageMetaList();
pageMetaList.forEach((pageMeta) -> {
    try {
        bookDAO.deleteBooksByPageMeta(pageMeta);
    } catch (SQLException e) {
        e.printStackTrace();
    }
});
改进方案由于规避了频繁的数据排序操作造成的性能损耗,显著改善了批量处理的效率。
复合主键表的分页批处理
非聚簇索引表
对于非聚簇索引表(又被称为“非索引组织表”)而言,可以使用隐藏字段 _tidb_rowid 作为分页的 key,分页的方法与单列主键表中所介绍的方法相同。
小贴士
你可以通过 SHOW CREATE TABLE users; 语句查看表主键是否使用了聚簇索引。
例如:
SELECT
    floor((t.row_num - 1) / 1000) + 1 AS page_num,
    min(t._tidb_rowid) AS start_key,
    max(t._tidb_rowid) AS end_key,
    count(*) AS page_size
FROM (
    SELECT _tidb_rowid, row_number() OVER (ORDER BY _tidb_rowid) AS row_num
    FROM users
) t
GROUP BY page_num
ORDER BY page_num;
查询结果如下:
+----------+-----------+---------+-----------+
| page_num | start_key | end_key | page_size |
+----------+-----------+---------+-----------+
|        1 |         1 |    1000 |      1000 |
|        2 |      1001 |    2000 |      1000 |
|        3 |      2001 |    3000 |      1000 |
|        4 |      3001 |    4000 |      1000 |
|        5 |      4001 |    5000 |      1000 |
|        6 |      5001 |    6000 |      1000 |
|        7 |      6001 |    7000 |      1000 |
|        8 |      7001 |    8000 |      1000 |
|        9 |      8001 |    9000 |      1000 |
|       10 |      9001 |    9990 |       990 |
+----------+-----------+---------+-----------+
10 rows in set (0.00 sec)
聚簇索引表
对于聚簇索引表(又被称为“索引组织表”),可以利用 concat 函数将多个列的值连接起来作为一个 key,然后使用窗口函数获取分页信息。
需要注意的是,这时候 key 是一个字符串,你必须确保这个字符串长度总是相等的,才能够通过 min 和 max 聚合函数得到分页内正确的 start_key 和 end_key。如果进行字符串连接的字段长度不固定,你可以通过 LPAD 函数进行补全。
例如,想要对 ratings 表里的数据进行分页批处理。
先可以通过下面的 SQL 语句来在制造元信息表。因为组成 key 的 book_id 列和 user_id 列都是 bigint 类型,转换为字符串是并不是等宽的,因此需要根据 bigint 类型的最大位数 19,使用 LPAD 函数在长度不够时用 0 补齐。
SELECT
    floor((t1.row_num - 1) / 10000) + 1 AS page_num,
    min(mvalue) AS start_key,
    max(mvalue) AS end_key,
    count(*) AS page_size
FROM (
    SELECT
        concat('(', LPAD(book_id, 19, 0), ',', LPAD(user_id, 19, 0), ')') AS mvalue,
        row_number() OVER (ORDER BY book_id, user_id) AS row_num
    FROM ratings
) t1
GROUP BY page_num
ORDER BY page_num;
注意
该 SQL 会以全表扫描 (TableFullScan) 方式执行,当数据量较大时,查询速度会变慢,此时可以使用 TiFlash 进行加速。
查询结果如下:
+----------+-------------------------------------------+-------------------------------------------+-----------+
| page_num | start_key                                 | end_key                                   | page_size |
+----------+-------------------------------------------+-------------------------------------------+-----------+
|        1 | (0000000000000268996,0000000000092104804) | (0000000000140982742,0000000000374645100) |     10000 |
|        2 | (0000000000140982742,0000000000456757551) | (0000000000287195082,0000000004053200550) |     10000 |
|        3 | (0000000000287196791,0000000000191962769) | (0000000000434010216,0000000000237646714) |     10000 |
|        4 | (0000000000434010216,0000000000375066168) | (0000000000578893327,0000000002167504460) |     10000 |
|        5 | (0000000000578893327,0000000002457322286) | (0000000000718287668,0000000001502744628) |     10000 |
...
|       29 | (0000000004002523918,0000000000902930986) | (0000000004147203315,0000000004090920746) |     10000 |
|       30 | (0000000004147421329,0000000000319181561) | (0000000004294004213,0000000003586311166) |      9972 |
+----------+-------------------------------------------+-------------------------------------------+-----------+
30 rows in set (0.28 sec)
假如想要删除第 1 页上的所有评分记录,可以将上表第 1 页所对应的 start_key 和 end_key 填入 SQL 语句当中。
SELECT *
FROM ratings
WHERE (
        268996 = 140982742
        AND book_id = 268996
        AND user_id >= 92104804
        AND user_id <= 374645100
    )
    OR (
        268996 != 140982742
        AND (
            (
                book_id > 268996
                AND book_id < 140982742
            )
            OR (
                book_id = 268996
                AND user_id >= 92104804
            )
            OR (
                book_id = 140982742
                AND user_id <= 374645100
            )
        )
    )
ORDER BY book_id, user_id;
文档内容是否有帮助?
来源、署名与许可
原作者/维护方:PingCAP 与 TiDB 文档贡献者。《删除数据》与《分页查询》源文分别见上方链接,本文为两页内容的中文翻译与编辑性合并。官方 docs-cn 仓库说明:TiDB v7.0 起文档采用 CC BY-SA 3.0;本稿所据页面元数据为 release-8.5。本文翻译与改编内容按 CC BY-SA 3.0 发布,完整许可文本随附于 LICENSE-CC-BY-SA-3.0.txt。原始数据、代码与输出示例归于相应官方文档贡献者。
编辑修改包括:为分页增加唯一排序键和输入范围说明;补充范围元信息、并发变化、批次事务和最小权限边界;指出原文 Java 批量删除示例遇错返回 -1 会导致循环继续,并提供异常时终止的编辑修正版;说明复合键章节末尾的 SELECT 只是范围预览。图 1 是未完纪编辑绘制的技术示意图,不是源站截图或实测结果;配图另行获准用于本次发布。
所有源文示例、修正版、配置和结果块均只作静态审查,没有运行 TiDB、数据库连接或删除任务;此说明不代表执行测试或性能验证。










暂无评论内容