


原作者:yuvraj sharma、Freddy Boulton、Abubakar Abid。本文翻译整理自 Hugging Face Blog 于 2026-04-27 发布的 How to build scalable web apps with OpenAI’s Privacy Filter,完整核对日期为 2026-10-05。
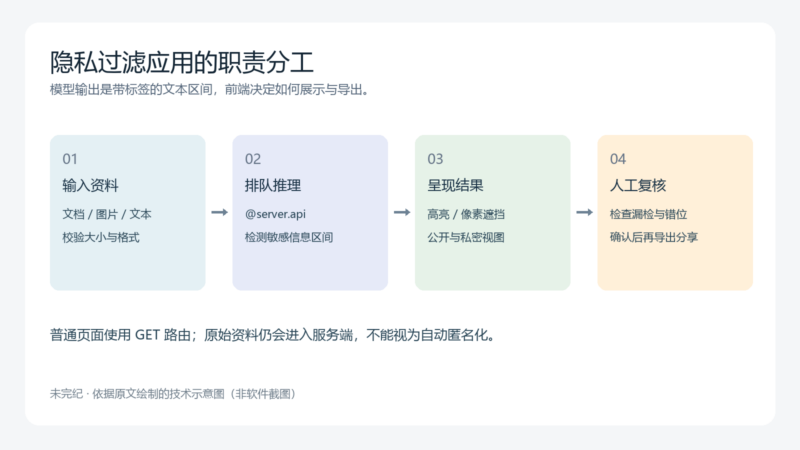
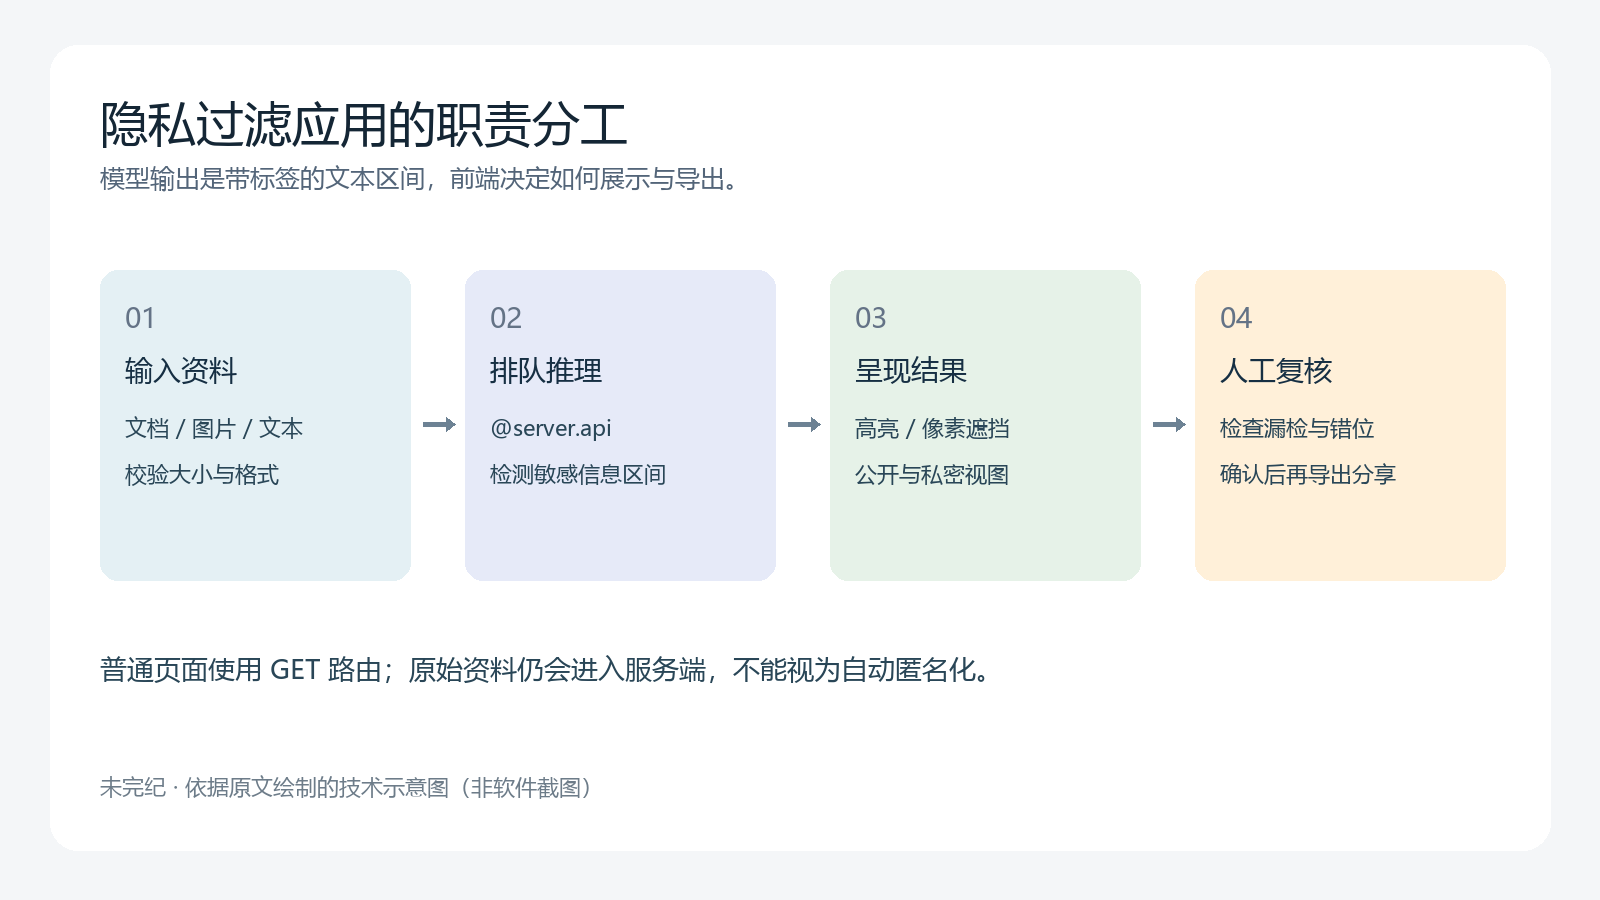
一个隐私实体检测模型,可以支持很不一样的界面:在文档里高亮个人信息,在截图上覆盖黑条,或者把日志中的敏感片段替换成占位符后再分享。原文作者基于 Privacy Filter 做了三个应用,后端都采用 gradio.Server,前端则按具体任务编写 HTML 与 JavaScript。共同的设计是把需要模型计算的请求交给 Gradio 队列,把普通页面与轻量查询保留为 FastAPI 路由。
模型识别什么,输出又是什么
原文介绍的 Privacy Filter 是一个个人可识别信息(PII)检测模型,总参数量约 15 亿,每个 token 使用约 5000 万活跃参数,支持 128,000 token 的上下文窗口,按 Apache 2.0 许可提供。它不逐词生成回答,而是对输入序列一次前向计算,给出隐私标签,再解码成连续片段。
八类输出标签为 private_person(姓名等个人标识)、private_address(私人地址)、private_email(私人邮箱)、private_phone(私人电话)、private_url(私人 URL)、private_date(相关私人日期)、account_number(账号)和 secret(秘密信息)。这些名称是模型的类别标识,不代表所有与隐私有关的内容都一定属于其中某类。
模型卡进一步说明,它使用 BIOES 边界标签:Begin、Inside、Outside、End、Single,分别描述一个片段的开始、内部、外部、结束和单 token 情形,并以受约束的序列解码提高边界连贯性。应用最终需要的是类似 {start, end, label} 的字符区间,才能把检测结果映射回文本或图片。
原文提到模型在 PII-Masking-300k 基准上的领先表现,具体数字与方法应查看 模型卡和官方发布说明。本文没有复现基准,不把论文或模型卡的结果当作这三个应用的端到端准确率。
一、Document Privacy Explorer:读文档时原位查看敏感片段
第一个应用面向合同、简历、导出的聊天记录等包含大量个人信息的文档。用户上传 PDF 或 DOCX 后,在接近普通阅读器的界面里看到原文,每一类检测到的敏感片段都有高亮;侧栏可以切换类别,顶部显示数量等统计。
原文的设计在输入未超过上下文窗口时,把提取出的整段文本交给模型一次处理,减少分块与拼接带来的边界问题,并让区间偏移直接对应后续渲染的文本。这里“一次处理”不意味着任何大小的文件都能输入,也不意味着 PDF 提取后的文本能完整保留原版式。
用 Gradio Blocks、gr.HighlightedText 和侧栏也能构造类似应用。作者选择自写阅读器,是因为他们希望使用衬线正文、只切换 CSS 类的类别过滤,以及无需整页重新渲染的统计面板。gr.Server 负责返回 HTML,并把计算函数接入队列。
import gradio as gr
from fastapi.responses import HTMLResponse
from gradio.data_classes import FileData

server = gr.Server()

@server.get("/", response_class=HTMLResponse)
async def homepage():
    return FRONTEND_HTML

@server.api(name="analyze_document")
def analyze_document(file: FileData) -> dict:
    text = extract_text(file["path"])
    source_text, spans = run_privacy_filter(text)
    return {
        "text": source_text,
        "spans": spans,
        "stats": compute_stats(source_text, spans),
}这是原文结构示例,extract_text 使用 PyMuPDF 或 python-docx 一类解析工具;run_privacy_filter 和 compute_stats 的具体实现不在片段中。FileData 的取值形式也必须按所固定的 Gradio 版本核对,不能仅凭注解推断它在任何版本都可以用字典下标读取。
这里关键的是 @server.api。在原文架构中,它让函数获得 Gradio 队列、进度事件和 SDK 调用能力,并与 ZeroGPU 的 @spaces.GPU 组合。简单地改成 @server.post,并不会自动继承同样的排队行为。实际并发数量仍须由所选版本及队列配置决定。
浏览器使用 Gradio JavaScript 客户端上传文件。原文页面的模块脚本等价于下面的代码;这里作为转义后的代码展示,文章本身不会执行它。
import { Client, handle_file } from
  "https://cdn.jsdelivr.net/npm/@gradio/client/dist/index.min.js";

const client = await Client.connect(window.location.origin);

async function uploadFile(file) {
  const result = await client.predict("/analyze_document", {
    file: handle_file(file)
  });
  renderResults(result.data[0]);
}
客户端取得文本、区间和统计后,可以在本地切换高亮,而不用每次过滤都重新推理。原文 CDN URL 没有固定版本;面向可复现部署时,应固定依赖并审查前端供应链。对于私密文档,字体、脚本等外部资源也应纳入部署的数据流审查。
二、Image Anonymizer:把字符区间变成遮挡矩形
截图中通常没有可以直接高亮的文本节点。第二个应用希望让用户上传聊天记录、收据或管理面板截图,在姓名、邮箱、账号等信息上盖黑条;用户还能按类别开关、拖动遮挡框,或者手动画框补上模型遗漏的区域,最后导出图片。
它的流程有两个坐标系。Tesseract 先做 OCR,返回每个词的文字和像素边界框;后端把词组合成一段文本,同时保存字符偏移到词框的映射。Privacy Filter 对完整 OCR 文本做一次检测;再把模型的字符区间查回相交的词框,按行合并成图片坐标中的矩形。
@server.api(name="anonymize_screenshot")
def anonymize_screenshot(image: FileData) -> dict:
    img = Image.open(image["path"]).convert("RGB")
    full_text, char_to_box = ocr_image(img)
    spans = run_privacy_filter(full_text)
    boxes = spans_to_pixel_boxes(spans, char_to_box)
    return {
        "image_data_url": pil_to_base64(img),
        "width": img.width,
        "height": img.height,
        "boxes": boxes,
    }
片段中的每个框概念上包含 x、y、w、h、label 与 text。前端仍用 client.predict("/anonymize_screenshot", { image: handle_file(file) }) 调用队列接口。
Gradio 的 gr.ImageEditor 已支持图层标注,原文认为它是合理起点。作者最终自写 canvas,是为了保留每个遮挡框的类别信息、一次切换某类全部框,并直接在浏览器中按图片原始分辨率导出 PNG。框的开关、拖动、补画和导出不再往返服务端。
编辑补充:“编辑不回传”不等于“原图没有上传”:后端 OCR 和检测已经接触原始图片。OCR 漏字、旋转、缩放或字符拼接差异都可能造成遮挡遗漏或错位。发布前必须检查导出的最终像素确实覆盖了目标内容,不能只看可隐藏的标注层。原始图片、OCR 文本和框内文字同样可能包含敏感信息,应限制日志、缓存和临时文件保留。
三、SmartRedact Paste:公开脱敏内容,私密链接保留原文
第三个应用类似一个先脱敏再分享的 pastebin。用户粘贴日志、邮件或支持工单,系统返回两个地址:公开地址展示用 <PRIVATE_PERSON>、<PRIVATE_EMAIL>、<ACCOUNT_NUMBER> 等占位符替换后的内容;带有秘密令牌的私密地址展示原文与高亮。
模型的任务没有改变:识别区间,再把这些区间替换为 <CATEGORY>。原文提到西班牙语、法语、中文、印地语等例子可以走相同调用流程,但相同接口不代表相同准确率。模型卡明确说主要语言为英语,在非英语、非拉丁文字和分布外领域可能退化。
应用需要同一条 paste 的公开和私密视图,还希望自定义 URL 的形状。gr.Server 底层是 FastAPI,所以排队 API 和普通 GET 路由可以放在同一进程里;原文也指出,使用 gr.Blocks() 配合 FastAPI 挂载自定义路由可以实现类似设计。
@server.api(name="create_paste")
def create_paste(text: str, ttl: str = "never") -> dict:
    source_text, spans = run_privacy_filter(text)
    redacted = redact(source_text, spans)
    pid = secrets.token_urlsafe(6)
    reveal_token = secrets.token_urlsafe(22)
    PASTES[pid] = Paste(
        pid, reveal_token, source_text, redacted, spans,
        expires_at=_ttl(ttl)
    )
    return {
        "view_path": f"/view/{pid}",
        "reveal_path": f"/view/{pid}?token={reveal_token}",
    }

@server.get("/view/{pid}", response_class=HTMLResponse)
async def view_paste(pid: str, token: str | None = None):
    p = _store_get(pid)
    if p is None:
        return HTMLResponse(_not_found(), status_code=404)
    revealed = bool(token) and secrets.compare_digest(
        token, p.reveal_token
    )
    return HTMLResponse(_render_view(p, revealed))
创建 paste 需要模型计算,浏览器调用 client.predict("/create_paste", { text, ttl });查看已有内容只是取出记录并渲染,不需要占用推理队列。secrets 用于生成随机值,compare_digest 用于比较令牌。私密 URL 是“持有即可访问”的凭据,不能把它误当成只凭用户身份才能打开的链接。
原文实现使用后台守护线程每 30 秒清理过期内容,全部服务与存储约为 200 行应用代码,数据保存在单进程内存中。这描述的是演示的简洁性,并非多进程、高可用或持久化能力。进程重启会影响内存数据;多 worker 部署需要明确共享存储、过期检查和一致性策略。
编辑补充:原文默认 ttl="never",不应直接作为敏感资料生产系统的保留策略。查询字符串里的令牌可能进入浏览历史、代理访问日志或链接转发,应配合 HTTPS、日志过滤、适当的缓存和 Referrer-Policy,以及可撤销的访问策略。服务端每次取值都应检查过期,而不能只依赖后台清理的周期。
四、让计算和普通路由各归其位
| 应用 | 排队计算接口 | 普通页面与查询路由 |
|---|---|---|
| Document Privacy Explorer | analyze_document:提取、检测、统计 |
GET /:阅读器页面 |
| Image Anonymizer | anonymize_screenshot:OCR、检测、区间到像素框 |
GET / 与 GET /examples/*:画布界面与预置例子 |
| SmartRedact Paste | create_paste:检测、替换、生成标识与令牌 |
GET /、GET /view/{pid}、GET /api/paste/{pid}:编辑页、查看页和 JSON 查询 |
这是原文设计表的完整分工:模型计算通过 @server.api 接入 Gradio;页面、文件查找和轻量字典读取使用普通 @server.get 或 @server.post。同一计算函数同时可供 JavaScript 的 @gradio/client 和 Python 的 gradio_client 调用,减少重复维护逻辑。
排队可以帮助管理有限 GPU 资源,并不自动提供认证、数据隔离、输入大小限制或持久存储。把这些边界独立写清楚,才能判断“可扩展”在自己的部署中具体意味着什么。
五、当前公开代码与博客片段的差异,以及静态审查发现
本文还静态阅读了三份 Space 的 app.py,没有执行模型或服务。当前文档应用的上传入口是普通 POST /api/analyze,另有队列接口 analyze_text;图像应用也同时存在普通 POST /api/detect 和队列接口。因此,不能把博客中的装饰器分工当作当前 Space 所有请求已经遵守的事实。
- 路径输入:当前图像应用的队列函数接收
image_path: str,然后直接Image.open(image_path)。函数内部没有展示上传目录约束。这是可触达本地图片路径的危险输入设计;能否经公开部署实际利用取决于外围配置,本文没有做利用测试。修订时应接收受控上传对象,并校验解析后的路径属于上传目录,不允许客户端任意指定服务器路径。 - 前端注入:当前文档应用把来自文本的 speaker 字符串直接插入
innerHTML;另一处把只处理文本节点的esc()结果插入带引号的data-text属性。文本转义不能自动覆盖属性上下文中的引号,因此应改用 DOM 属性 API 和textContent。这是静态识别出的不安全数据流,没有执行攻击载荷。 - 上传与资源:文档和图像的普通上传入口直接
await file.read()读入内容,函数内未见明确的上传字节上限;图像解码与 OCR 也需要像素量、时间及并发预算。外围服务可能另有限制,但源码片段本身不能证明已有这些保护。 - 输入长度与过期:当前 paste 源码已经包含默认 50,000 字符上限、TTL 选项校验和读取时过期检查,应保留这些已有保护;不过默认永不过期、原文存储以及查询参数令牌仍需按应用敏感性调整。
- 总存储预算:当前paste实现使用进程内的
PASTES字典,未见总条数或总字节上限;过期清理线程不会删除never条目。50,000字符只是单条上限,推理队列也不能防止反复创建内容使内存持续增长。部署前应设置总存储预算、有限的默认TTL、创建速率与用户配额,并明确达到上限时的拒绝或淘汰策略。外围网关是否已有相关限流,本次没有验证。 - 秘密与渲染:已检查的配置使用环境变量读取 Hugging Face 令牌,没有发现写死的实际令牌值。占位符、原文、模型区间和异常消息都应作为不可信数据处理。没有发现硬编码秘密不等于没有漏洞,也不等于完成了整个依赖栈的审计。
下面是针对“把不可信字符串塞进 HTML 属性”这一个问题的编辑修订示意,与原文用 HTML 字符串拼接的写法不同。它不构成三个应用的完整修复版:
const span = document.createElement("span");
span.className = "pii";
span.dataset.text = sourceText.slice(start, end);
span.textContent = sourceText.slice(start, end);
container.appendChild(span);
区间使用前仍须验证 0 <= start <= end <= text.length、排序和重叠规则;Python 字符索引与浏览器 UTF-16 索引在某些字符上并不等价,需要明确转换约定。OCR 的字符映射同样必须与实际送入模型的文本一致。以上是本次静态审核补充,不是性能或安全测试结论。
试用与进一步阅读
原文提供三个公开演示入口:Document Privacy Explorer、Image Anonymizer、SmartRedact Paste。公开演示的状态与实现可能变化;试用应使用合成或已获准公开的数据,不把真实秘密用于验证检测能力。
模型卡将 Privacy Filter 定位为数据最小化与脱敏辅助工具:标签政策固定,改变政策需要微调;漏检、误删和边界偏移都可能发生,医疗、法律、金融、人事等敏感场景需要额外评估与人工复核。原文展示的是将一个模型融入三种工作流的方法,最终的隐私保护取决于整条数据处理链。
归属与许可
文章作者和原始出处见文首。Privacy Filter 模型按 Apache License 2.0 提供,模型及其相关分发应保留适用许可证与通知;该模型许可不自动替代博客文章或其他依赖的许可。新增审核内容、版本差异和修订片段均已标明。配图为本次原创,不使用或伪造产品运行截图。










暂无评论内容