


原文:Meta’s AI Storage Blueprint at Scale;作者/维护方:Sidharth Bajaj、Venkatraghavan Srinivasan / Engineering at Meta。中文翻译与技术整理:未完纪。核验日期:2026-10-05。
模型能力和训练数据量不断增长,前沿模型发布间隔也从几个月缩短到几周。存储访问的可靠性和速度,因而同时影响 AI 创新的算力成本和迭代节奏。作者指出,AI 计算性能大约每两年增长至原来的三倍,存储和互连的进步却温和得多;存储瓶颈由此成为 GPU 等待的重要原因。
问题也不只在 GPU 利用率。计算资源分散在不同地区后,研究人员必须把庞大数据集移到可用 GPU 附近。本文介绍 Meta 如何围绕两个目标改造 BLOB 存储:提高 GPU 利用率,以及缩短研究人员等待数据的时间。
共同基础:区域块存储上的全局 BLOB 接口
Meta 运行着数百个 EB 级存储集群,服务 Facebook、Instagram、Reality Labs、Meta AI、广告、数据仓库和内部数据库。对象存储、文件系统和块设备接口之下,是可横向扩展的基础块层 Tectonic。
Tectonic 是区域级、多租户的存储基础设施:通过纠删码提供持久性与可用性,支持 HDD 与闪存之间的分层,并放置冷、温、热数据以提高各租户的 I/O 利用率。上层 BLOB 服务提供全局访问,并通过策略让用户在持久性与可用性之间选择。
此前的 “Training Llama: A Storage Perspective” @Scale 演讲介绍过在 Tectonic 上提供类似 NFS 的文件系统接口来训练 Llama。该方式仍在 Meta 广泛使用,但现代训练栈逐渐迁移到 BLOB 接口,以统一访问庞大数据湖并提高性能。
为什么必须关注最慢的读取
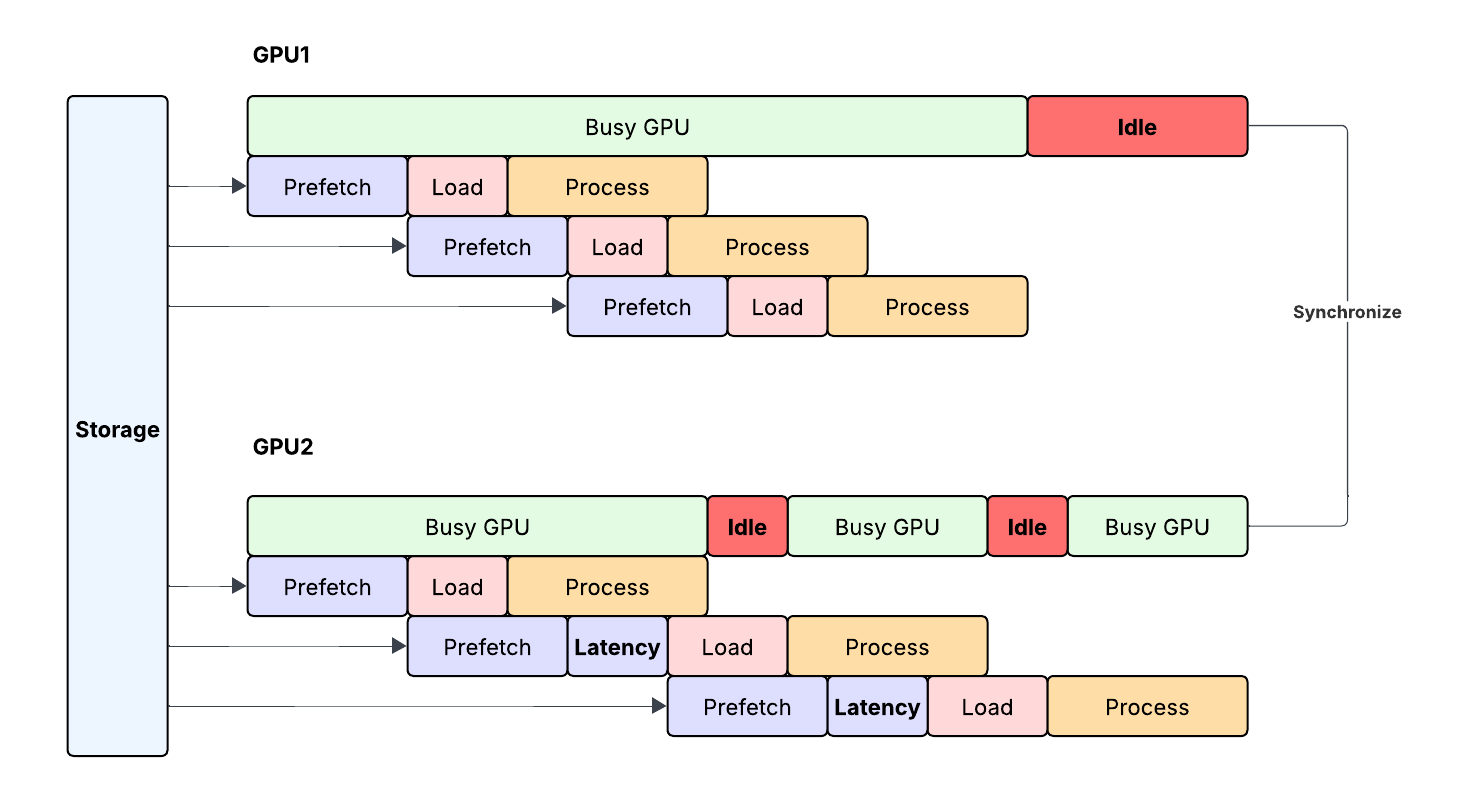
AI 负载会产生突发且持续的高吞吐请求、变化多样的 I/O 模式,同时要求延迟可预测,连最大观测延迟 pMax 也需要受到控制。训练时,大量 GPU 按批次遍历数据,并在若干步之后同步。一个 GPU 变慢,就会拖住整个同步步骤。
数据加载器通常在 GPU 计算当前批次时预取下一批,把计算和 I/O 重叠起来。如果读取在当前计算结束前完成,GPU 不必等待;一旦某次存储访问超出这个窗口,就会造成停顿。因此,只优化平均延迟不足以保护训练吞吐。
旧架构为什么不适合闪存上的 AI 负载
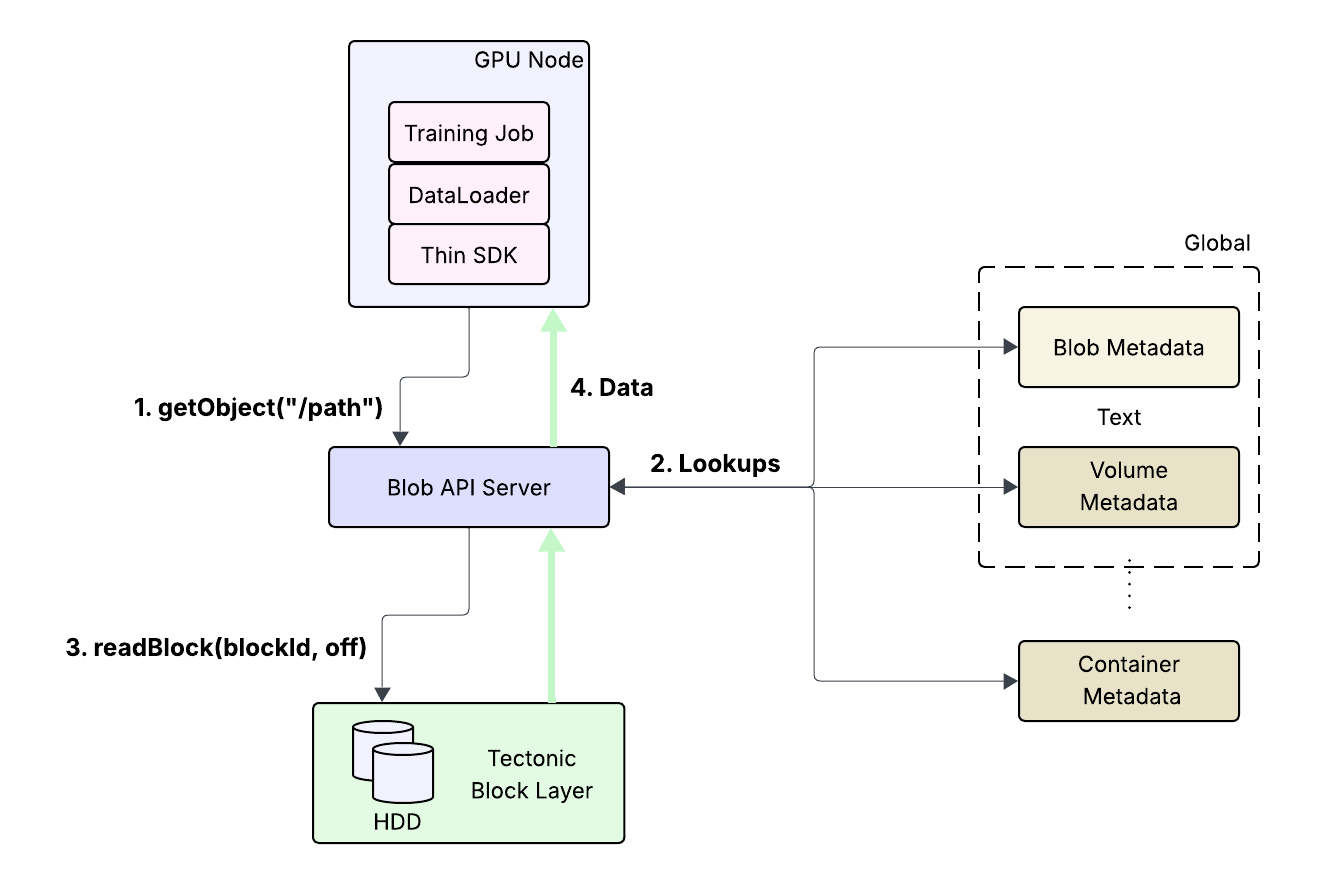
旧 BLOB 服务逐年叠加了多个有状态层,每层维护自己的元数据。一次 getObject("/bucket/path") 到达 API 服务器后,要穿过名称层、卷层和容器层等查询,最后把路径解析成一组 (blockId, offset, size)。部分查询还会跨区域,总延迟可能达到数百毫秒;其中任何一次慢响应都会延长整个请求。随后,API 服务器还要代理 Tectonic 到客户端的数据。
在全球 HDD 存储上,这些元数据开销未必显眼;当底层闪存已经能在毫秒量级提供数据时,上层开销便成了障碍。原有取舍也随之改变:
- 性能:传统应用对延迟的要求相对宽松,AI 更看重直到 pMax 的可预测性。
- 可靠性:原设计默认在全球复制数据和元数据,以应对区域故障。AI 同样要求高可用,但不再需要所有负载默认全球化。
- 成本:原栈围绕 HDD 的单位字节成本优化;AI 的 IOPS 需求推动闪存应用,相比 GPU 的计算成本,存储计算开销的重要性也发生变化。
- 电力:GPU 数据中心越来越受供电限制,每一千瓦存储功耗都与 GPU 可用功率形成取舍。
重建基础:统一元数据、直接读取、区域部署
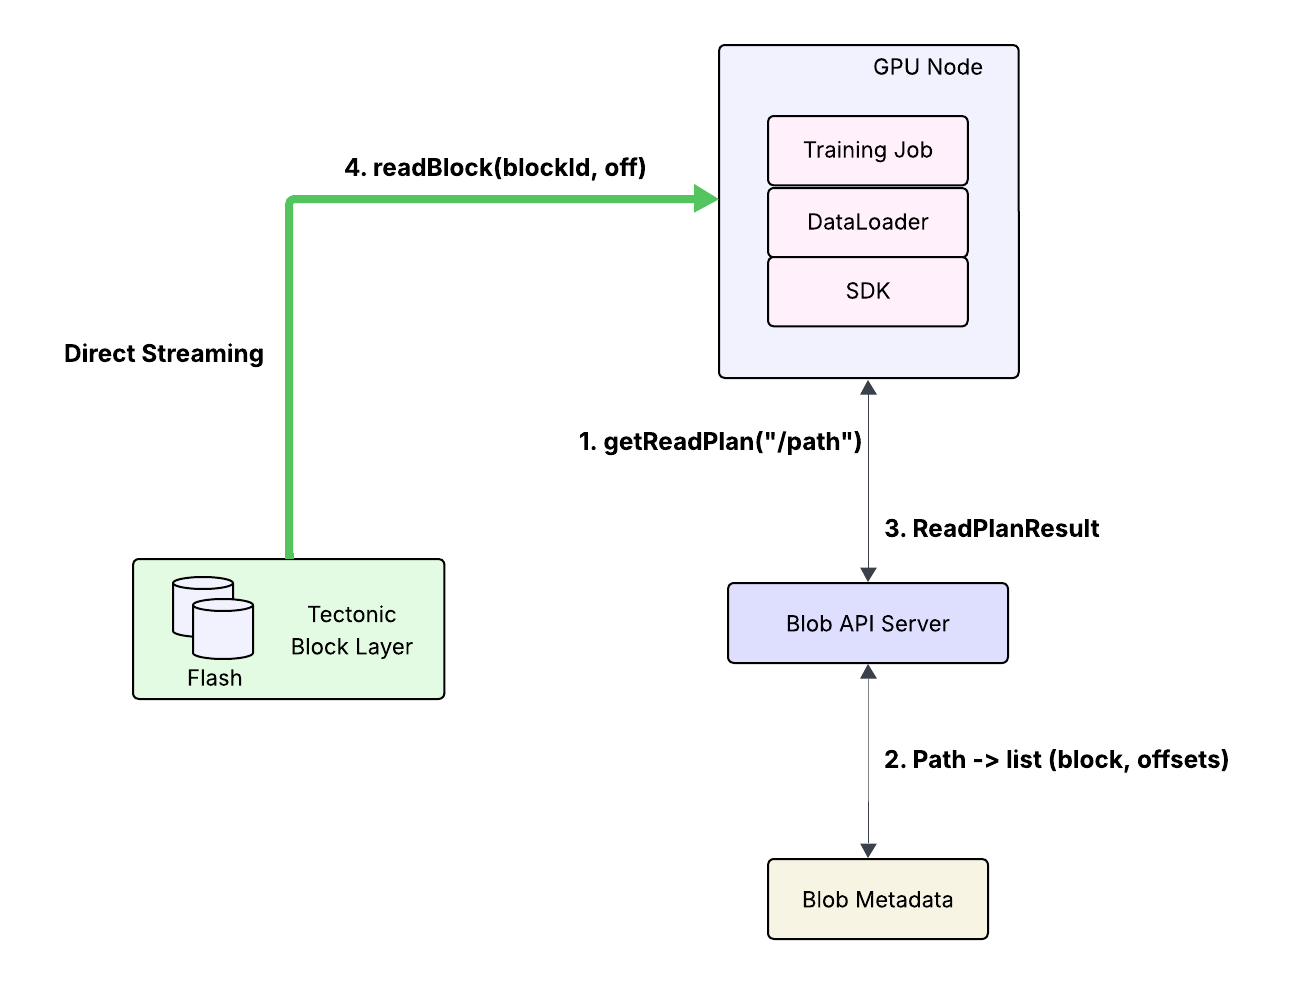
Meta 将散落于不同层的元数据合并成由 ZippyDB 支撑的统一扁平模式,为路径到存储地址提供常数复杂度的查询。与此同时,删除数据平面代理,把 Tectonic BlockClient 放入功能更完整的客户端 SDK。新的 BLOB 栈既可作为全局服务,也可在每个 AI 区域与 GPU 就近部署。
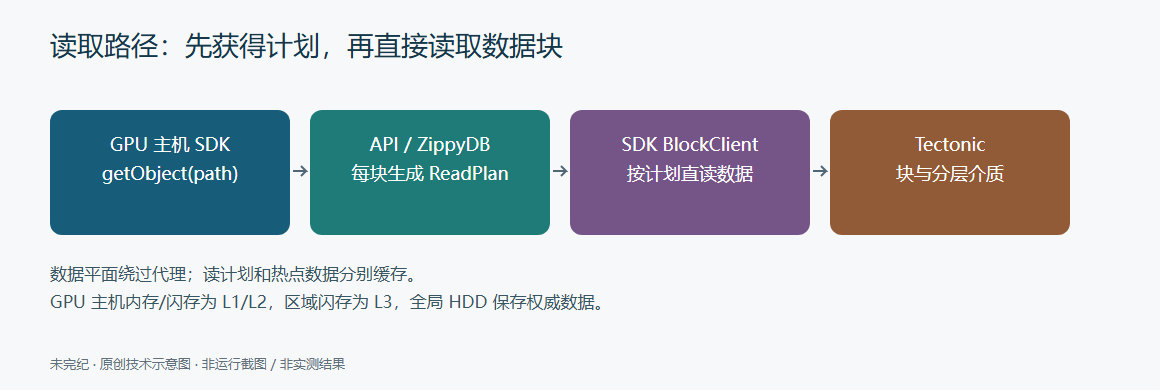
新路径中,SDK 收到 getObject 后先向 API 服务器发出 getReadPlan。服务器对每个数据块(chunk)查询新元数据,把对象路径映射成块地址元组并返回 ReadPlanResult。SDK 再直接从 Tectonic 流式读取字节。这里的 O(1) 是每个 chunk 的查询复杂度,并不是任意大小对象只需要一次元数据访问。
作者报告,这些改变达到了几乎不在 Tectonic 之上增加开销的目标,并通过去掉数据代理控制了电力占用。这是 Meta 对自身系统的结果描述,不能视为其他实现的性能保证。
用两类缓存吸收重启尖峰和热点
训练数据和检查点加载时,数百个 GPU 可能并发读取同一批内容;模型权重等子集尤其容易成为热点,GPU 重启则会引发集中流量。Meta 从现有 BLOB 系统中借用两类机制。
第一类是分布式数据缓存:使用 GPU 主机上的空闲内存,复用 Owl 子系统组件,将其对等节点直接集成到 BLOB 客户端 SDK,让数据访问经过缓存。第二类是读计划元数据缓存:把热门 BLOB 从路径到存储地址的映射存进类似 memcache 的分布式内存服务。
在作者观察到的生产负载中,数据缓存平均命中率约为 80%,读计划缓存的元数据访问延迟为 1–2 毫秒。这些机制吸收尖峰、减少底层 I/O、缓解元数据热点分片,并通过内存访问改善 p50 和 p99 延迟。命中率依赖数据复用、容量和负载分布,不能直接复制成容量规划指标。
协议上的最后一段优化
基础架构调整之外,团队继续排查整条链路的瓶颈。其中一个问题是慢存储节点拖长尾延迟,客户端采用 hedged reads,即对延迟过长的读取发出对冲请求,以减轻落后节点的影响。
另一个问题出现在检查点阶段:客户端可能瞬间产生很大的出站流量,引发拥塞、超时和重试,最终让 GPU 停顿。SDK 因此加入动态并发控制,根据应用层拥塞信号自动调节并行度。作者认为,综合这些优化后,存储栈已能支撑其 AI 负载,并在 Tectonic 之上保持极小附加开销。
研究速度:从每轮复制快照转向一次写入、按需获取
传统提交过程包含六步:研究人员整理和丰富数据并写入 BLOB;选择训练区域;提交摄入任务,把训练集快照转成适合 GPU 主机加载的格式并放到目标区域;等待可能持续数小时的摄入;提交训练并监控;分析输出、调整数据,再从摄入开始下一轮。
先复制快照让数据与 GPU 同处一地,对持续数周或数月的大型训练非常合理。但多数研究任务小得多,研究人员愿意接受偶尔的性能下降,以换取更快试验。他们需要的是只摄入一次,就能在任意可用区域访问数据。
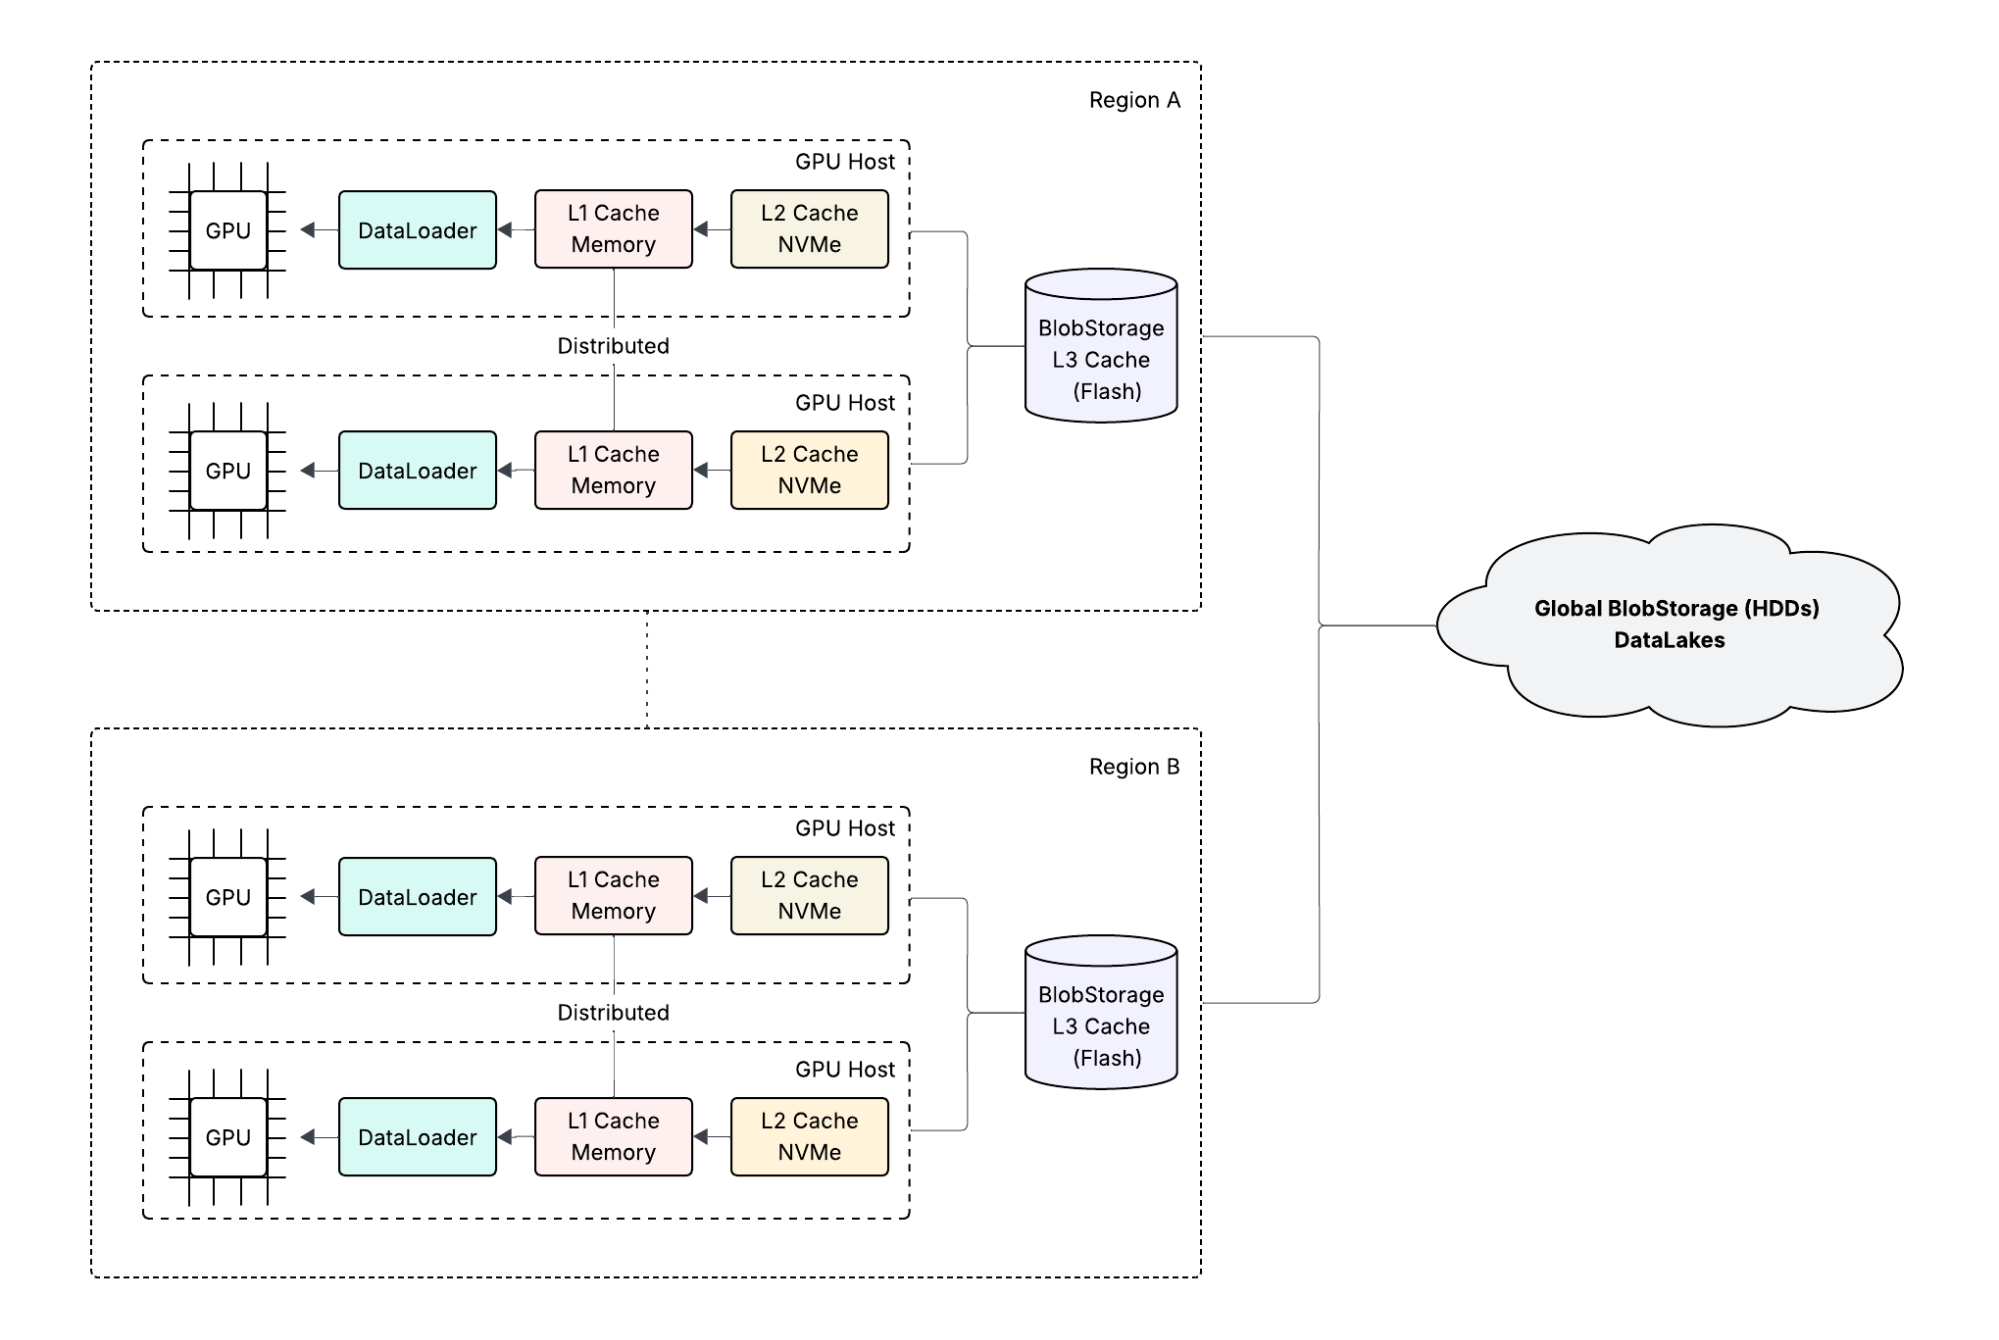
“写一次、读多次”的数据特征启发了新的方案:把全球存储想成一台行星级计算机的磁盘,借鉴操作系统在内存页缓存及 CPU 多级缓存之间按需调入数据的方式。GPU 主机内存和闪存分别成为 L1、L2 缓存,区域级、闪存支持的 BLOB 层成为 L3,全局 HDD BLOB 存储保留权威数据。加载器继续使用熟悉的 BLOB SDK。
三种机制隐藏跨区读取延迟
- 加载器预取:处理当前批次时,把下一批数据读入内存;在 SDK 看来,这表现为正常读取。
- 深度预取:SDK 显式提供
prefetch(),加载器在后台提前告知未来几分钟需要的数据,将远端数据调入本地区域 L3,并预热元数据缓存。 - 自动生命周期:数据通常在区域闪存层保留一段可配置时间,以便多个 epoch 复用;系统支持 TTL、LRU 等淘汰策略,并考虑容量和配额。
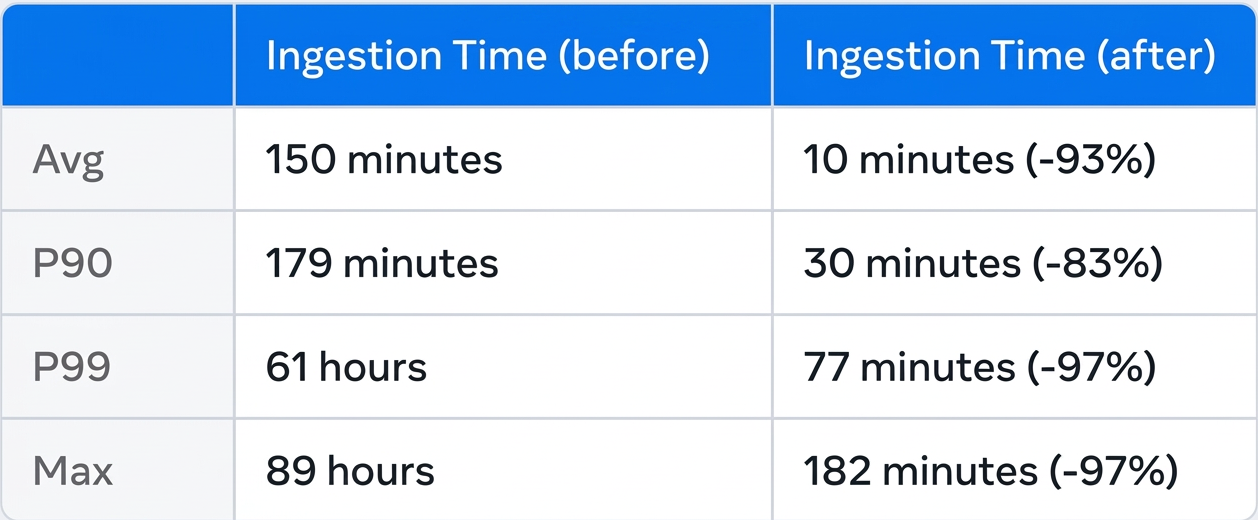
作者报告,新模式上线后很快得到采用,原有快照摄入和新模式目前仍同时存在。原文图 5比较了推广前后的摄入耗时;本文没有从图中推断精确倍数,也没有独立复现实验。需要稳定、充分预热吞吐的大任务,仍应按自己的负载选择工作流。
摄入耗时原图数据
原图列出的推广前后数据如下,均为 Meta 作者报告的工作负载统计,未由本文复现:
| 统计量 | 推广前 | 推广后 | 原图标注降幅 |
|---|---|---|---|
| 平均 | 150 分钟 | 10 分钟 | 93% |
| P90 | 179 分钟 | 30 分钟 | 83% |
| P99 | 61 小时 | 77 分钟 | 97% |
| 最大值 | 89 小时 | 182 分钟 | 97% |
译注:按图中 P99 的显示值计算,降幅约为 97.9%,与原图标注的 97% 有差别;原文未说明取整口径,因此保留原图数字并标注差异,不把它换成另一组实验结果。
仍在演进的方向
这次重构同时回应了两种等待:GPU 等数据,以及研究人员等跨区摄入。扁平元数据和客户端直读缩短请求路径,分层缓存与预取则让数据更接近计算资源。
Meta 接下来关注的方向包括:把存储扩展到网络极限,在更大规模下实现不阻塞 GPU 的检查点,以及推理负载带来的新挑战。Tectonic、ZippyDB、Owl 与相关 SDK 是文中内部基础设施;这篇文章提供的是设计思路,不能当作可直接部署的开源方案。
来源、版本与使用说明
本文依据 2026 年 7 月 1 日原文全文翻译整理,保留 Sidharth Bajaj、Venkatraghavan Srinivasan 作者归属与 © 2026 Meta 版权说明。配图包括 Meta 原文图 1 至图 5,以及未完纪原创技术示意图。术语和观察数字未被包装为编辑测试结果。本文无待执行脚本,未连接任何存储或 GPU 系统。











暂无评论内容